Qu'est-ce qu'un format de table ouvert
|
10
minute de lecture

Vous êtes probablement ici parce que votre lac ressemble déjà à une table dans un outil, mais se comporte comme un tas de fichiers dans un autre.
Un tableau de bord financier change après coup. Une reprise corrige une requête et en casse une autre. Les écritures Spark réussissent, Trino lit des données périmées, et personne ne peut répondre à une question basique : quelle version de ce jeu de données est la bonne ? C'est le moment où l'on cesse de demander « quel format de fichier utiliser ? » pour demander ce qu'est réellement un format de table ouvert.
La réponse courte est simple. Un format de table ouvert est la couche de métadonnées qui fait que le stockage objet se comporte comme une table de base de données. La réponse longue compte davantage, car le format n'est que la moitié de l'histoire. L'autre moitié, c'est la façon dont votre équipe l'exploite : compaction, contrôle du schéma, catalogues et observabilité.
Sommaire
Le moment où un lac de données cesse d'être fiable
Une défaillance classique commence.
La finance vérifie le rapport de chiffre d'affaires de la veille et constate qu'il ne correspond plus au tableau de bord. Aucune pipeline n'est au rouge. Aucun orchestrateur ne signale de tâche en échec. Les fichiers sont toujours dans le stockage objet. Mais quelque part entre un append en streaming et un job de maintenance, les lecteurs ont capté une vue partielle de la table.
Pourquoi le stockage brut casse de façon subtile
Le stockage objet est très bon pour conserver des fichiers. Il n'est pas, à lui seul, un système de tables.
Si vous stockez des fichiers Parquet dans un dossier et appelez ce dossier revenue, vous n'avez toujours pas répondu aux questions qui intéressent les analystes :
Quels fichiers appartiennent à la table en ce moment
Quelle écriture a produit la version actuelle
Quel schéma un lecteur doit-il utiliser
À quoi ressemblait la table la semaine dernière
Quels fichiers une requête peut ignorer sans risque
Sans cette couche de métadonnées, chaque moteur doit déduire l'état à partir des listings de répertoires et des noms de fichiers. Cela marche un temps. Puis quelqu'un réécrit des partitions, compacte des fichiers ou change le type d'une colonne, et les lecteurs commencent à voir des vérités différentes depuis le même chemin de stockage.
Des fichiers bruts peuvent stocker les données correctement et produire malgré tout une analytique peu fiable.
La couche manquante
Un format de table ouvert ajoute, à côté des données, le relevé manquant de l'état de la table. Au lieu de traiter le stockage comme « les fichiers qui se trouvent sous ce préfixe », il enregistre une vue gouvernée de la table : fichiers actuels, instantanés historiques, schéma et métadonnées de disposition.
C'est pourquoi les équipes qui investissent dans la supervision du data lake découvrent souvent le même motif. Le problème n'est généralement pas seulement une écriture défectueuse. C'est que la plateforme n'a pas de moyen fiable de décrire l'état de la table entre lecteurs et écrivains.
La différence paraît minime jusqu'à votre première incohérence silencieuse. Après, elle devient fondamentale.
Ce que fait réellement un format de table ouvert
Une nouvelle pipeline dépose des fichiers de remplacement pour revenue. Le job Spark se termine. Une analyste rafraîchit un tableau de bord dans Trino. Un job de features de machine learning lit la même table via un autre moteur. Les trois requêtes visent le même chemin de stockage, mais ne voient pas toujours la même réponse.
C'est cet écart qu'un format de table ouvert est conçu pour combler.
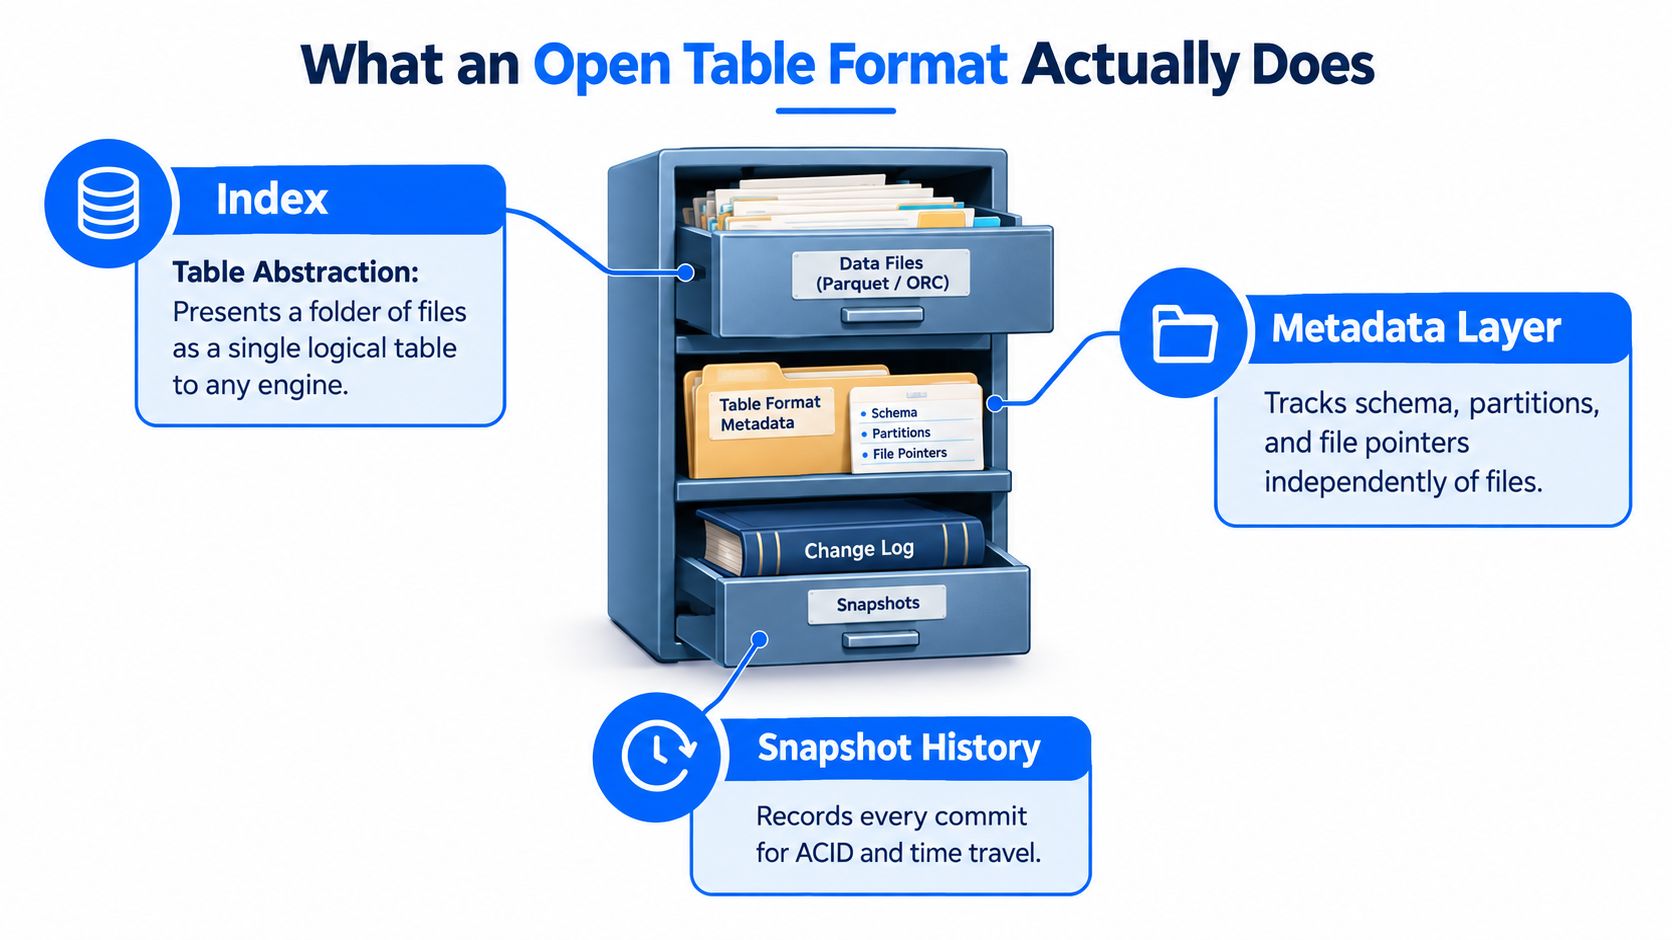
Il se place au-dessus des fichiers et définit l'état de la table
On confond souvent formats de table ouverts et formats de fichiers parce que les deux apparaissent dans le même bucket. Ils résolvent des problèmes différents.
Parquet, ORC et Avro définissent comment un fichier stocke lignes et colonnes. Un format de table ouvert définit comment un ensemble de fichiers devient une table logique que plusieurs moteurs peuvent lire et écrire sans risque. Databricks décrit les formats de table ouverts comme une couche de métadonnées au-dessus de Parquet, ORC ou Avro dans le stockage objet, qui ajoute des fonctions de table telles que les transactions ACID, l'évolution du schéma et le voyage dans le temps, dans son panorama des formats de table ouverts.
Si la distinction reste floue, ce guide sur ce qu'est Parquet et comment il stocke des données en colonnes aide. Parquet répond à « comment ce fichier est-il encodé ? ». Un format de table répond à « quels fichiers composent la table, et à quelle version les lecteurs doivent-ils se fier ? ».
Le format agit comme le plan de contrôle de la table
Un modèle mental utile est un historique Git pour fichiers de données, avec des règles plus strictes sur la concurrence et le schéma. Le format de table tient le registre de l'état actuel et du chemin qui l'a produit. Les moteurs de requête n'ont pas à parcourir des dossiers en devinant. Ils lisent les métadonnées de la table et obtiennent une réponse exacte.
En pratique, cette couche de métadonnées assure quatre rôles.
Déclarer l'appartenance des fichiers
Le format enregistre quels fichiers appartiennent à la table maintenant. Si la compaction réécrit dix petits fichiers en un plus gros, les lecteurs suivent le pointeur de métadonnées vers l'ensemble valide au lieu de mêler ancien et nouveau.Publier les instantanés de façon atomique
Une écriture devient visible sous forme de nouvel instantané validé. Les lecteurs voient l'ancienne version ou la nouvelle, jamais un état intermédiaire où la moitié des fichiers a changé.Suivre le schéma comme métadonnée de table
Noms de colonnes, types, identifiants de champs et changements autorisés vivent dans la définition de la table, pas seulement dans ce qu'un écrivain a émis. Cela compte dès que plusieurs moteurs renomment des colonnes, élargissent des types ou ajoutent des champs imbriqués.Stocker les métadonnées de disposition et d'élagage
Valeurs de partition, statistiques de fichiers et parfois métadonnées de suppression aident les moteurs à écarter des fichiers inutiles et à planifier efficacement les requêtes.
La couche opérationnelle est ce que les équipes sous-estiment le plus
La liste de fonctionnalités est la partie facile. C'est dans le modèle d'exploitation que les formats de table ouverts gagnent leur place.
Dès qu'un format détient l'état de la table, votre équipe doit décider qui gère la compaction, qui approuve les changements de schéma et quel catalogue fait autorité. Ce sont des questions de production, pas de brochure. Si personne ne gère la compaction, les petits fichiers s'accumulent et les performances dérivent. Si tout écrivain peut changer le schéma librement, un mauvais déploiement casse les lecteurs en aval. Si Spark utilise une vue de catalogue et Trino une autre, vous revenez à plusieurs vérités avec un meilleur habillage.
Le format fournit les mécanismes. Votre équipe plateforme a toujours besoin de règles.
Pourquoi ce changement compte au quotidien
Sans format de table, écrire des données signifie souvent « des fichiers ont été déposés ». Avec un format de table, écrire des données signifie « une nouvelle version de la table a été validée et publiée ».
C'est un contrat plus fort pour chaque système en aval. Jobs batch, requêtes BI et lecteurs en streaming peuvent s'accorder sur l'état de la table. Les moteurs peuvent interopérer via des métadonnées partagées plutôt que par des conventions de chemin. Les data engineers peuvent raisonner sur la maintenance, comme la compaction ou l'évolution des partitions, sans traiter chaque réécriture comme une panne potentielle.
Un format de table ouvert est donc la couche qui transforme le stockage objet en un système de tables que l'on peut exploiter avec confiance. Le format de fichier compte toujours. Le gain caché est que les métadonnées donnent à votre équipe un moyen maîtrisé de garder l'état de la table cohérent à mesure que se multiplient écritures, schémas et moteurs.
Comment le format a évolué de Hive au lakehouse
L'histoire compte car chaque format a été créé pour corriger une douleur précise, pas pour remporter une matrice de fonctionnalités.
Une chronologie utile tirée de l'histoire et l'évolution des formats de table ouverts situe Apache Hive en 2008, Apache Hudi en 2016, Apache Iceberg en 2017 et Delta Lake entre 2017 et 2019. Cette séquence montre la rapidité avec laquelle la couche table du lakehouse a mûri dès que les équipes ont buté sur les limites des premiers schémas de data lake.

Hive a résolu le problème d'une époque
Hive a donné aux premières équipes Hadoop un moyen de traiter des fichiers HDFS comme des tables. Son modèle de partition reposait fortement sur la structure de répertoires. Cela collait aux hypothèses de l'époque.
Ces hypothèses ont mal vieilli dans le stockage objet cloud. Le partitionnement par répertoires est devenu fragile. Les comportements de listage et de renommage ne ressemblaient plus à HDFS. Les tables de longue durée sont devenues pénibles quand les stratégies de partition changeaient.
La vague suivante a corrigé des défaillances concrètes
Chaque format plus récent répondait à une faiblesse opérationnelle différente.
Apache Hudi est apparu en 2016 pour prendre en charge des charges exigeant des upserts au niveau de l'enregistrement et un traitement incrémental dans les environnements de data lake.
Apache Iceberg est arrivé en 2017 pour traiter les problèmes de grandes tables analytiques, de passage à l'échelle des métadonnées et d'évolution des partitions.
Delta Lake a pris forme entre 2017 et 2019 comme une voie fondée sur un journal de transactions pour apporter un comportement ACID fiable au stockage ouvert.
À ce stade, le secteur était passé de « comment mettre des fichiers dans un lac ? » à « comment plusieurs moteurs partagent-ils des tables dignes de confiance sur du stockage bon marché ? ».
Le nom lakehouse est venu après le virage technique
Le virage architectural est venu d'abord. L'étiquette lakehouse a suivi.
Si vous voulez le contexte plus large de la pile autour des formats, catalogues, moteurs et gouvernance, ce guide sur ce qu'est un lakehouse et comment maintenir la qualité des données donne la vue d'ensemble. Le point important ici est plus étroit : les formats de table ouverts sont devenus la couche qui a rendu les promesses du lakehouse techniquement crédibles.
Vers 2025 et 2026, cette couche avait encore mûri. La même chronologie note que la spécification v3 des tables Iceberg a été ratifiée en 2025, et qu'Iceberg 1.10 et 1.11 ont apporté un support stable de fonctionnalités telles que les vecteurs de suppression, les types variant, les types géospatiaux et les horodatages à la nanoseconde dans cette phase plus tardive de l'évolution du format.
Iceberg, Delta Lake et Hudi comparés
Un choix de format paraît simple pendant l'évaluation. Puis la production démarre, un job de streaming prend du retard, les petits fichiers s'accumulent, deux moteurs divergent sur les changements de schéma, et la question surgit : qui gère la maintenance de la table, et à quel point ce travail est-il prévisible ?
Apache Iceberg, Delta Lake et Apache Hudi sont tous des formats de table éprouvés en production. La comparaison utile n'est pas la parité fonctionnelle. C'est la façon dont chaque format organise les métadonnées, coordonne les écritures et attribue la responsabilité des corvées opérationnelles comme la compaction, le nettoyage et la compatibilité entre moteurs.
La plus grande différence est l'architecture des métadonnées
Les fichiers de données peuvent tous se trouver dans le stockage objet, mais chaque format tient le « sommaire » de la table différemment. Le panorama de Dremio sur l'architecture d'Iceberg, Delta Lake et Hudi est un bon repère :
Delta Lake consigne les changements de table dans un journal de transactions séquentiel sous
_delta_log.Iceberg suit l'état de la table via des métadonnées d'instantané et des fichiers manifestes décrivant quels fichiers de données appartiennent à chaque version.
Hudi tient une chronologie d'actions, incluant les commits et les opérations de maintenance comme la compaction, le clustering et le nettoyage.
Ce choix de conception influe sur plus que les performances de lecture. Il change la vitesse de croissance des métadonnées, la sûreté des écritures multi-moteurs, la gestion des changements de partition et la quantité de soins réguliers que la table réclame à votre équipe.
Iceberg, Delta Lake et Hudi en un coup d'œil
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Conception des métadonnées | Métadonnées d'instantané avec listes de manifestes et manifestes | Journal de transactions séquentiel dans | Chronologie d'instants immuables couvrant écritures et services de table |
Modèle de partitionnement | Partitionnement caché et évolution des partitions, de sorte que le schéma logique de partition peut changer sans réécrire les anciens fichiers | Le comportement de partition est géré via l'état de table suivi par le journal et les conventions d'écriture | Conçu autour de dispositions à forte ingestion, avec des services qui réorganisent les fichiers au fil du temps |
Style de concurrence | Modèle d'isolation par instantanés centré sur les versions de table et l'échange de métadonnées | Protocole de commit fondé sur le journal, avec des schémas de concurrence optimiste | Protocole de commit fondé sur la chronologie, souvent associé à des services d'arrière-plan |
Meilleure adéquation | Tables analytiques partagées entre plusieurs moteurs | Plateformes centrées sur Spark, surtout là où l'outillage natif Delta fait partie du quotidien | Upserts fréquents, capture de changements et traitement incrémental |
Principal arbitrage | Forte interopérabilité, mais la discipline de catalogue compte et les règles d'écriture multi-moteurs doivent être explicites | Les schémas d'exploitation sont souvent les plus simples là où Spark et l'outillage compatible Delta font référence | La souplesse d'écriture est forte, mais compaction et clustering exigent une planification et des responsables actifs |
Posture d'interopérabilité | Large prise en charge par les moteurs et catalogues. La spécification Apache Iceberg explique pourquoi beaucoup d'équipes y voient l'option de table partagée la plus neutre | Fort héritage Spark, avec une compatibilité croissante dans l'écosystème élargi | L'interopérabilité s'est améliorée, mais les hypothèses d'exploitation restent plus orientées ingestion que neutres vis-à-vis du moteur |
Une meilleure grille de décision : qui exploitera la table
Si une équipe ne compare que des cases à cocher, les trois semblent proches. En pratique, ils créent des astreintes différentes.
Iceberg convient souvent aux organisations qui veulent qu'une table soit lue par plusieurs moteurs et gouvernée via une couche de catalogue. L'avantage est la portabilité. Le prix est la discipline. Changements de schéma, ordre de tri, dimensionnement des fichiers, rétention des instantanés et cohérence du catalogue exigent des responsables clairs, surtout dès que plusieurs moteurs peuvent écrire.
Delta Lake convient souvent aux plateformes déjà centrées sur des flux Spark et un outillage compatible Delta. Le chemin opérationnel peut être direct car le modèle transactionnel et les outils sont étroitement alignés. La contrepartie est que la stratégie d'interopérabilité pèse davantage avec le temps si la plateforme dépasse ses hypothèses de moteur d'origine.
Hudi convient souvent aux systèmes à forte ingestion où les mises à jour au niveau enregistrement et la consommation incrémentale font partie de la conception. Cette force s'accompagne de services de table plus visibles. Compaction, clustering et nettoyage ne sont pas des détails. Quelqu'un doit les planifier, les surveiller et décider quand la latence d'écriture prime sur la disposition de lecture.
C'est aussi là que le travail de fiabilité cesse d'être distinct du travail de qualité. Un job de compaction tardif, un changement de schéma non revu ou un moteur écrivant avec les mauvais réglages de catalogue peuvent créer des incidents que les analystes vivent comme de « mauvaises données ». Les équipes sur plateformes Spark évaluent souvent le choix de format en même temps que les pratiques de gestion de la qualité des données sur Databricks, car l'exactitude de la table et les contrôles qualité se rejoignent dans le même flux de production.
Le mauvais format échoue rarement pendant une démo. Il échoue pendant la tâche de maintenance dont votre équipe supposait qu'elle se réglerait toute seule.
ACID, voyage dans le temps et évolution du schéma expliqués
Un format de table devient concret la première fois que quelque chose tourne mal en production. Une pipeline écrit la moitié de ses fichiers, échoue sur le reste, et une analyste rafraîchit un tableau de bord précisément au mauvais moment. Sans contrôle transactionnel, le lac expose ce désordre directement. Avec un format de table ouvert, les lecteurs continuent de voir le dernier état valide jusqu'à ce que le nouveau soit pleinement validé.
ACID signifie que la table a un point de commit net
Le bénéfice pratique d'ACID dans un lakehouse est simple. Les lecteurs ne voient pas de travail à moitié fait.
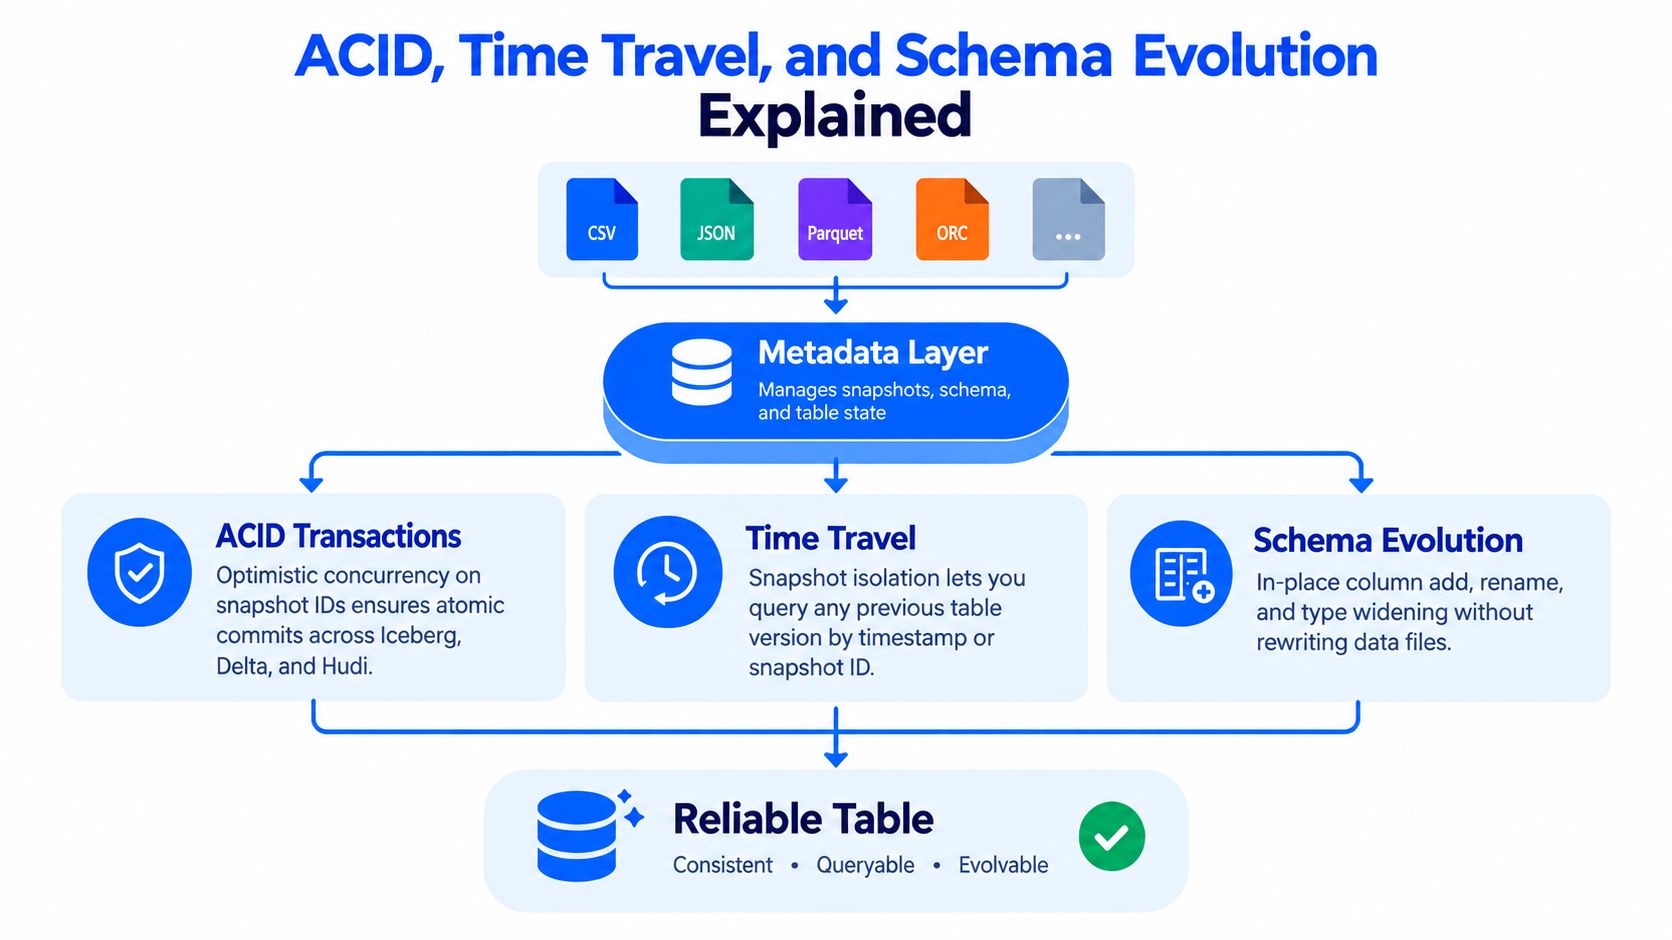
Sous le capot, ces formats publient les changements via des commits de métadonnées. Les fichiers de données peuvent déjà exister dans le stockage objet, mais ils ne font partie de la table qu'une fois la nouvelle version de métadonnées acceptée. Cela vous donne le comportement que les équipes attendent d'une base de données, alors que le stockage sous-jacent reste des fichiers dans un lac.
Concrètement, cela signifie :
un job batch peut publier un rafraîchissement complet comme un seul commit atomique
un job de streaming peut continuer à ajouter pendant que les lecteurs restent sur un instantané cohérent
une écriture échouée peut laisser des fichiers orphelins, mais ne devient pas la vérité de la table
les écrivains concurrents ont besoin de règles de conflit, de logique de reprise et de coordination de catalogue pour ne pas se gêner
Ce dernier point est facile à sous-estimer. ACID n'est pas seulement une fonctionnalité pour lecteurs. C'est aussi un mécanisme de contrôle pour plusieurs écrivains, et les détails opérationnels varient selon le format, le moteur et la configuration du catalogue.
Le voyage dans le temps sert à déboguer et reproduire des états de données
Le voyage dans le temps signifie que la table peut exposer des versions validées plus anciennes, pas seulement l'actuelle. Cela ressemble à un confort jusqu'à ce qu'un rapport change après une reprise, ou qu'un job de suppression retire plus d'enregistrements que prévu.
Si vous avez travaillé avec des données historiques dans Snowflake, le modèle mental est proche. Vous interrogez un état antérieur de la table au lieu de restaurer des fichiers bruts depuis une sauvegarde.
La bonne question n'est pas « le format prend-il en charge le voyage dans le temps ? ». C'est « combien de temps gardons-nous l'historique, qui contrôle la rétention, et que se passe-t-il quand le nettoyage du stockage s'exécute ? ». Les équipes célèbrent souvent les lectures historiques pendant l'évaluation, puis découvrent plus tard qu'une expiration agressive des instantanés a supprimé précisément la version nécessaire à un audit ou à une revue d'incident.
Le voyage dans le temps n'est fiable que dans la mesure de la politique de rétention qui le soutient.
L'évolution du schéma sépare le changement maîtrisé de la casse accidentelle
L'évolution du schéma permet à une table de changer de forme avec le temps sans imposer la réécriture de chaque ancien fichier. Cela inclut généralement l'ajout de colonnes nullables, certaines promotions de types et, dans certains formats, le renommage de colonnes via une identité de champ stable plutôt que la position brute.
La fonctionnalité semble permissive. L'usage en production devrait être l'inverse.
Un processus sûr de changement de schéma répond à quelques questions précises :
Qui peut approuver un changement de schéma en production
Quels moteurs sont autorisés à écrire ce nouveau schéma
Si les lecteurs en aval savent gérer le changement
Comment les changements de partition affectent les jobs et hypothèses existants
Si le catalogue interprétera le nouveau schéma de la même façon dans tous les outils
C'est là que les équipes gagnent en souplesse ou se créent un long travail de nettoyage. Un renommage de colonne peut être valide au niveau du format et casser malgré tout des extractions BI, des modèles dbt ou du code d'ingestion qui référençaient l'ancien nom. Un élargissement de type peut passer la validation d'écriture et modifier quand même le comportement des jointures ou la gestion des valeurs nulles en aval.
L'évolution du schéma est une capacité du format. La gouvernance du schéma est une décision d'exploitation.
Le même motif vaut pour ACID et le voyage dans le temps. Le format fournit le mécanisme. La fiabilité vient de la responsabilité : qui approuve les changements, qui règle la rétention, qui nettoie les fichiers et qui décide à quels moteurs on fait confiance pour écrire.
La vraie question après l'adoption
Un lakehouse paraît généralement en bonne santé juste après la première écriture réussie. Les requêtes tournent. Le voyage dans le temps fonctionne. Chacun coche la liste de fonctionnalités et passe à autre chose.
Puis les questions d'exploitation commencent. Quel catalogue fait autorité. Quels moteurs ont le droit d'écrire. Qui exécute la compaction. Qui approuve les changements de schéma techniquement valides mais risqués pour les jobs en aval. Ces décisions façonnent la fiabilité quotidienne bien plus que le seul choix du format de fichier.
Le catalogue fixe le code de la route
Un format de table ouvert définit comment métadonnées et fichiers de données s'assemblent. Le catalogue décide comment les systèmes trouvent la table, coordonnent les changements et appliquent les politiques. En pratique, le catalogue fait office de contrôle aérien du lakehouse. Les avions peuvent tous être bien construits, il faut quand même un point qui coordonne décollages, atterrissages et changements de route.
Le panorama d'Uplatz sur la convergence et la divergence des formats de table ouverts souligne le rôle croissant des projets de traduction et d'interopérabilité tels qu'Apache XTable, la sortie Iceberg native de Hudi et Delta Lake UniForm. Il relève aussi une réalité de production que les comparatifs de formats manquent. Beaucoup d'entreprises exploitent plus d'un format, et l'interopérabilité dépend encore fortement du support des moteurs, du comportement du catalogue et des contraintes propres au cloud.
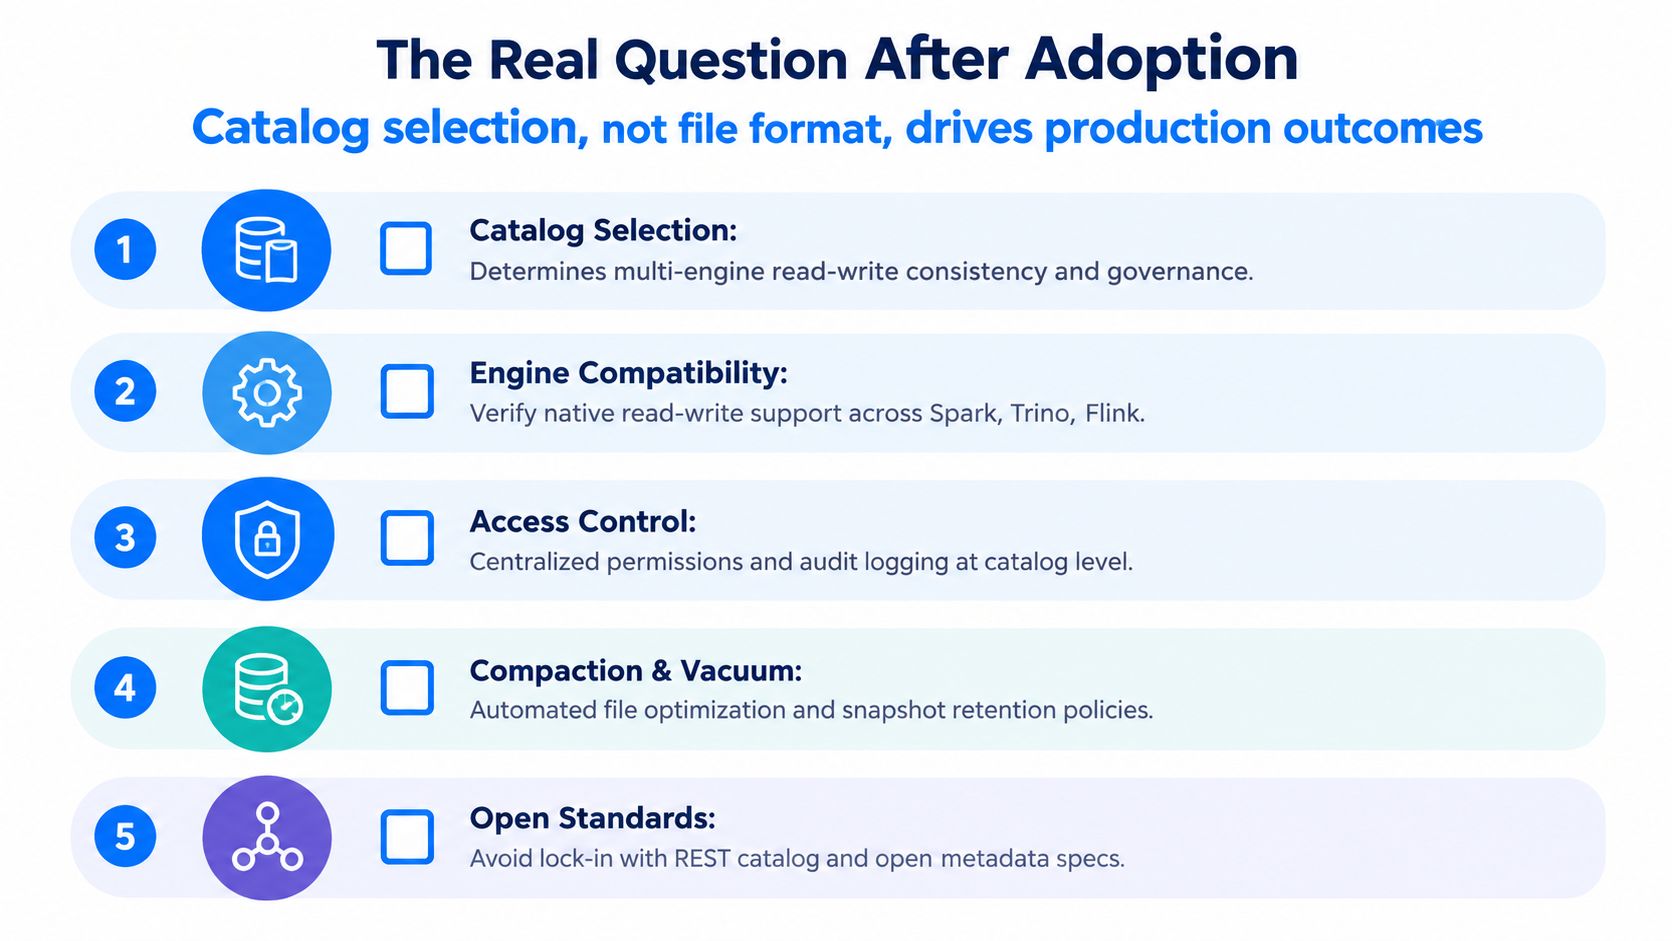
Voilà pourquoi une même table Iceberg, Delta Lake ou Hudi peut sembler prévisible dans un montage et fragile dans un autre. Un catalogue REST, Glue, Hive Metastore, Nessie, Polaris ou un plan de contrôle géré par un éditeur diffèrent sur la découverte, les permissions, les modèles de branches, la coordination des écritures et la gestion des pannes.
La responsabilité de la compaction devient un modèle d'exploitation
La compaction ressemble à de la maintenance d'arrière-plan. En production, elle tient plutôt du ramasse-miettes mêlé au réglage d'index. Bien faite, elle garde la planification des requêtes saine et les performances de lecture stables. Mal faite, elle consomme du temps de cluster, entre en conflit avec l'ingestion et crée du nettoyage après des réécritures ratées.
Quelqu'un doit prendre en charge :
La cadence de compaction
Les choix de tri et de clustering
Le nettoyage et la rétention des instantanés
Les étapes de retour arrière quand la maintenance aggrave les choses
La détection des fichiers orphelins
Ce ne sont pas des cases à cocher du format. Ce sont des travaux récurrents avec des modes de défaillance, des arbitrages de coût et un besoin net de responsables. Une revue franche chez Shirokoff sur les formats de table ouverts le dit directement en pointant la surcharge de métadonnées, le travail de maintenance, le coût de la courbe d'apprentissage et une gouvernance inégale selon les outils.
La fiabilité dépend de qui contrôle le changement
Les équipes de production apprennent aussi que la gouvernance vit rarement dans les seuls fichiers de la table. Le masquage de colonnes, les contrôles au niveau ligne, les pistes d'audit et l'étiquetage PII dépendent généralement du catalogue et des moteurs de requête qui les appliquent de façon cohérente.
Les équipes qui gardent ces tables fiables surveillent la couche de métadonnées comme un plan de contrôle applicatif. Elles suivent l'âge des instantanés, les commits en échec, le nombre de fichiers, les fichiers orphelins, le retard de maintenance et quel écrivain a modifié l'état de la table en dernier. Celles qui ne surveillent que la santé du stockage objet manquent souvent les signaux précoces. Le bucket paraît sain pendant que la table devient plus difficile à croire.
Un plan de déploiement pratique pour les équipes data
Un déploiement propre commence petit, mais il ne doit pas commencer flou. Vous voulez un pilote qui expose tôt les aspérités opérationnelles.
La phase 1 choisit le plan de contrôle
Choisissez d'abord le catalogue. La disposition des fichiers compte, mais le catalogue décide comment les moteurs découvrent les tables, coordonnent les écritures et appliquent les politiques.
Évaluez des options telles que les catalogues orientés REST, les montages de type Hive Metastore et les catalogues natifs du cloud en posant des questions pratiques :
Quels moteurs doivent lire et écrire nativement
Où résideront la propriété des tables et les permissions
Comment les changements de schéma seront revus
Que se passe-t-il si le catalogue est indisponible
Si vous sautez cette étape, vous la reconstruirez souvent plus tard sous pression.
La phase 2 pose la base de sécurité et de gouvernance
Avant une adoption large, définissez le contrat d'exploitation minimal.
Cela inclut généralement SSO, RBAC, chiffrement en transit et au repos, identités de service contrôlées et une politique de restrictions de lignes ou de colonnes là où c'est nécessaire. Cela inclut aussi les attentes de lignage, l'étiquetage PII et les circuits d'approbation des changements de schéma.
Une option d'outil utile à ce stade est digna, qui s'exécute dans l'environnement du client et surveille le comportement des données, la Timeliness, la validation des enregistrements, les changements de schéma et les métriques de plateforme sur les lacs, entrepôts et pipelines. Pour les formats de table ouverts, cela compte car les problèmes de fiabilité apparaissent souvent d'abord comme des instantanés périmés, une dérive de schéma, des écritures retardées ou des anomalies de métriques métier plutôt que comme de franches pannes de pipeline.
La phase 3 met le chemin d'écriture sous tension
Ne validez pas l'architecture avec un unique batch quotidien.
Utilisez un jeu pilote avec plusieurs écrivains quotidiens, au moins un flux de maintenance et un moteur de requête distinct du moteur d'écriture principal. Intégrez au test un job de partitionnement caché ou d'optimisation de disposition pour que votre équipe doive gérer changements d'instantané, effets de compaction et décisions de retour arrière dans des conditions réalistes.
Un bon pilote devrait soulever quelques questions inconfortables. Qui approuve les changements de schéma ? Qui est appelé en cas de commits en échec ? Quels lecteurs sont autorisés pendant les fenêtres de maintenance ? Ce sont exactement les problèmes à faire surgir tôt.
La phase 4 instrumente la couche de métadonnées
La seule surveillance du stockage ne vous en dira pas assez.
Suivez des signaux tels que :
L'âge des instantanés pour la fraîcheur de l'état de table publié.
Le retard de compaction pour que la prolifération de fichiers ne dégrade pas les performances.
Les schémas d'échec des écrivains d'un moteur à l'autre.
Les événements de dérive de schéma avant que les tableaux de bord en aval ne cassent.
La croissance des fichiers orphelins après des reprises ou des opérations avortées.
Si vous ne voyez pas la santé du chemin des métadonnées de table, vous fonctionnez surtout à l'espoir.
Les formats de table ouverts résolvent le problème de la couche table, mais ils ne suppriment pas le besoin d'une exploitation disciplinée. digna aide les équipes à surveiller les changements de schéma, la Timeliness, les anomalies et le comportement de la plateforme dans leur propre environnement, ce qui correspond aux modes de défaillance qui apparaissent après l'adoption d'un lakehouse. Si vos tables couvrent déjà plusieurs moteurs et jobs de maintenance, il vaut la peine de voir comment digna peut vous aider à surveiller la couche de fiabilité pilotée par les métadonnées, et pas seulement les fichiers en dessous.
Les équipes qui déploient sur Databricks ajoutent généralement l'observabilité de la plateforme Databricks dans la même phase, afin que garanties au niveau table et contrôles au niveau valeur arrivent ensemble.
Questions fréquentes
Comment les formats de table ont-ils évolué depuis Hive ?
Hive définissait une table comme une disposition de répertoires, si bien que les partitions étaient des dossiers et le listage des fichiers faisait autorité. Cela s'est effondré sur le stockage objet, où les listages sont lents et à cohérence éventuelle. Les formats modernes ont déplacé la définition de la table dans des fichiers de métadonnées, supprimant totalement la dépendance à la structure de répertoires.
Que signifie ACID pour une table de data lake ?
Cela signifie qu'une écriture devient visible en totalité ou pas du tout, et que les lecteurs concurrents ne sont jamais exposés à un changement en cours. Sur un lac, cette garantie vient de l'échange atomique d'un pointeur de métadonnées, pas d'un journal de transactions de base de données, ce qui explique qu'elle fonctionne sur du stockage objet brut.
Peut-on changer le schéma d'une table sans la réécrire ?
Oui. Ajouter, supprimer, renommer ou réordonner des colonnes est consigné dans les métadonnées et appliqué à la lecture, si bien que les fichiers de données existants restent intacts. Le hic est que les lecteurs doivent appliquer les mêmes règles : un moteur au support partiel peut renvoyer des valeurs nulles pour une colonne renommée au lieu de lever une erreur.
Pourquoi un lac se comporte-t-il comme une table dans un outil et comme un tas de fichiers dans un autre ?
Parce que la garantie vit dans la couche de métadonnées, et que seuls les moteurs qui lisent cette couche en bénéficient. Un outil pointé directement sur les fichiers Parquet sous-jacents contourne entièrement l'historique des commits et voit ce qui se trouve sur le stockage, y compris des fichiers issus d'une écriture jamais validée.
À quoi ressemble un déploiement sensé ?
Convertissez d'abord une table bien comprise, gardez l'originale en écriture parallèle et migrez les consommateurs progressivement en comparant les sorties. Décidez qui gère l'expiration des instantanés et la compaction avant la mise en service, car une maintenance sans responsable est la raison la plus fréquente pour laquelle un pilote réussi se dégrade au trimestre suivant.


