Guide sur l'architecture et la fiabilité des pipelines de données ETL
|
7
minute de lecture

Une étude de référence de 2026 a révélé que 97 % des responsables des données et des technologies affirment que les défaillances de pipelines ont ralenti les initiatives d'analyse ou d'IA, avec une exposition financière mensuelle moyenne d'environ 3 millions de dollars (couverture de l'étude par StorageNewsletter). Cela change ma façon d'évaluer un pipeline de données ETL. La question n'est pas de savoir si une tâche s'est terminée, mais si le pipeline a fourni des données fiables, à temps, avec suffisamment d'éléments pour expliquer ce qui s'est passé lorsqu'un changement est survenu.
Un pipeline ETL est souvent traité comme de la simple plomberie. Dans une entreprise, il se comporte plutôt comme un service de production. Il a des dépendances, des attentes de service, des modes de défaillance, des procédures de récupération et des utilisateurs qui peuvent prendre des décisions financières, opérationnelles ou réglementaires à partir de ses résultats. Le travail de fiabilité n'est donc pas une maintenance superficielle. Il fait partie intégrante du produit de données.
Table des matières
Pourquoi les pipelines ETL comptent toujours en 2026
Le coût commercial d'un incident de pipeline apparaît rarement dans l'ordonnanceur. Une tâche échouée peut ressembler à un simple statut rouge, mais les conséquences peuvent inclure des tableaux de bord obsolètes, des rapprochements retardés, des entraînements de modèles interrompus, des investigations manuelles et des décisions prises sur la base d'informations incomplètes. L'étude citée plus haut a révélé que les défaillances de pipelines ralentissent déjà les programmes d'analyse et d'IA au sein des équipes de direction, ce qui fait de l'Observability une priorité commerciale plutôt qu'une simple fonctionnalité de tableau de bord.
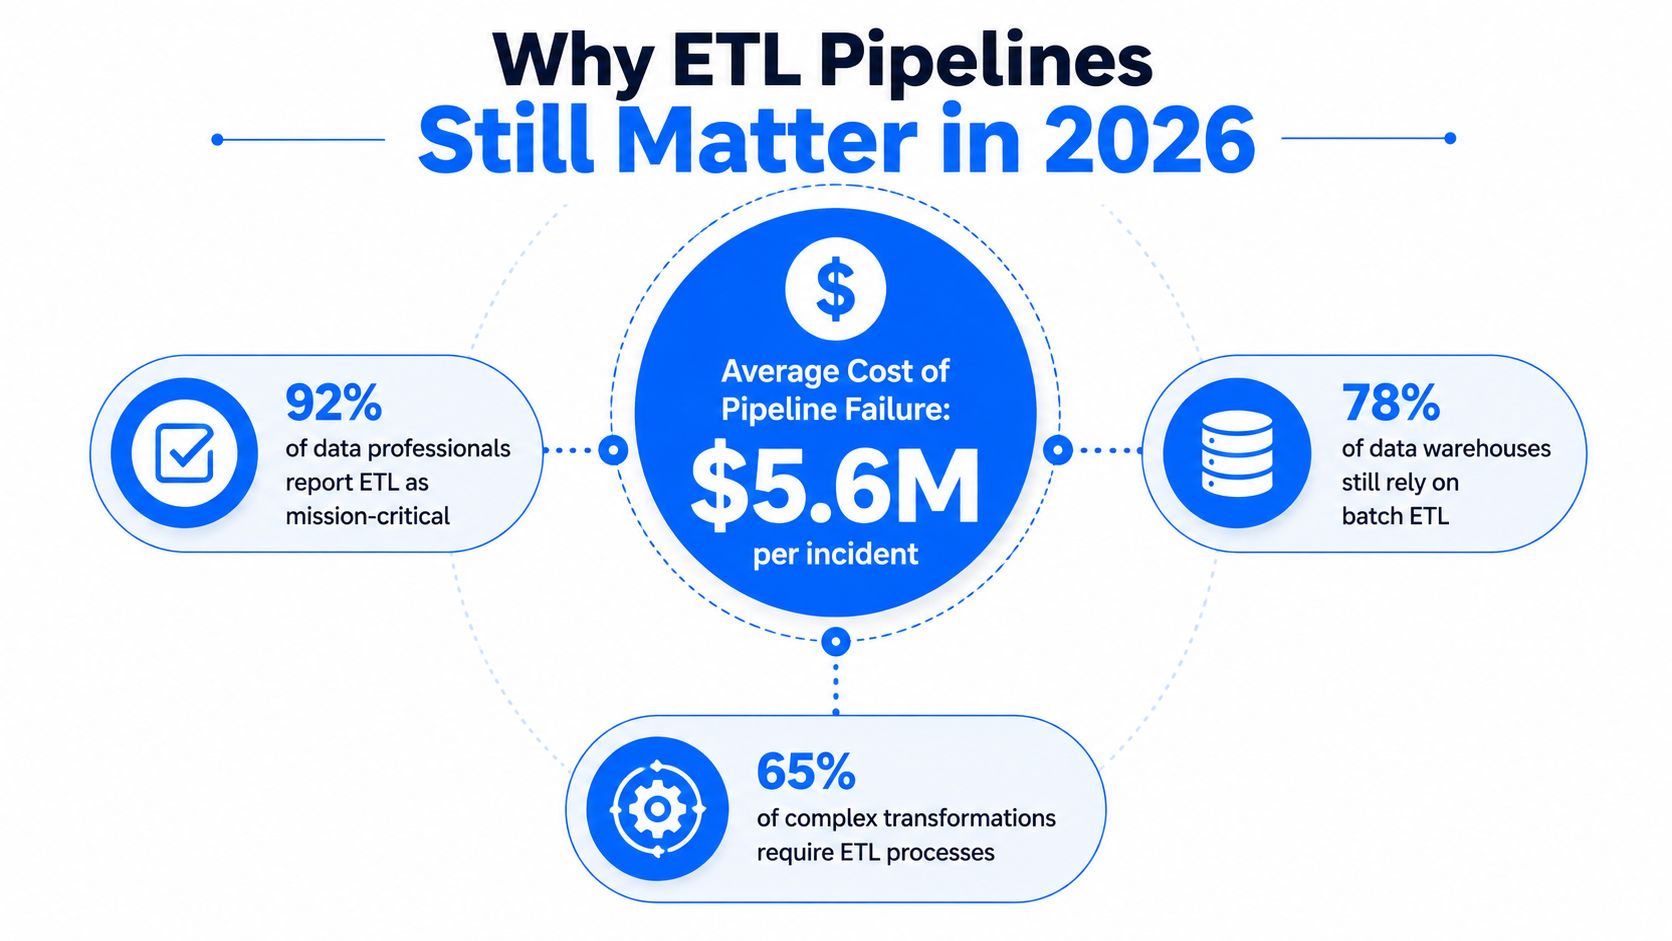
L'image contient des affirmations qui ne font pas partie des données vérifiées disponibles pour cet article, notamment le coût de défaillance déclaré et les pourcentages dans les bulles statistiques environnantes. Ces chiffres ne doivent pas être utilisés comme preuves. L'étude de référence vérifiée soutient une conclusion différente, mais tout aussi urgente : les défaillances de pipelines génèrent environ 3 millions de dollars d'exposition commerciale mensuelle moyenne pour les organisations représentées dans le rapport (StorageNewsletter).
L'ETL reste fondamental
L'ETL est devenu un modèle de données d'entreprise incontournable au début des années 1990, à mesure que les entrepôts de données s'imposaient dans l'analyse décisionnelle. Des produits d'intégration dédiés sont apparus à cette époque, notamment Prism Solutions, fondé en 1988, Informatica, fondé en 1993, et DataStage au cours de la même période. En 1995, le Data Warehousing Institute avait été fondé, reflétant la rapidité avec laquelle le mouvement des données axé sur les entrepôts est devenu une catégorie de logiciels d'entreprise distincte (aperçu historique des entrepôts de données).
Ce modèle persiste car de nombreuses organisations ont encore besoin que les transformations soient contrôlées, reproductibles et vérifiables avant que les données n'atteignent les systèmes analytiques. Les secteurs de la finance, de la santé, des télécommunications et le secteur public ne peuvent souvent pas considérer les données sources brutes comme immédiatement fiables. Ils ont besoin de correspondances définies, de preuves de validation, de logique de rapprochement, de contrôles d'accès et d'exécutions reproductibles.
L'ELT et le streaming ont élargi les possibilités d'architecture, mais ils n'ont pas éliminé l'ETL. Une plateforme moderne peut utiliser la capture de données modifiées (CDC) pour une source, un ETL par lots pour un grand livre réglementé, un ELT pour des modèles d'entrepôt exploratoires et le streaming pour les événements sensibles au facteur temps. L'architecture judicieuse est celle qui correspond au risque lié aux données, aux exigences de latence, à l'emplacement du calcul, aux obligations de governance et aux capacités de récupération.
Pour les détails d'implémentation, les équipes peuvent s'appuyer sur les bonnes pratiques de pipeline de données de digna en parallèle de leurs normes existantes d'orchestration et de governance. L'objectif pratique est simple : rendre le comportement du pipeline visible en termes commerciaux avant qu'un chargement manqué ne se transforme en incident analytique.
Comprendre les composants de l'architecture ETL principale
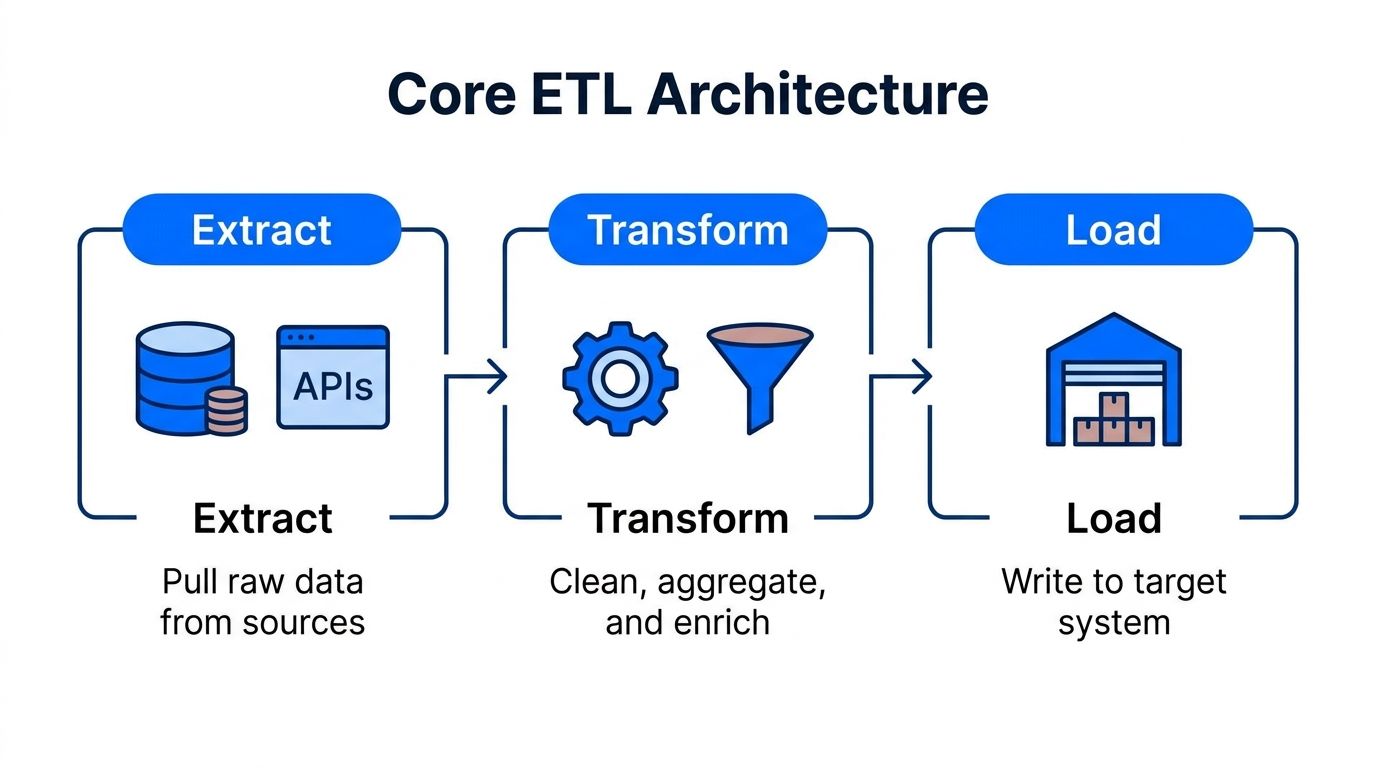
Un pipeline de données ETL comporte trois mouvements clés : l'extraction, la transformation et le chargement. En production, ces étapes s'inscrivent généralement dans une structure de contrôle plus large qui gère le stockage temporaire, les points de contrôle, les dépendances, les tentatives, la validation et les preuves opérationnelles.
Extraire depuis la source
L'extraction récupère les données à partir de bases de données opérationnelles, d'API, de fichiers, d'applications SaaS ou d'autres systèmes. La difficulté ne réside pas seulement dans la connexion à chaque source, mais dans la conservation d'un contexte suffisant pour savoir ce qui a été extrait, quand cela a été extrait, quelle version de la source a été utilisée et si la source a renvoyé une réponse complète.
Un extracteur résilient gère soigneusement les limites incrémentielles. Il enregistre un point de contrôle, tel que le dernier marqueur de mise à jour accepté, et évite de faire progresser ce point de contrôle tant que l'écriture en aval n'a pas réussi. Si l'exécution s'arrête en cours de route, le pipeline peut reprendre ou rejouer à partir d'une position connue au lieu de deviner ce qui a été traité.
Une zone de transit (staging area) offre une autre limite utile. Les extractions brutes peuvent y être conservées avant transformation, ce qui permet aux ingénieurs d'inspecter le comportement de la source, de rejouer les transformations et de séparer les problèmes de disponibilité de la source des défauts de transformation.
Transformer dans un format de confiance
La transformation est l'étape où le pipeline normalise les formats, applique les règles métier, supprime les enregistrements inutilisables, rapproche les entités et crée des structures analytiques. Un identifiant client peut nécessiter une normalisation entre les systèmes. Les horodatages peuvent nécessiter une interprétation commune. Les enregistrements de transactions peuvent nécessiter une gestion des doublons et des vérifications de référentiel avant de pouvoir alimenter les rapports.
Gardez la logique de transformation modulaire. Un script monolithique unique rend difficile l'isolation d'une correspondance défectueuse ou l'identification de la règle qui a modifié la sortie. Des composants gérés par version, des entrées et sorties explicites et des fonctions testables rendent la révision et le retour en arrière plus pratiques.
Charger avec contrôle
Le chargement écrit les résultats validés dans un entrepôt, un lac de données, un magasin opérationnel ou une autre cible. Un chargeur fiable fait la distinction entre une écriture terminée et une écriture partiellement terminée. Il utilise un comportement idempotent lorsque cela est possible, enregistre les lignes acceptées et rejetées et rend l'étape finale de publication explicite.
L'orchestration doit coordonner les dépendances plutôt que de lancer des tâches selon un simple calendrier. Pour les équipes qui conçoivent la partie source de cette architecture, le guide de pipeline d'intégration de données de digna offre un point de référence utile. Le principe de conception clé est de traiter chaque étape comme un contrat observable, et non comme un transfert opaque.
Choisir entre les approches ETL et ELT
L'ETL et l'ELT diffèrent principalement par l'endroit où s'effectue la transformation. L'ETL transforme les données avant de les charger dans la cible. L'ELT charge d'abord les données brutes, puis utilise l'entrepôt ou le lac de données cible pour les transformer.
Aucune approche ne l'emporte de manière universelle. L'ETL peut être le meilleur choix lorsque des enregistrements sensibles ou non valides doivent être filtrés avant d'entrer dans un espace de stockage analytique partagé, lorsque la cible dispose d'une puissance de calcul limitée, ou lorsqu'une représentation contrôlée avant chargement est requise pour la conformité. L'ELT peut être plus flexible lorsque les équipes doivent conserver l'historique brut, itérer sur des modèles et utiliser la puissance de calcul évolutive de l'entrepôt pour les transformations.
La décision dépend également de la récupération après défaillance. L'ETL peut réduire la quantité de données inappropriées atteignant la cible, mais un défaut de transformation peut imposer un retraitement en amont. L'ELT préserve les données brutes pour une modélisation ultérieure, mais déplace une plus grande responsabilité vers la governance de l'entrepôt, le contrôle d'accès, les tests et la gestion du calcul.
Une matrice de décision utile se présente ainsi :
Facteur | Choisir l'ETL quand | Choisir l'ELT quand |
|---|---|---|
Compliance | Les données sensibles doivent être transformées ou restreintes avant le chargement | Les données brutes peuvent être conservées sous des contrôles d'accès stricts |
Qualité des données | La Data Validation avant chargement doit bloquer les enregistrements inappropriés | Les tests de l'entrepôt peuvent régir les modèles après intégration |
Lieu de calcul | Un traitement externe est disponible ou la cible dispose d'un calcul limité | L'entrepôt ou le lac de données fournit la capacité de transformation appropriée |
Retraitement | Le contrat préalable au chargement est stable et étroitement contrôlé | Les équipes ont besoin de réanalyser les données brutes avec une logique métier changeante |
Governance | Une cible organisée est requise avant un accès large | Les zones brutes et modélisées peuvent être séparées et régies |
Compétences de l'équipe | Les ingénieurs sont plus performants avec les outils d'intégration et les transformations procédurales | Les analystes et ingénieurs sont à l'aise avec la modélisation d'entrepôt basée sur SQL |
Architecture | Les bases de données existantes ou les flux de travail par lots réglementés dominent | Le stockage cloud natif et le traitement élastique de l'entrepôt sont centraux |
Modèle opérationnel | L'organisation valorise des jalons de validation stricts avant la publication | L'organisation a besoin d'une expérimentation rapide avec des modèles traçables |
Les conceptions hybrides sont courantes pour de bonnes raisons. Une équipe peut utiliser l'ETL pour tokeniser les champs sensibles et appliquer des contrats au niveau de la source, puis utiliser l'ELT pour la modélisation dimensionnelle en aval. Cette configuration préserve le contrôle à la source sans sacrifier la flexibilité analytique.
Utilisez l'explication de l'intégration de données par digna pour clarifier les limites de l'intégration avant de choisir un modèle de transformation. La décision la plus importante n'est pas le choix du terme, mais de savoir si l'architecture rend le risque lié aux données, le coût, le lignage et la récupération visibles pour les personnes responsables du résultat.
Défaillances courantes des pipelines et fardeau de la maintenance
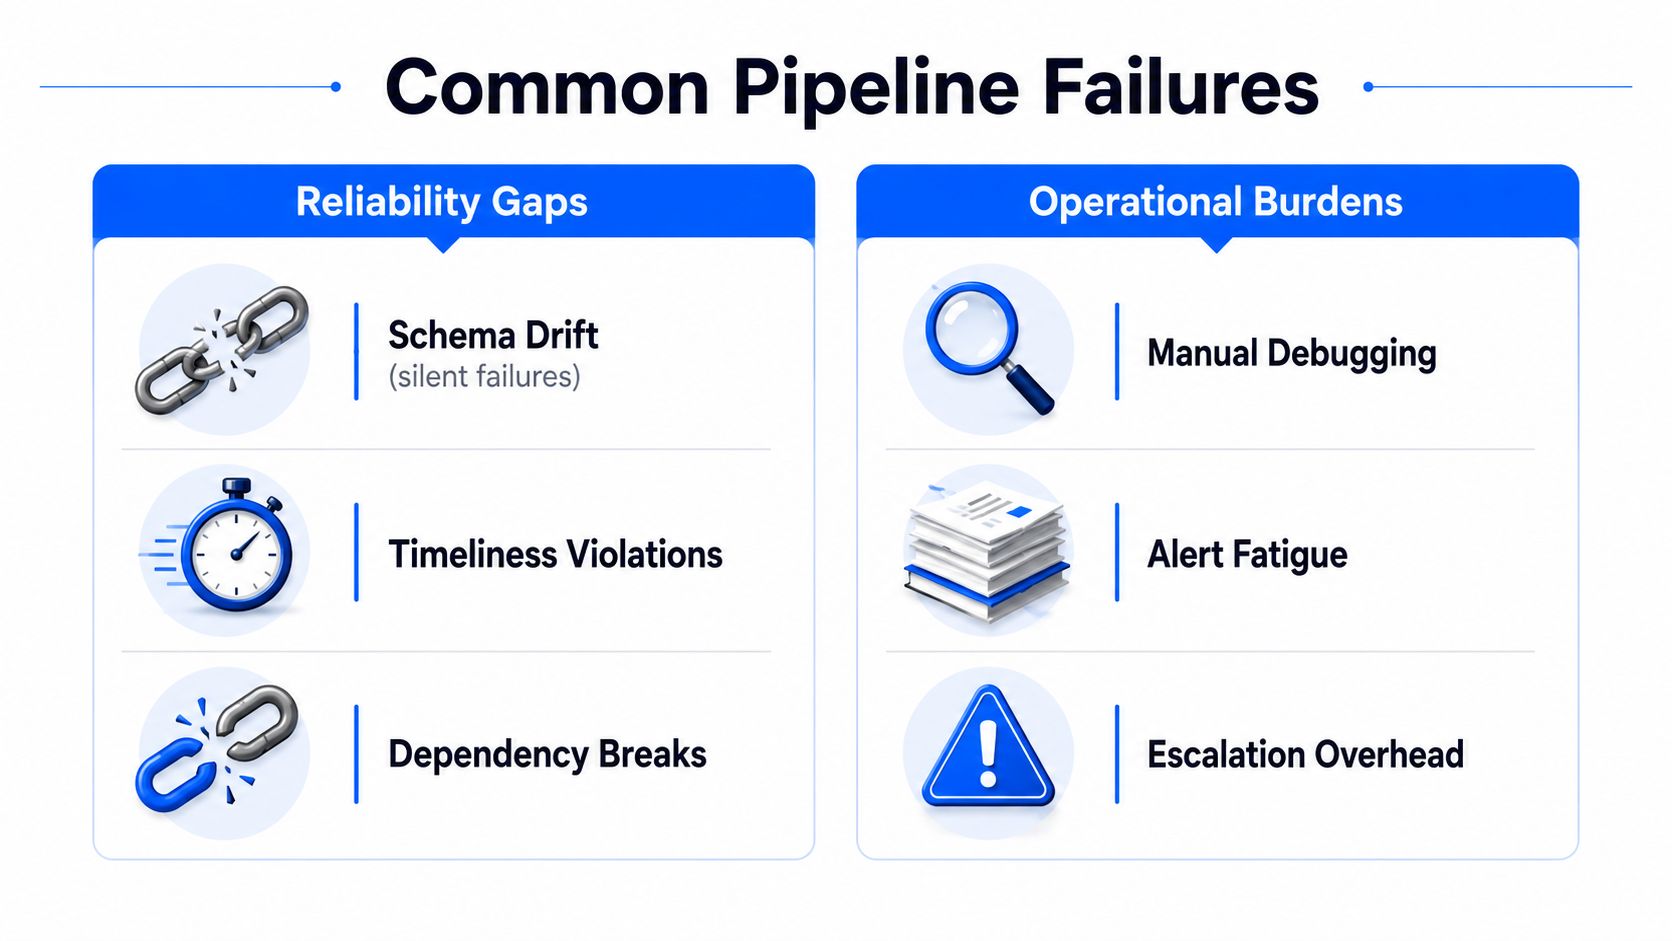
Un statut vert dans l'ordonnanceur cache bien plus de choses qu'il n'en révèle sur l'exactitude d'un pipeline. Une tâche ETL peut se terminer après avoir intégré un fichier incomplet, accepté un type de colonne modifié, chargé des enregistrements obsolètes ou produit un résultat techniquement valide qui fausse les revenus, les stocks ou l'activité des clients.
La dérive de schéma est une source courante de défaillance silencieuse. Supposons qu'une source remplace un customer_id d'un entier par une chaîne de caractères, ou renomme order_status alors que l'extraction indique toujours un succès. La transformation peut rejeter toutes les lignes, convertir les valeurs de manière incorrecte ou publier un résultat dont le sens a changé. Comparez les métadonnées entrantes avec une version de référence à chaque exécution, classez le changement et mettez en quarantaine les anomalies avant l'exécution du chargement complet. Les conseils sur les incidents de dérive de schéma fournissent un contexte utile pour gérer ces événements.
Ce que la surveillance classique ne détecte pas
Compter les tâches ayant échoué permet de capturer les erreurs d'exécution explicites, alors que des opérations fiables nécessitent des signaux plus larges :
Débit : Comparer le volume attendu avec les lignes ou octets réellement traités.
Fraîcheur : Confirmer que les derniers enregistrements sont arrivés dans la fenêtre de service convenue.
Disponibilité : Vérifier si le pipeline et ses dépendances sont utilisables lorsque les consommateurs en ont besoin.
Temps de récupération : Mesurer le temps nécessaire aux équipes pour rétablir une livraison fiable.
Comportement d'erreur : Surveiller les lignes rejetées, les tentatives, la croissance des files d'attente d'erreurs (dead-letter) et les échecs partiels récurrents.
Les contrôles de Timeliness doivent combiner les horodatages sources tels que created_at ou updated_at avec des signaux de pulsation et des comparaisons entre le calendrier et la disponibilité réelle. Ces contrôles peuvent révéler une intégration retardée avant qu'un rapport en aval n'échoue visiblement (conseils de surveillance de la ponctualité).
La maintenance est une contrainte économique
Les pipelines hérités et développés en interne tombent plus souvent en panne que les systèmes ELT entièrement managés, et les ingénieurs de données peuvent consacrer jusqu'à 53 % de leur temps à la maintenance des pipelines, selon l'enquête de fin 2025 évoquée dans les rapports de TechTarget. L'ELT managé ne supprime pas le travail de fiabilité. Les équipes ont toujours besoin de contrats, de responsabilités, de procédures de récupération et de tests. Le choix opérationnel doit prendre en compte la main-d'œuvre, les temps d'arrêt et le coût de l'investigation des résultats trompeurs.
L'Observability modifie ce calcul lorsqu'elle relie les symptômes à l'impact et à la cause probable. Le guide de Captapi pour des systèmes résilients propose un traitement plus large des tests de résilience et du comportement face aux pannes. Les alertes doivent identifier les ensembles de données affectés, l'urgence et l'action suivante plutôt que de créer une énième file d'attente de bruits inexpliqués.
Une discussion ciblée sur la détection précoce figure dans l'analyse de digna sur les raisons pour lesquelles les pipelines de données échouent en production. L'objectif pratique est de raccourcir le chemin entre un changement de source et une décision opérationnelle sûre, transformant la visibilité du pipeline d'un fardeau de maintenance en un atout pour une livraison de données fiable.
Bâtir la fiabilité grâce aux contrôles qualité
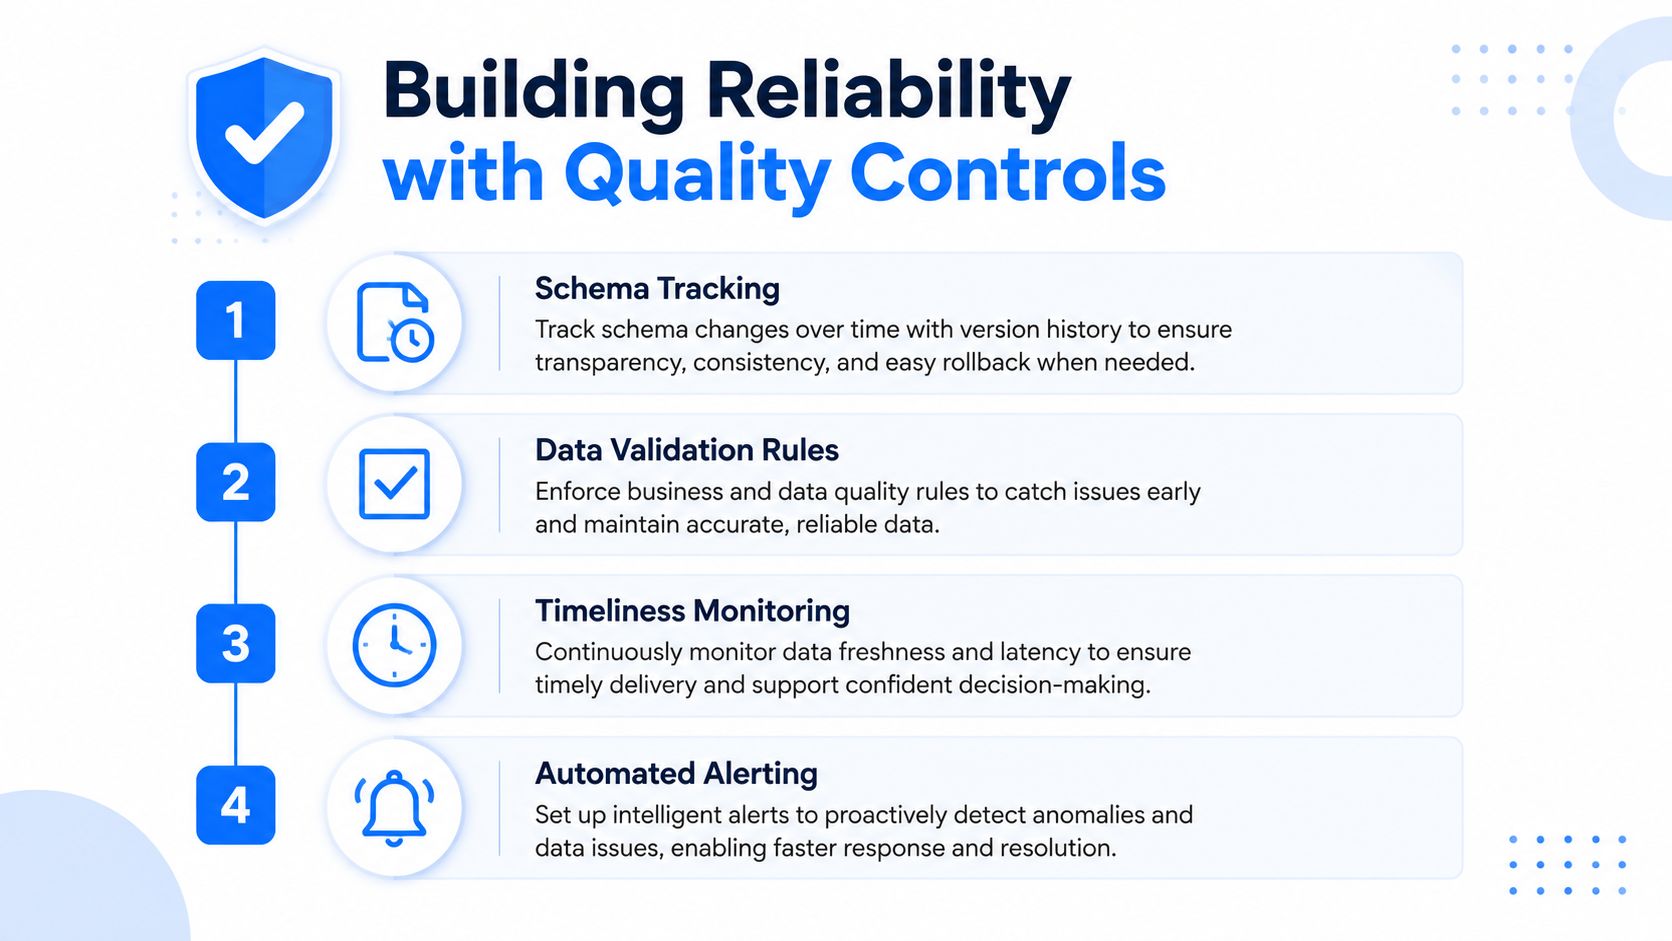
La fiabilité dépend des contrôles mis en place tout au long du pipeline. Le suivi des schémas détecte les changements structurels, la validation teste le sens des données, la surveillance de la Timeliness identifie les problèmes de livraison et les métriques opérationnelles révèlent une baisse de qualité d'exécution même lorsque les tâches se terminent avec succès. Ensemble, ces contrôles limitent le coût caché des défaillances, notamment le retraitement, l'investigation manuelle, les décisions retardées et la perte de confiance dans les résultats en aval.
Commencer dès l'intégration
Gérez la dérive de schéma à la limite de la source, avant qu'une structure modifiée n'atteigne les transformations et les lecteurs en aval. Établissez une version de référence pour chaque source importante, comparez les métadonnées entrantes à chaque exécution et classez les modifications par niveau de risque.
L'ajout d'un champ compatible peut nécessiter une révision sans pour autant provoquer d'interruption. Un champ supprimé, un changement de type incompatible ou une clé métier renommée devrait généralement arrêter ou mettre en quarantaine le flux affecté jusqu'à ce qu'un responsable le certifie explicitement à nouveau. Les exécutions de test (canary runs) et les registres de schémas permettent aux équipes de tester la compatibilité avant de publier le chargement complet.
Valider les enregistrements et relations
Les règles métier transforment les attentes de qualité en décisions que les systèmes peuvent tester. Les contrôles en entreprise peuvent inclure des plages de variation du nombre de lignes de ±30 %, une limite de taux de valeurs nulles pour les e-mails inférieure à 5 %, et une règle d'intégrité référentielle exigeant que chaque order.customer_id existe dans la table des clients (exemples de contrôle qualité ETL).
Ces seuils ne sont pas des valeurs par défaut universelles. Ce sont des contrats explicites que les propriétaires de données doivent approuver, documenter et réviser lorsque le comportement de la source change. La validation au niveau de l'enregistrement crée également des preuves d'audit en indiquant quelle règle a échoué et quels enregistrements ont été affectés. Les travaux universitaires sur la vérification des règles métier pour la qualité des données soutiennent l'évaluation de la qualité par rapport à des règles définies. Pour des conseils de mise en œuvre, voir l'analyse de digna sur les règles de validation des données et la qualité continue des données.
Surveiller la livraison et la récupération
Un pipeline peut réussir tous les tests de contenu et manquer tout de même son échéance commerciale. Définissez les attentes de fraîcheur à partir des horodatages sources, des modèles d'arrivée attendus et des exigences de service en aval. Alertez en cas de livraison manquante, tardive ou précoce lorsque ces événements indiquent un problème en amont ou de planification.
Suivez les lignes entrantes, les lignes sortantes, les lignes rejetées, la durée, le nombre d'erreurs et la fraîcheur pour chaque étape. Les conseils d'experts recommandent de cibler des taux d'erreur inférieurs à 0,1 %, de traiter les taux supérieurs à 5 % comme un signal de défaillance systémique, de maintenir une disponibilité de 99,9 % et de rétablir le service en moins de 30 minutes (guide de référence d'analyse comparative ETL).
Règle opérationnelle : Une alerte doit identifier le jeu de données, le contrat violé, la dépendance probable, le responsable métier et la prochaine action corrective sûre.
Ces contrôles forment une boucle opérationnelle unique. Une détection sans quarantaine laisse les mauvaises données se propager. Une validation sans suivi de la Timeliness laisse les utilisateurs avec des résultats obsolètes. Des métriques sans attribution de responsabilité produisent des graphiques mais pas de résolution. L'Observability relie chaque signal à une réponse hiérarchisée, réduisant le travail de maintenance tout en faisant de la livraison de données fiables une capacité opérationnelle maîtrisée.
Comment la Data Observability transforme les opérations
La surveillance traditionnelle demande si une tâche s'est exécutée. La Data Observability demande si les données se sont comportées comme prévu, si les consommateurs les ont reçues à temps et quel changement explique l'anomalie.
Prenons l'exemple d'un pipeline de services financiers qui reçoit des données de transaction provenant de plusieurs systèmes opérationnels. Une équipe source ajoute un champ et modifie un type sans se coordonner avec l'équipe de la plateforme de données. Un ordonnanceur peut signaler le succès de l'extraction, tandis qu'un modèle en aval supprime des valeurs ou modifie son agrégation sans notification. Le suivi des schémas peut identifier la modification structurelle dès l'intégration, mettre en quarantaine le flux affecté et fournir des preuves aux ingénieurs avant qu'un cycle de reporting ne dépende de ce résultat.
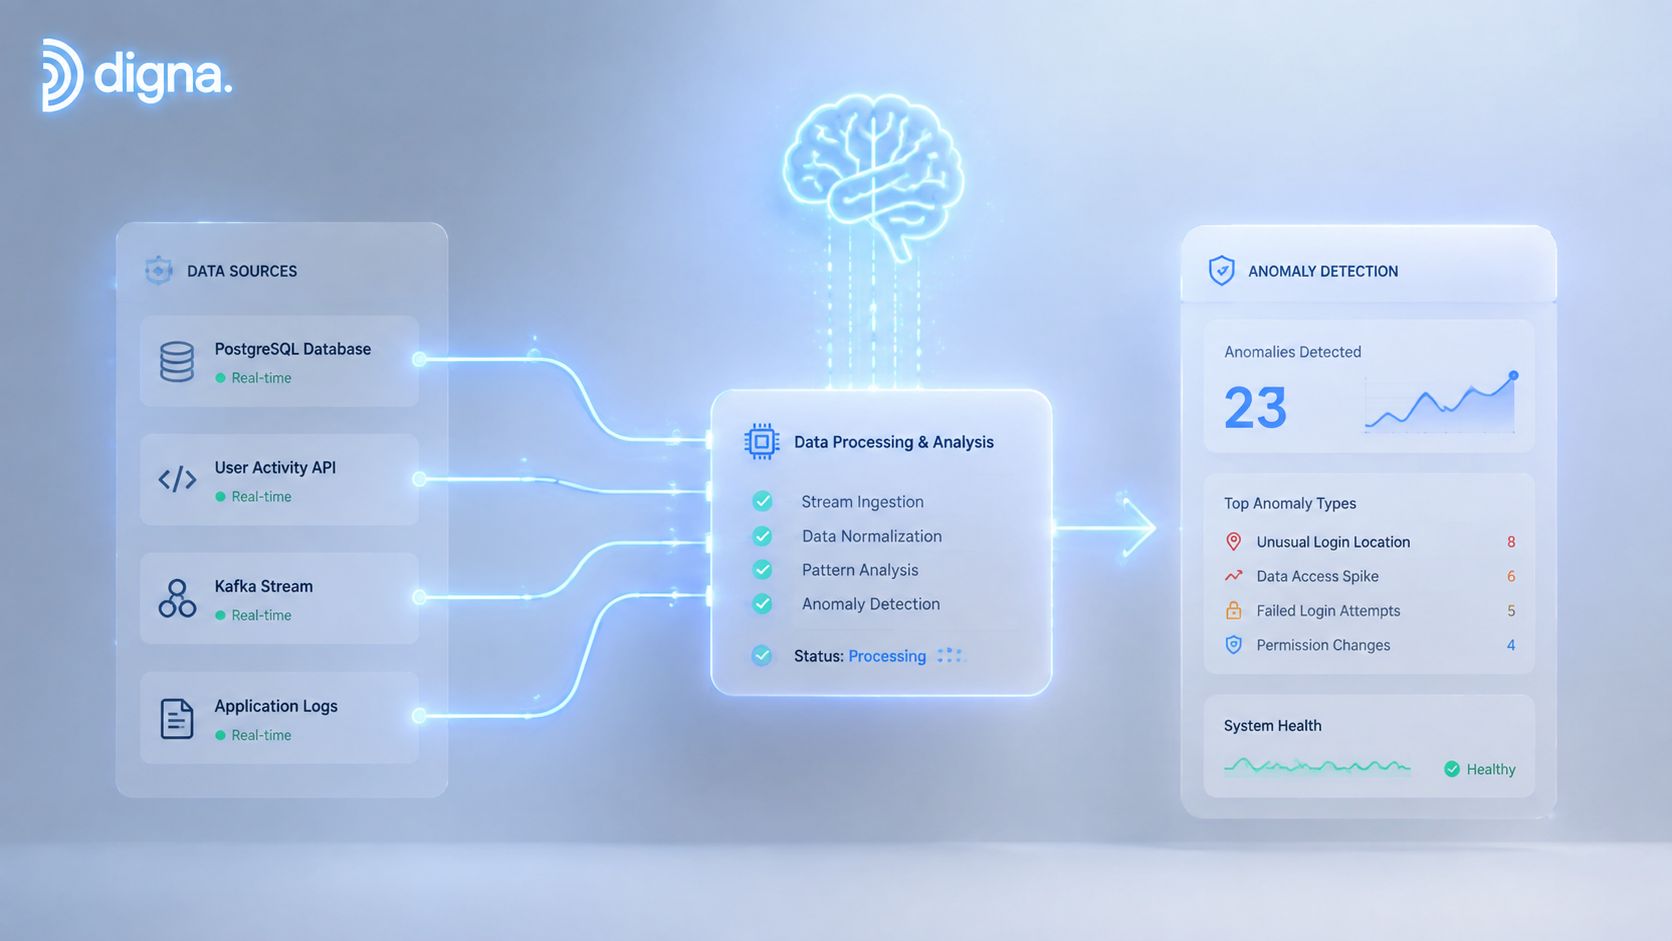
Les pipelines du secteur de la santé créent une pression différente. Un jeu de données peut arriver avec un schéma familier mais un profil de complétude inhabituel, omettant une partie significative des enregistrements attendus. La détection d'anomalies de référence peut signaler ce changement de comportement, tandis que les contrôles de validation peuvent tester les relations requises et les règles métier. La surveillance de la Timeliness distingue alors un flux retardé d'un flux arrivé à l'heure mais contenant un contenu anormal.
Les équipes de télécommunications gèrent souvent de gros volumes de données opérationnelles et clients sur des systèmes hétérogènes. Une couche d'Observability efficace doit relier le comportement de la plateforme à celui des données, afin que les ingénieurs puissent distinguer un problème de charge de travail, une panne de source, un changement de schéma et un défaut de qualité. Pour les équipes qui gèrent à la fois des plateformes de données et des pratiques d'ingénierie de fiabilité des sites (SRE), les ressources sur la surveillance des infrastructures pour les SRE fournissent un contexte pertinent pour réfléchir aux signaux, aux dépendances et à la réponse aux incidents.
digna peut être une option dans cette catégorie. Elle s'exécute au sein de l'environnement du client, effectue des contrôles directement dans la base de données, surveille les anomalies, la Timeliness, les règles de validation, les modifications de schéma et les métriques de la plateforme, et prend en charge le déploiement sur cloud privé ou sur site. Sa structure modulaire permet à une équipe de commencer par une fonctionnalité de surveillance et de l'étendre aux tables et pipelines critiques, tandis qu'une interface partagée offre aux ingénieurs, aux analystes et aux parties prenantes une vue commune des incidents et des tendances.
Ce virage stratégique se mesure dans le flux de travail, même lorsque les données elles-mêmes restent en place. Les ingénieurs passent moins de temps à prouver qu'une panne a eu lieu et plus de temps à décider s'il faut bloquer, rejouer, corriger ou communiquer sur l'impact.
Implémenter l'Observability dans votre environnement
Commencez par les jeux de données qui ont des conséquences commerciales claires. Cartographiez leurs sources, leurs propriétaires, leurs consommateurs en aval, le comportement de livraison attendu, les champs clés et les dépendances de récupération. Ne commencez pas par instrumenter chaque table. Un premier périmètre restreint permet de définir plus clairement les responsabilités et met en évidence les lacunes dans les contrats.
Ensuite, établissez une référence pour chaque jeu de données sélectionné. Capturez le volume normal, le comportement d'arrivée, la structure du schéma, les profils de valeurs nulles et les résultats de validation. Configurez des alertes pour les anomalies qui nécessitent une action, et orientez-les vers l'équipe capable de modifier la source, le pipeline ou la cible. Une alerte qui n'atteint personne capable d'y remédier n'est qu'une documentation d'échec.
Ajoutez des contrôles sans remplacer l'ordonnanceur existant. Airflow, dbt, Informatica, Talend et Spark peuvent continuer à orchestrer les transformations pendant qu'une couche d'Observability évalue leur comportement. Commencez en mode surveillance si le blocage des chargements présente un risque inutile, puis transformez les contrôles à haute fiabilité en barrières de quarantaine ou de validation.
Rendre la gestion des incidents collaborative
Définissez une fiche d'incident qui comprend l'attente non respectée, les données concernées, l'heure de première détection, le statut actuel, le propriétaire, la correction et l'action de suivi. Examinez les défaillances récurrentes en fonction de leur impact commercial, et non du nombre d'alertes. Un jeu de données en retard à faible impact peut être moins prioritaire qu'un changement de schéma subtil dans un flux réglementaire, même si ce dernier n'a généré aucune erreur dans l'ordonnanceur.
Mesurez si cette pratique réduit le délai de détection, l'effort d'investigation, la récurrence, les livraisons obsolètes et les données rejetées. Gardez l'évaluation liée aux résultats commerciaux, tels qu'un reporting fiable et des données d'entrée plus sûres pour l'IA. L'Observability devient un actif stratégique lorsque les dirigeants peuvent voir quels investissements dans la fiabilité protègent les décisions et quels changements de pipelines créent une nouvelle exposition.
digna fournit une Data Observability intégrée à l'environnement pour les pipelines ETL, comprenant la détection d'anomalies, le suivi des schémas, la surveillance de la Timeliness, la validation au niveau de l'enregistrement et les métriques de la plateforme. Visitez digna pour évaluer comment son modèle de déploiement modulaire peut aider votre équipe à détecter plus tôt les risques liés aux pipelines et à transformer le travail de fiabilité en une pratique opérationnelle transparente.
Questions fréquentes
Que coûte réellement une panne de pipeline ?
Un benchmark de 2026 indique que 97 % des dirigeants data et technologie estiment que les pannes de pipeline ont ralenti des initiatives d'analytique ou d'IA, avec une exposition métier mensuelle moyenne d'environ 3 millions de dollars. Ce coût apparaît rarement dans l'ordonnanceur, d'où son absence des budgets.
Pourquoi l'ETL compte-t-il encore face à l'ELT et au streaming ?
Parce que beaucoup d'organisations ont toujours besoin de transformations maîtrisées, reproductibles et auditables avant que la donnée n'atteigne les systèmes analytiques. L'ELT et le streaming ont élargi l'espace de conception sans supprimer cette exigence.
Quand l'ETL est-il devenu un motif standard ?
Au début des années 1990, quand les entrepôts de données ont gagné l'analytique courante. Des produits d'intégration dédiés sont nés à cette période, dont Prism Solutions fondée en 1988, Informatica fondée en 1993 et DataStage à la même époque.
Quels mouvements définissent un pipeline ETL ?
Trois : extraire à la lisière de la source, transformer selon une logique convenue, charger dans la cible. Les nommer séparément compte car chacun a ses modes de défaillance et chacun laisse entrer un type de défaut différent.
Que surveiller au-delà du statut du job ?
La donnée que le job a produite. Un ordonnanceur signale l'achèvement, tandis que l'exposition métier provient d'une sortie achevée et fausse : le travail de fiabilité relève donc de la couche de données et pas seulement de l'orchestration.