8 KPI de Data Governance à mesurer en 2026
|
8
minute de lecture

La plupart des programmes de governance échouent non pas parce que personne n'a écrit de politiques, mais parce que les équipes ne peuvent pas prouver que ces politiques modifient ce qui se passe en production. Un benchmark de la governance d'entreprise de 2025 a révélé que 71 % des organisations gèrent un programme formel de Data Governance, contre 60 % deux ans plus tôt (2025 enterprise governance benchmark). L'adoption formelle est en hausse, mais le même benchmark a identifié la qualité des données comme le principal point de douleur des entreprises à 56 %, la governance suivant de près à 54 %. L'implication est claire : documenter la propriété et publier des normes ne suffit pas. Les dirigeants ont besoin de preuves que les contrôles fonctionnent, que les données arrivent de manière fiable, que les incidents sont maîtrisés et que les décisions deviennent plus sûres.
Les huit KPI de Data Governance ci-dessous forment un système de mesure connecté. La couverture montre où la governance existe, l'application montre si les contrôles fonctionnent, la qualité et la Timeliness montrent l'état des données, et les métriques d'incidents, de schéma et d'activité montrent si la governance protège les décisions. Chaque KPI comprend une logique de calcul, des choix de mise en œuvre et des compromis.
Avant de calculer quoi que ce soit, définissez la population d'actifs, le propriétaire, la fenêtre de mesure, le niveau de criticité, le seuil cible et les attentes en matière de réponse aux alertes. Un score sans propriétaire désigné est un rapport. Un score lié à un parcours de remédiation est un contrôle.
Table des matières
5. Temps de détection et de résolution des modifications de schéma
6. Efficacité de la détection d'anomalies des KPI de l'entreprise
7. Taux d'adoption et d'application de la politique de Data Governance
8. Couverture et profondeur de surveillance de la Data Observability
Transformer huit métriques en un rythme opérationnel de governance
1. Score de qualité des données
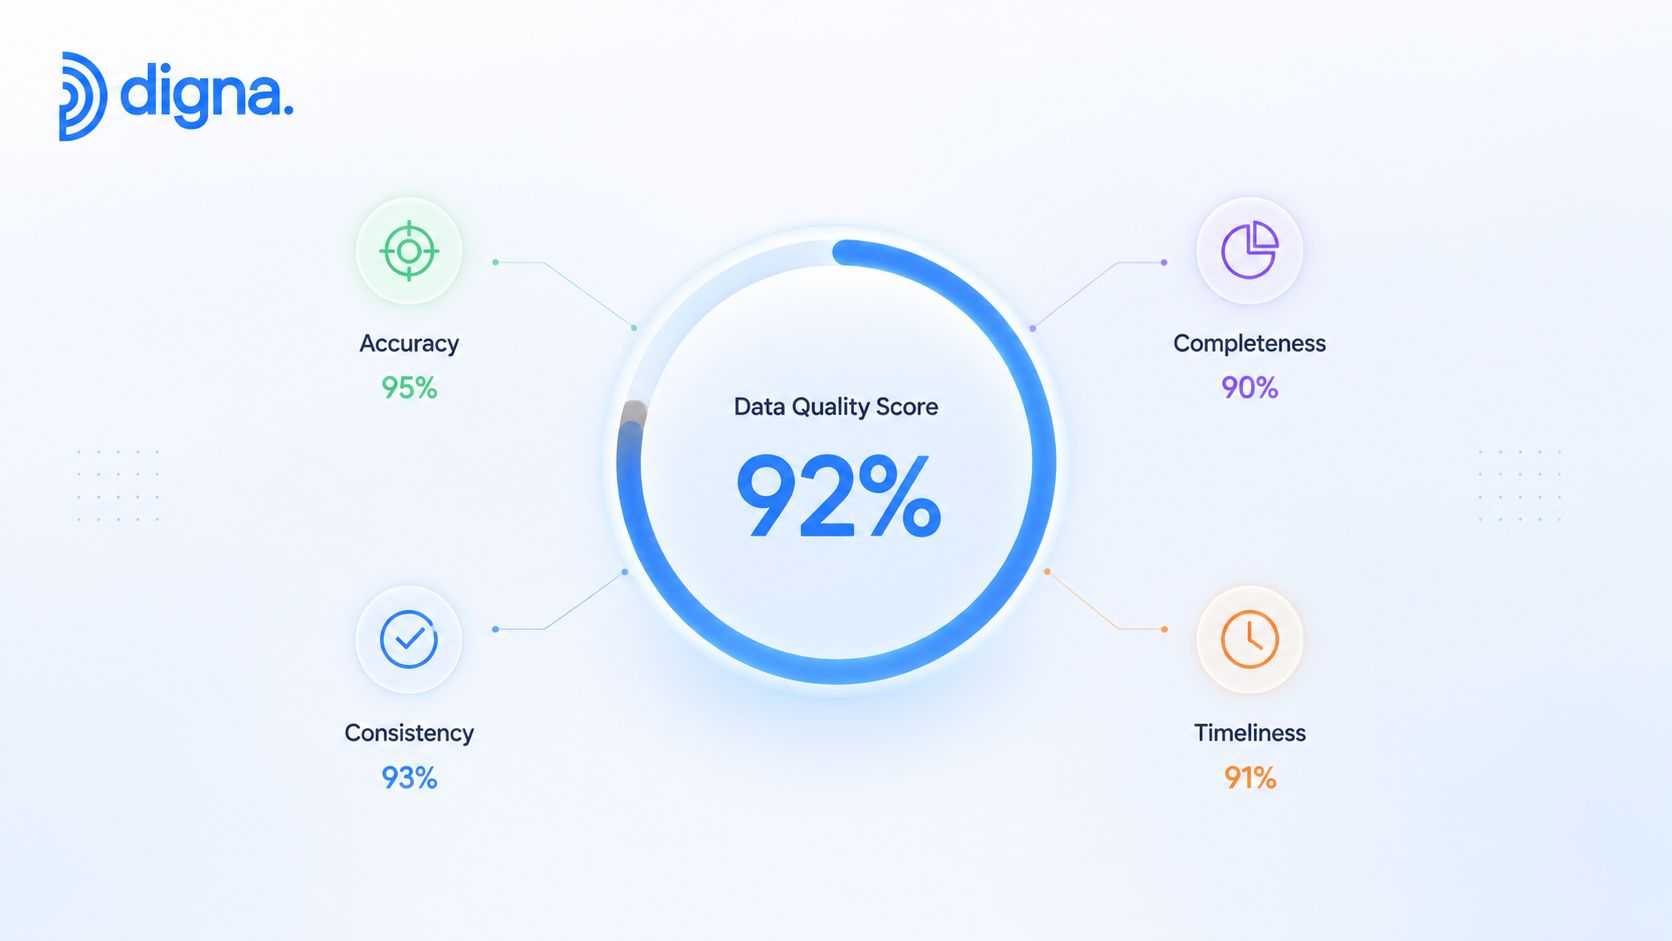
Un Score de qualité des données est le signal de condition dans le système de mesure à huit KPI. La couverture montre où la governance existe, l'application montre si les contrôles fonctionnent, tandis que ce score indique si les données critiques sont adaptées au reporting, aux opérations, à la Compliance ou aux flux de travail d'IA. Les dimensions courantes incluent l'exactitude, l'exhaustivité, la cohérence, la Timeliness et l'unicité. Les équipes peuvent utiliser le guide sur les métriques de qualité des données pour définir et combiner ces dimensions sans traiter le résultat composite comme un diagnostic.
Un calcul simple est :
Score de qualité des données = somme des scores de dimension multipliée par leurs coefficients attribués
Les coefficients doivent correspondre à l'utilisation de chaque ensemble de données. Un rapport réglementaire peut accorder plus d'importance à la validité et à l'exhaustivité, tandis qu'un tableau de bord opérationnel en temps quasi réel peut donner la priorité à la fraîcheur. Un score d'entreprise partagé améliore la comparaison, mais les scores spécifiques à chaque jeu de données conservent le contexte nécessaire pour identifier les propriétaires et le travail de remédiation.
Construire le score autour des actifs critiques
Commencez par un groupe défini d'ensembles de données critiques au lieu de noter l'ensemble du patrimoine. Pour chaque actif, documentez les dimensions mesurées, les règles de validation, le profil d'anomalie de référence, les attentes en matière de Timeliness, le propriétaire et le chemin d'escalade. Donnez la priorité aux données liées au reporting, à la Compliance, aux opérations clients ou aux flux de travail d'IA, puis étendez la couverture une fois le processus de mesure stabilisé.
Le score doit exposer le risque opérationnel, et non le masquer. Un résultat d'exhaustivité inférieur peut refléter un changement planifié du système source, une défaillance de pipeline sans propriétaire ou un défaut récurrent en amont. Ces causes nécessitent des réponses différentes, c'est pourquoi il convient d'associer le contexte de l'incident et les résultats au niveau des dimensions à la vue de direction.
Règle pratique : Un score composite doit déclencher une enquête, et non la remplacer.
Les conseils de digna sont pertinents lorsque les équipes combinent les résultats de validation, les signaux d'anomalie et les observations de Timeliness tout en maintenant le calcul au sein de leur propre environnement. L'exécution en base de données peut également réduire le besoin de déplacer des données sensibles en dehors des infrastructures approuvées.
2. Taux de réussite de la Data Validation
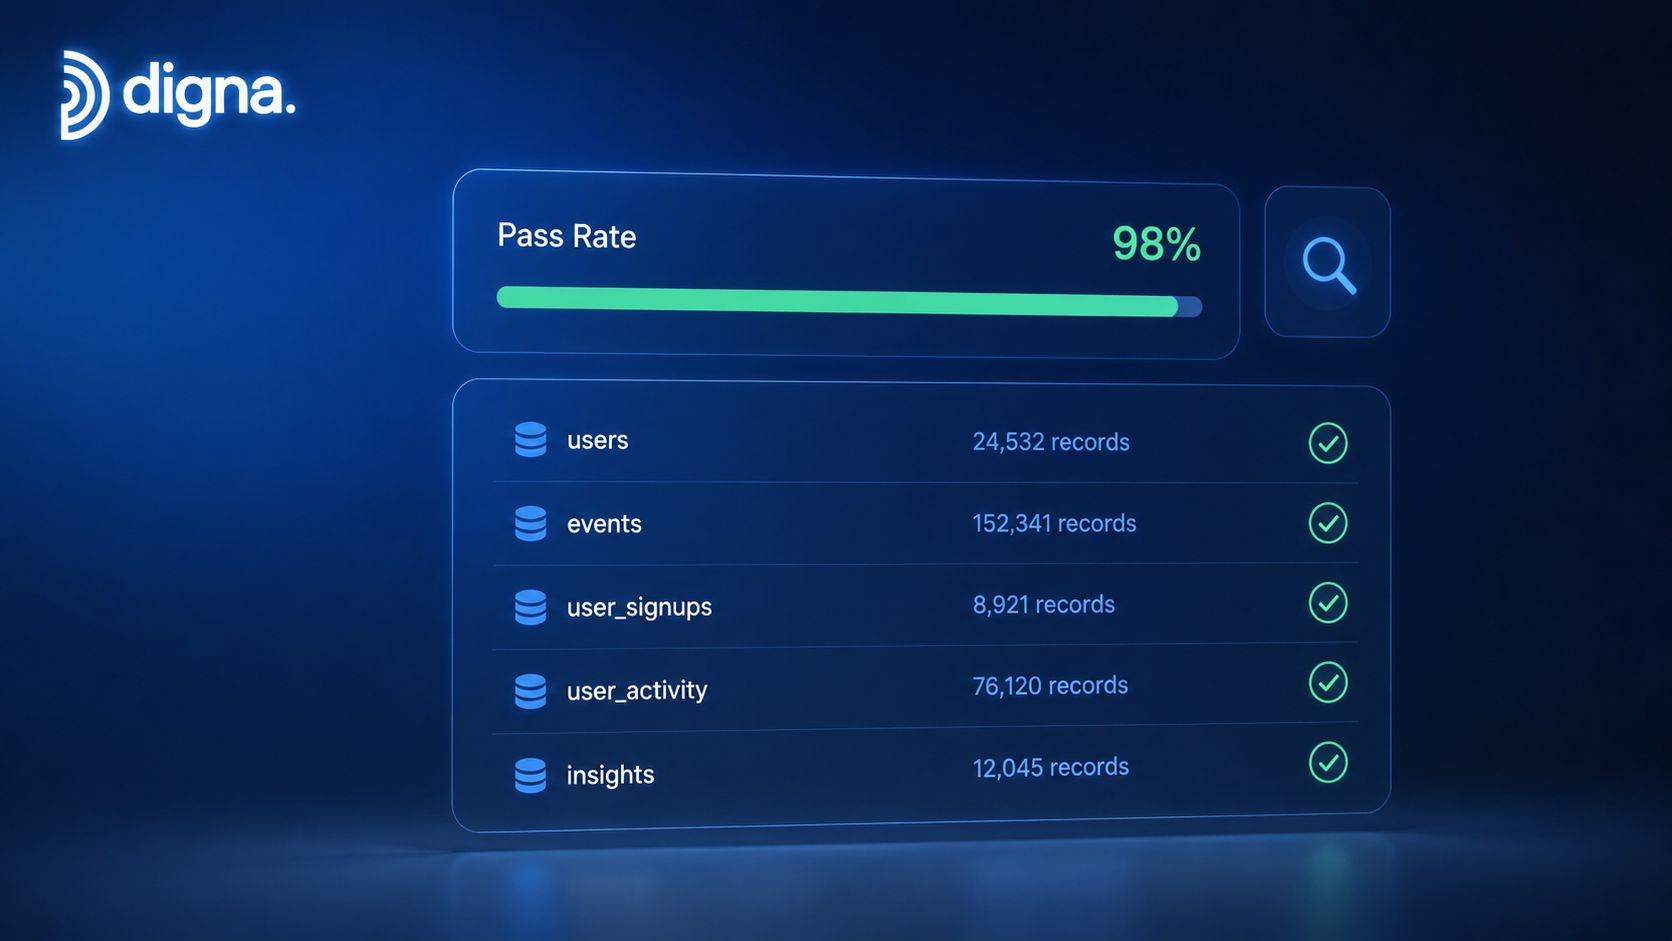
Un Taux de réussite de la Data Validation indique si les règles régies s'appliquent aux enregistrements réels. Il mesure la part des enregistrements qui réussissent les contrôles métier et structurels définis au cours d'une période donnée, reliant ainsi les exigences de politique à la performance des contrôles.
Taux de réussite de la validation = enregistrements réussissant tous les contrôles applicables divisés par le total des enregistrements évalués, multiplié par 100
Calculez le KPI au niveau de la règle, de l'ensemble de données et du domaine. Le taux agrégé indique l'application globale, tandis que les résultats au niveau de la règle identifient les échecs impliquant des adresses, des identifiants, des dates, des relations financières ou d'autres champs. Étant donné qu'un seul enregistrement peut échouer à plusieurs contrôles, signalez les enregistrements affectés séparément du nombre total d'échecs de règles. Cette distinction évite que des échecs répétés dans un petit groupe d'enregistrements ne faussent l'image opérationnelle.
Rendre les échecs explicables
Donnez la priorité aux règles liées au reporting, à la Compliance, aux entrées d'IA ou à la prestation de services. Les contrôles déterministes permettent une comparaison cohérente, mais les comptes agrégés sont insuffisants. Examinez des échantillons d'enregistrements ayant échoué et classez la cause, telle qu'une erreur de configuration en amont, une définition de source modifiée ou un processus qui autorise des valeurs invalides.
Le risque lié au cas d'utilisation doit fixer la tolérance. Les contrôles du reporting financier exigent généralement des limites plus strictes que l'analyse exploratoire. La validation du schéma peut être calculée comme suit : enregistrements réussissant les contrôles de schéma divisés par le total des enregistrements. Les benchmarks de KPI de Data Governance publiés décrivent des objectifs supérieurs à 99,5 % et considèrent les résultats inférieurs à 98 % comme un signal d'alarme, mais ces seuils nécessitent des ajustements en fonction de la criticité des données et de la portée des règles.
Les règles et contrôles de Data Validation de digna prennent en charge les tests au niveau de l'enregistrement par rapport à la logique métier et aux exigences d'audit. Associez le taux de réussite à la propriété des règles, au nombre d'enregistrements ayant échoué et au temps de résolution. Un taux élevé sans examen des échecs peut refléter la faiblesse des contrôles plutôt que la bonne santé des données.
3. Conformité aux SLA de Timeliness des données
Des données tardives peuvent invalider une décision par ailleurs exacte. La Conformité aux SLA de Timeliness des données mesure si les livraisons attendues arrivent dans le délai convenu, associant ainsi la fiabilité des pipelines à la fraîcheur des tableaux de bord, aux flux de travail opérationnels et à la latence des décisions. Elle forme la couche de condition du système de KPI : la couverture montre où la governance existe, l'application montre si les contrôles fonctionnent et la Timeliness montre si les données régies sont utilisables lorsque les décisions l'exigent.
Conformité au SLA de Timeliness = livraisons de données disponibles à temps divisées par le total des livraisons attendues, multiplié par 100
Calculez le numérateur à partir des enregistrements de livraison horodatés. Incluez toutes les livraisons attendues dans le dénominateur, y compris les chargements manquants. Exclure les données manquantes fait paraître la performance plus solide précisément au moment où le pipeline échoue.
Régler l'horloge autour des besoins de l'entreprise
Définissez le SLA en fonction des besoins en aval, et non des performances actuelles du pipeline. Un résultat clinique requis pour un flux de sortie d'hôpital a une urgence différente d'un extrait de planification mensuel. Prenez en compte les fins de mois, de trimestre, les jours fériés, les fenêtres de maintenance et autres variations de calendrier avant de signaler un retard.
Un benchmark publié recommande au moins 98 % de Timeliness pour les données opérationnelles critiques (définition et formule du KPI de Timeliness). Une autre référence de governance place le respect des SLA de fraîcheur au-dessus de 99 % et traite les scores inférieurs à 95 % comme un signal d'alarme. Ces chiffres sont des points de repère, pas des objectifs universels. Le seuil approprié dépend des conséquences pour l'activité, de la fréquence des livraisons et du coût des données tardives.
L'approche de surveillance de la Timeliness des données de digna utilise des modèles de livraison attendus pour identifier les retards, les chargements manquants et les arrivées anticipées. Corrélez les SLA manqués avec le temps d'exécution des tâches, la profondeur de la file d'attente, la disponibilité des sources et les événements d'infrastructure. Cette analyse distingue un défaut de pipeline d'une contrainte liée à l'environnement d'exploitation, offrant ainsi aux propriétaires un chemin de remédiation plus clair.
4. Taux de détection des incidents de données critiques
Un programme de governance ne peut pas réduire les incidents qu'il ne détecte jamais. Le taux de détection des incidents de données critiques mesure le nombre d'anomalies, d'échecs de qualité et de modifications de schéma pertinents détectés par la surveillance dans une fenêtre de réponse définie.
La formule de base est :
Taux de détection = incidents critiques détectés dans la fenêtre cible divisés par les incidents critiques identifiés par toutes les preuves disponibles, multiplié par 100
La partie difficile réside dans le dénominateur. Les équipes peuvent découvrir des incidents grâce à la surveillance, aux plaintes des utilisateurs, aux rapports défaillants, aux examens d'audit ou aux rapprochements en aval. Ces canaux de découverte doivent être réconciliés afin que le KPI ne récompense pas un système de surveillance qui ne signalerait que ses propres alertes.
Mesurer le signal, pas le volume d'alertes
Commencez par les ensembles de données à fort impact et définissez ce qui est considéré comme critique. Un changement soudain de distribution dans un ensemble de données réglementaire peut nécessiter une escalade immédiate, alors qu'une fluctuation saisonnière dans une table exploratoire peut ne pas le nécessiter. Suivez la latence de détection, les faux positifs et le parcours menant de l'alerte au ticket. Détecter sans preuve de réponse ne représente qu'une protection partielle.
Les capacités de détection d'anomalies de digna combinent l'apprentissage de base avec la validation et le suivi de schéma. Cette combinaison est essentielle car un incident visible pour l'entreprise peut provenir d'une distribution de valeurs, d'une violation de règle ou d'un changement de structure.
Une équipe de surveillance devrait poser deux questions pour chaque incident : « L'avons-nous détecté assez tôt ? » et « Le bon propriétaire a-t-il agi ? »
Examinez régulièrement les profils de faux positifs. Les événements saisonniers connus, les migrations planifiées et les comportements de batch récurrents doivent guider l'ajustement du profil de référence. L'objectif n'est pas de maximiser le nombre d'alertes. Il s'agit de faire remonter les défaillances lourdes de conséquences suffisamment tôt pour éviter les rapports corrompus, les modèles défaillants ou les résultats réglementaires non fiables.
5. Temps de détection et de résolution des modifications de schéma
Les modifications de schéma peuvent créer des défaillances que les contrôles de qualité ordinaires ne détectent pas. Une colonne supprimée ou un type incompatible peut bloquer un pipeline, tandis qu'une modification de champ facultatif peut passer inaperçue et modifier la logique en aval sans alerte immédiate. Le Temps de détection et de résolution des modifications de schéma mesure le temps écoulé entre la détection d'une modification structurelle et sa prise en compte confirmée par les consommateurs en aval.
Temps de résolution = horodatage de la prise en compte confirmée en aval moins horodatage de la détection de la modification
Suivez séparément les temps de résolution moyen, médian et le pire des cas. La moyenne résume la performance globale, la médiane indique la vitesse de fonctionnement typique et le maximum expose le risque d'escalade. N'arrêtez le chronomètre qu'une fois la prise en compte en aval confirmée, et non lorsque quelqu'un accuse réception d'une alerte ou crée un ticket.
Classifier les changements avant qu'ils ne surviennent
Un guide de procédures devrait séparer les modifications urgentes de celles adaptées à un examen planifié. La suppression d'une colonne, les modifications de types incompatibles et les modifications de la sémantique des clés nécessitent généralement une escalade rapide. Les nouvelles colonnes facultatives peuvent entrer dans une file d'attente d'examen lorsqu'elles n'affectent pas les contrats en aval.
La propriété et le lignage raccourcissent les investigations, car les ingénieurs peuvent identifier les consommateurs affectés sans avoir à reconstruire les dépendances lors d'un incident. Enregistrez la signification des colonnes, la propriété de la source, la logique de transformation et l'utilisation en aval. Coordonnez les modifications planifiées avec le contrôle de version pour les transformations SQL, dbt et Python.
Le guide de surveillance et d'explication de dérive de schéma de digna couvre le suivi des colonnes ajoutées ou supprimées ainsi que les modifications de types de données. Le KPI doit donc tester plus que la simple couverture de détection. Il doit montrer si chaque modification matérielle a atteint le bon propriétaire et a été prise en compte en toute sécurité, reliant l'application de la governance à la fiabilité du pipeline et au risque lié aux décisions.

6. Efficacité de la détection d'anomalies des KPI de l'entreprise
Les scores de qualité technique ne protègent les décisions que s'ils révèlent si les métriques de l'entreprise restent dignes de confiance. L'efficacité de la détection d'anomalies des KPI d'entreprise mesure la part des changements significatifs dans les métriques importantes qui sont détectés, expliqués et remontés avec une latence acceptable.
Efficacité = changements d'activité significatifs détectés et correctement remontés divisés par les changements significatifs confirmés par examen, multiplié par 100
Le dénominateur nécessite un processus d'examen documenté. Classez chaque alerte examinée comme une véritable évolution de l'activité, un problème de qualité des données, un problème de pipeline ou un faux positif. Ces étiquettes relient les résultats de l'entreprise aux métriques de qualité des données sous-jacentes, tout en fournissant aux analystes des preuves pour ajuster les seuils et réduire les investigations superflues.
Définir le terme « significatif » avec les décideurs
Les dirigeants peuvent donner la priorité aux revenus, à l'activité client, au volume de transactions ou à l'efficacité opérationnelle. Les équipes de données peuvent surveiller les tables sources et les transformations qui produisent ces mesures. Le contrôle n'est efficace que si les deux points de vue se rejoignent : une alerte doit identifier la métrique, le contexte historique, les modifications de données associées et le responsable de l'investigation.
La fonctionnalité Business Monitoring de digna prend en charge l'analyse des métriques d'activité et opérationnelles. Son module de Data Analytics peut aider les équipes à examiner la volatilité historique et la saisonnalité avant de définir les niveaux de sensibilité. Cela est essentiel pour les métriques affectées par des profils calendaires, des cycles promotionnels ou des dates limites de reporting, où un seuil fixe peut générer des faux positifs répétés.
L'alerte d'anomalie d'entreprise la plus performante aide un décideur à déterminer si c'est l'activité qui a changé ou si ce sont les données.
Examinez régulièrement les résultats. Comparez les résultats de détection et d'escalade par métrique, domaine d'activité et catégorie de cause. Un score en baisse peut indiquer une faible couverture de surveillance, tandis qu'un volume d'alertes élevé avec peu d'anomalies confirmées peut indiquer des seuils inadaptés. Lier les étiquettes aux incidents sources, aux événements de schéma et aux échecs de validation transforme ce KPI d'un simple compte d'alertes en une preuve que la governance protège les décisions opérationnelles.
7. Taux d'adoption et d'application de la politique de Data Governance
Une politique documentée n'a qu'une valeur limitée tant qu'un contrôle ne la teste pas et que personne n'agit sur les exceptions. Ce KPI mesure l'étendue de la mise en œuvre des politiques approuvées par le biais de la surveillance, de la validation, des contrôles d'accès, des vérifications de Timeliness, des contrôles de schéma ou d'autres mécanismes.
Taux d'application = politiques associées à des contrôles actifs et testés divisées par le total des politiques définies, multiplié par 100
Définissez le dénominateur avant de mesurer les progrès. Incluez les normes formelles et les règles opérationnelles documentées, tout en séparant les politiques approuvées des orientations ambitieuses. Sinon, l'ajout de politiques peut faire baisser le taux alors même que la couverture des contrôles s'améliore.
Mesurer la maturité de l'automatisation
Un benchmark a révélé que 61 % des organisations avaient des politiques en place, mais que seulement 38 % disposaient d'une application automatisée (governance maturity benchmark). Cet écart fait des décomptes de politiques une preuve fragile. Une politique peut exister dans un document sans vérification système, sans propriétaire responsable, ni parcours d'exception actionnable.
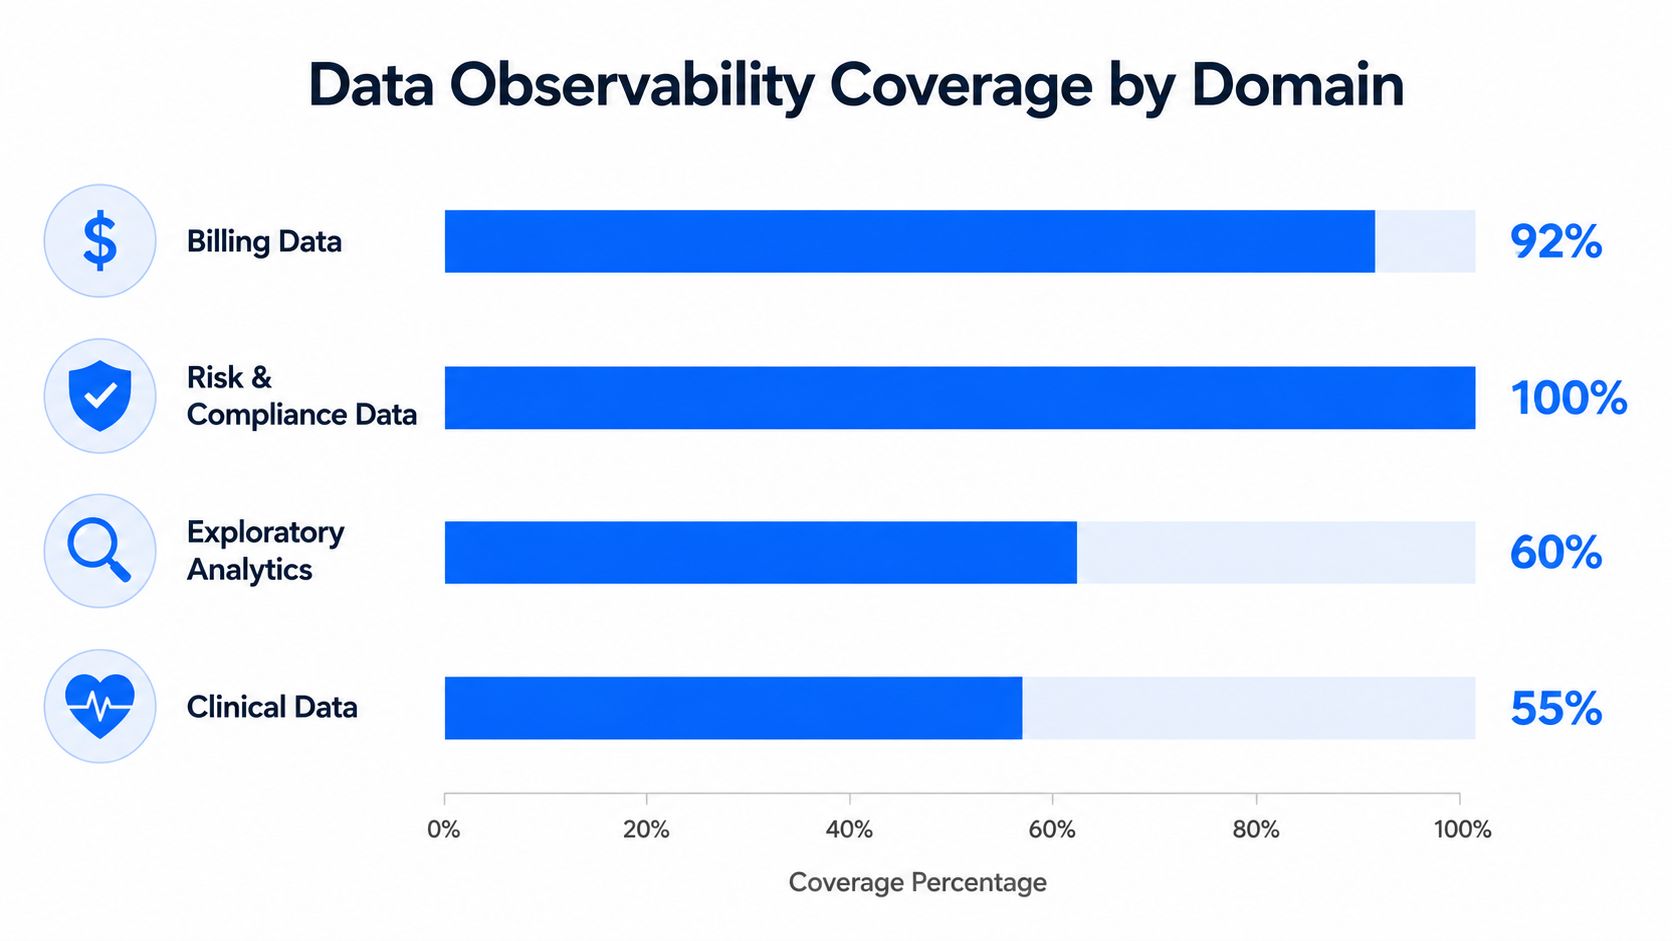
Associez chaque politique à son contrôle, à la portée de son ensemble de données, à son propriétaire, à la fréquence de ses tests, à son processus d'exception et à l'emplacement de ses preuves. Signalez les résultats par domaine et par niveau de risque, et non uniquement sous forme de moyenne d'entreprise. Une organisation de santé, par exemple, peut constater que les contrôles de facturation s'effectuent automatiquement tandis que les contrôles cliniques restent manuels.
La surveillance de la Timeliness fournit également des preuves d'application. Vérifier si les données respectent les niveaux de service convenus permet de confirmer qu'une politique fonctionne en production, plutôt que de simplement figurer dans la documentation. Voir les conseils sur les définitions, métriques et surveillance de la Timeliness des données.
L'adoption comprend le comportement après détection. Suivez l'accusé de réception des alertes, la résolution des exceptions et la conformité des flux de travail. Un contrôle automatisé dont les conclusions sont systématiquement ignorées n'est que partiellement appliqué, associez donc ce KPI aux résultats des incidents et aux mesures d'impact sur l'activité.
8. Couverture et profondeur de surveillance de la Data Observability
La couverture montre où la governance existe, tandis que la profondeur de surveillance montre si elle peut protéger les décisions. Mesurez la part des tables critiques, des pipelines et des métriques d'activité sous surveillance active.
Couverture de l'Observability = actifs critiques surveillés divisés par le total des actifs critiques, multiplié par 100
Un pourcentage de couverture peut masquer une faible protection. Surveiller la complétude d'une seule table offre moins de contrôle que de surveiller une autre table pour sa complétude, sa Timeliness, ses anomalies et ses changements de schéma. Signalez à la fois la part d'actifs surveillés et le nombre ainsi que le type de contrôles actifs par actif.
Séparer la largeur de la protection
Faites l'inventaire du warehouse, du lake, des pipelines et des métriques de l'entreprise. Classez chaque actif selon son lien avec les décisions, les obligations de Compliance, les accords de niveau de service (SLA) et le risque opérationnel. Donnez la priorité aux lacunes dont la défaillance pourrait perturber le reporting, le travail réglementaire ou les opérations.
Les objectifs de référence peuvent inclure environ 90 % de couverture de catalogue et 95 % de couverture de lignage ou de politique, avec 100 % d'achèvement des revues d'accès pour un programme mature. Ces chiffres guident la planification plutôt qu'ils ne définissent des exigences universelles. Un jeu de données de risque réglementé peut justifier une surveillance complète, tandis qu'un actif exploratoire à faible risque peut nécessiter moins de profondeur.
Utilisez l'historique des incidents, les obligations de Compliance et les priorités de l'entreprise pour définir la profondeur de la surveillance. Un score de couverture élevé associé à des contrôles superficiels peut créer une fausse assurance, tandis que des contrôles plus approfondis sur les actifs les plus importants peuvent réduire le risque de décision plus efficacement qu'une surveillance uniforme.
La solution de Data Platform Observability de digna surveille les charges de travail de données, la consommation, la disponibilité, les mesures liées à la performance et les modifications. Son modèle d'exécution en base de données peut aider les équipes à étendre la surveillance sans déplacer les données de production en dehors de leur environnement.
Comparaison des KPI de Data Governance en 8 points
Métrique | Complexité de mise en œuvre 🔄 | Besoins en ressources ⚡ | Résultats attendus 📊 | Cas d'utilisation idéaux 💡 | Principaux avantages ⭐ |
|---|---|---|---|---|---|
Score de qualité des données | 🔄 Moyenne, nécessite une logique de pondération et une agrégation selon les dimensions | ⚡ Modérée, règles de validation, détection d'anomalies, stockage historique | 📊 Score unifié de santé des données pour le benchmarking et le suivi des tendances | 💡 Reporting de direction, suivi des SLA, comparaisons entre unités | ⭐ Simplifie le reporting ; priorise la remédiation |
Taux de réussite de la Data Validation | 🔄 Moyenne, nécessite une conception et un ajustement minutieux des règles | ⚡ Élevée, contrôles au niveau de l'enregistrement et maintenance continue des règles | 📊 Métrique d'application précise avec rapports détaillés sur les échecs | 💡 Audits de Compliance, validation en amont, corrections ciblées | ⭐ Prêt pour l'audit, preuves d'échec exploitables |
Conformité aux SLA de Timeliness des données | 🔄 Faible à moyenne, nécessite un apprentissage de référence et une intégration des calendriers | ⚡ Modérée, pipelines de surveillance et systèmes d'alerte | 📊 % de livraisons à temps ; avertissement précoce pour les chargements tardifs/manquants | 💡 Surveillance des SLA de pipeline, fraîcheur des tableaux de bord, SLA opérationnels | ⭐ Automatise le suivi des SLA ; quantifie la fiabilité des pipelines |
Taux de détection des incidents de données critiques | 🔄 Élevée, profil de référence IA + intégration avec les systèmes d'incidents | ⚡ Élevée, détection continue des anomalies et alertes | 📊 Détection plus rapide (MTTD réduit) ; fait remonter les problèmes connus et inconnus | 💡 Analyses de production, surveillance des modèles, domaines de données à haut risque | ⭐ Détection précoce des anomalies ; réduit l'impact des interruptions |
Détection des changements de schéma et temps de résolution | 🔄 Faible à moyenne, suivi continu + guides de procédures pour la réponse | ⚡ Faible à modérée, surveillance des schémas et outils d'analyse d'impact | 📊 Métrique du temps de résolution ; prévient les défaillances silencieuses en aval | 💡 Environnements avec dérive de schéma fréquente ou nombreuses intégrations | ⭐ Détection immédiate ; visibilité de l'impact et piste d'audit |
Efficacité de la détection d'anomalies des KPI de l'entreprise | 🔄 Élevée, nécessite des définitions de KPI et un réglage précis | ⚡ Élevée, profils IA, analyse multidimensionnelle, indices de cause racine | 📊 % de changements d'activité significatifs détectés et contextualisés | 💡 Tableaux de bord de direction, suivi des revenus/volumes, alertes opérationnelles | ⭐ Alertes axées sur l'activité avec indices contextuels de cause racine |
Taux d'adoption et d'application des politiques | 🔄 Moyenne, mise en correspondance politique-surveillance et flux d'exceptions | ⚡ Modérée, gestion des politiques, journalisation d'audit, approbations | 📊 % de politiques opérationnalisées ; indicateur de maturité de la governance | 💡 Programmes de governance, rapports de Compliance, gestion des risques | ⭐ Indique le contrôle opérationnel ; priorise les lacunes d'application |
Couverture d'Observability et profondeur de surveillance | 🔄 Élevée, découverte automatisée et configuration de surveillance multicouche | ⚡ Élevée, inventaire, profils de référence, tableaux de bord sur différentes couches | 📊 Ratio de couverture et métriques de profondeur pour identifier les angles morts | 💡 Grandes plateformes de données, planification de la maturité de l'observability | ⭐ Quantifie la maturité de la surveillance ; guide l'investissement dans la couverture |
Transformer huit métriques en un rythme opérationnel de governance
Ces huit KPI fonctionnent au mieux en tant que système, et non comme un inventaire de chiffres sans lien. La couverture vous indique si les actifs critiques sont visibles. L'application des politiques vous indique si les normes écrites fonctionnent dans les flux de travail réels. La qualité et la validation indiquent si les enregistrements sont adaptés à l'usage. La Timeliness montre si les données arrivent lorsque les décisions l'exigent. La détection d'incidents et la résolution de schéma révèlent la rapidité avec laquelle l'organisation réagit au changement. L'efficacité des anomalies de l'entreprise relie la surveillance technique aux résultats que gèrent les dirigeants.
Commencez par établir un profil de référence sur les actifs critiques. Enregistrez les dimensions de qualité actuelles, les résultats de validation, les performances de livraison, la couverture de la surveillance, les contrôles de politique, les parcours d'incidents et les résultats des alertes de métriques d'activité. Évitez de modifier la cible tout en modifiant la méthode de mesure. Une tendance n'est utile que si la population, la formule et la fenêtre d'observation restent compréhensibles.
Attribuez un propriétaire à chaque KPI et à chaque actif critique. Le propriétaire doit avoir l'autorité nécessaire pour enquêter, approuver des exceptions, coordonner la remédiation et confirmer la clôture. Cela répond à un problème central de governance identifié dans une enquête de 2025, où 47 % des personnes interrogées ont cité le manque de clarté de la propriété et de la responsabilité comme le principal obstacle à l'extension de la governance (2025 data governance survey). Un tableau de bord peut exposer un problème, mais seules des personnes responsables peuvent le résoudre.
Définissez des seuils en fonction de l'impact sur l'activité. Utilisez des contrôles plus stricts pour les données qui alimentent le reporting réglementaire, les opérations sur les patients, le risque financier ou les décisions clients à fortes conséquences. À titre de référence, les cadres publiés incluent des objectifs tels que au moins 90 % de couverture du catalogue, au moins 95 % de couverture des politiques, un MTTR inférieur à quatre heures et 100 % de réussite pour les revues d'accès trimestrielles (data governance metrics framework). Traitez ces éléments comme des données de conception, puis validez-les par rapport aux besoins réels de service et à la capacité de réponse.
Examinez différents signaux à différents rythmes. Les ingénieurs et les gestionnaires de données ont besoin de vues fréquentes sur les validations ayant échoué, les livraisons manquées, les incidents ouverts, les faux positifs et les modifications de schéma. Les leaders de la governance ont besoin de tendances en matière de couverture, d'application, de qualité et de remédiation. Les dirigeants ont besoin d'un lien concis entre les contrôles de données et les résultats de l'entreprise. Cette distinction est importante car 39 % des leaders des données ont déclaré avoir des difficultés à démontrer l'impact de la governance à leur direction, tandis que 85 % des cadres supérieurs des données et de l'analyse ont donné la priorité aux améliorations de la governance pour se préparer à l'IA (2025 state of enterprise data governance report).
Aucun KPI ne prouve à lui seul la santé de la governance. Un score de qualité élevé peut coexister avec des angles morts. Une large couverture peut coexister avec une faible application. Une détection rapide peut coexister avec une remédiation lente. Construisez le tableau de bord pour que chaque mesure réponde à une question opérationnelle différente, et associez chaque alerte à des preuves de propriété, d'action et de résolution confirmée.
digna est une option pour les équipes qui ont besoin d'une surveillance sur la qualité, la Timeliness, les anomalies, la validation, les modifications de schéma, les métriques d'activité et l'observability de la plateforme. Sa plateforme modulaire s'exécute dans l'environnement du client et prend en charge l'exécution en base de données, permettant ainsi aux équipes de conserver les données sur place tout en étendant le système de mesure de la governance.
Utilisez digna pour surveiller les signaux critiques de qualité des données, de Timeliness, de validation, d'anomalie, de schéma et d'observability au sein de votre propre environnement. Visitez digna pour connecter ces contrôles à des propriétaires responsables, à des alertes opérationnelles et à des preuves que la governance fonctionne en production.
Questions fréquentes
Que définir avant de calculer un KPI de gouvernance ?
Six éléments : la population d'actifs, le responsable, la fenêtre de mesure, le niveau de criticité, le seuil cible et l'attente de réponse aux alertes. Sans eux, la même formule produit un nombre différent à chaque exécution.
Comment calcule-t-on un score de qualité des données ?
Comme la somme des scores par dimension multipliés par leurs poids attribués, ces poids reflétant l'usage réel de chaque jeu de données. Commencez par un groupe défini de jeux critiques plutôt que de noter tout le parc, afin que le score expose le risque opérationnel au lieu de le moyenner.
Un score composite remplace-t-il l'investigation ?
Non. Un score composite doit déclencher l'investigation, pas s'y substituer. Son rôle est de signaler qu'une chose a bougé dans un ensemble pondéré de dimensions, et c'est le détail par dimension qui indique où regarder.
Quelle est la diffusion réelle de la gouvernance formelle ?
Un benchmark de gouvernance d'entreprise de 2025 indique que 71 % des organisations mènent un programme formel de gouvernance des données, contre 60 % deux ans plus tôt. Cette progression explique pourquoi la mesure est devenue une question plus difficile que l'adoption.
Pourquoi mesurer huit KPI plutôt qu'un ?
Parce qu'ils forment un système de mesure connecté couvrant qualité, Timeliness, couverture et contrôle. Un chiffre unique ne distingue pas un manque de couverture d'un problème d'état, et ces deux situations appellent des réponses entièrement différentes.



