Format de table ouvert : Iceberg, Delta et Hudi comparés
|
8
minute de lecture

Le conseil le plus répandu au sujet du format de table ouvert consiste à en choisir un qui évite la dépendance à un fournisseur. Ce conseil est incomplet. La portabilité des fichiers compte, mais le changement plus profond tient à ce que la signification de la table, l'historique transactionnel, l'intention du schéma et les métadonnées de planification des requêtes migrent vers une couche partagée au-dessus des objets du stockage cloud.
Ce basculement transforme un répertoire rempli de fichiers Parquet ou ORC en une table que plusieurs moteurs peuvent découvrir, lire, mettre à jour et faire évoluer. Il crée aussi une responsabilité nouvelle : les métadonnées doivent être gouvernées. Iceberg, Delta Lake et Hudi peuvent faire que le stockage se comporte davantage comme une base de données, mais ils ne décident pas si un snapshot tardif rompt un SLA, si une nouvelle colonne casse un modèle en aval ou si un enregistrement d'apparence valide contient un motif métier anormal.
Ce guide part du modèle conceptuel, compare les trois grands formats, puis suit les métadonnées jusqu'à l'exploitation en production. La question centrale est simple : quelle couche de contrôle maintient une table ouverte digne de confiance une fois le commit réussi ?
Table des matières
Pourquoi les formats de table ouverts changent la donne du lakehouse
Là où les formats de table ouverts cessent de résoudre le problème
Pourquoi les formats de table ouverts changent la donne du lakehouse
Un format de table ouvert n'est pas seulement une manière partagée de lire Parquet sans dépendre d'un fournisseur. Il place la sémantique de table dans des métadonnées qui peuvent résider aux côtés des données dans le stockage objet. Cette sémantique comprend les commits atomiques, les snapshots versionnés, l'évolution de schéma, les informations de partition et les statistiques au niveau des fichiers.
Sans cette couche, le stockage objet vous donne pour l'essentiel des fichiers et des dossiers. Un moteur de requête peut déduire une table à partir d'un répertoire, mais l'arborescence ne répond pas de façon fiable à des questions élémentaires : quels fichiers appartiennent à la version courante, quelle écriture s'est achevée, quel schéma était actif hier, ou quels fichiers peuvent être ignorés sans risque pour un filtre donné.
Les formats de table ouverts répondent à ces questions grâce à des métadonnées partagées. Apache Hudi est né chez Uber en 2016, Databricks a introduit Delta Lake en 2017-2018 et l'a rendu open source en 2019, et Apache Iceberg a vu le jour chez Netflix en 2018 avant de rejoindre l'Apache Software Foundation en 2019. Ces efforts distincts ont convergé vers le même problème : faire que les data lakes se comportent davantage comme des bases de données sans sortir les données du stockage objet (panorama historique des formats de table ouverts).
Des répertoires aux tables à part entière
Le résultat concret est une table qui prend en charge lectures par lots, écritures en streaming, mises à jour et suppressions sur le même stockage. Les moteurs n'ont pas à traiter chaque fichier comme sa propre source de vérité. Ils peuvent résoudre un snapshot cohérent, inspecter les métadonnées et planifier le travail sur le sous-ensemble de fichiers pertinent.
Cela change la conception à plusieurs égards :
Les écritures concurrentes deviennent gérables : un commit peut réussir ou échouer comme un changement de métadonnées complet, sans exposer un état partiel de la table.
Plusieurs moteurs peuvent coopérer : Spark, Trino, Flink, les entrepôts et d'autres lecteurs peuvent utiliser le contrat de métadonnées de la table plutôt que de s'appuyer uniquement sur des chemins physiques.
Les pipelines dépendent moins du moteur : les équipes peuvent séparer la sémantique de stockage du moteur de calcul qui exécute une transformation.
Les tables deviennent des objets de catalogue : propriété, découvrabilité, accès et lignage peuvent s'organiser autour d'une table plutôt que d'un dossier.
Une table Delta, par exemple, contient des fichiers de données et un journal de transactions. Des checkpoints réguliers compactent ce journal afin que les moteurs identifient le snapshot actif et les partitions pertinentes sans énumérer chaque objet, même à très grande échelle (description technique de la conception transactionnelle de Delta Lake).
Règle d'architecture : un format de table ouvert vous donne une description durable de l'état de la table. Il ne vous donne pas automatiquement un contrôle durable sur ce que cet état signifie pour le métier.
Cette distinction compte pour la conception du lakehouse. Un modèle utile de qualité des données dans le lakehouse doit se situer au-dessus des commits de stockage et relier le changement structurel à la propriété, à la validation, à la fraîcheur et à l'impact en aval.
Les primitives essentielles expliquées sans jargon
Voyez le stockage objet comme une grande salle de courrier. Des caisses posées au sol contiennent des fichiers Parquet ou ORC bruts. Les caisses sont durables, mais le sol à lui seul n'indique pas au préposé quelles caisses appartiennent à l'envoi du jour ni si une caisse fraîchement arrivée respecte le format d'enveloppe convenu.
Un format de table ouvert ajoute les registres du préposé. Chaque registre décrit l'état actuel de la table et aide un moteur de requête à trouver les bonnes caisses sans toutes les ouvrir.
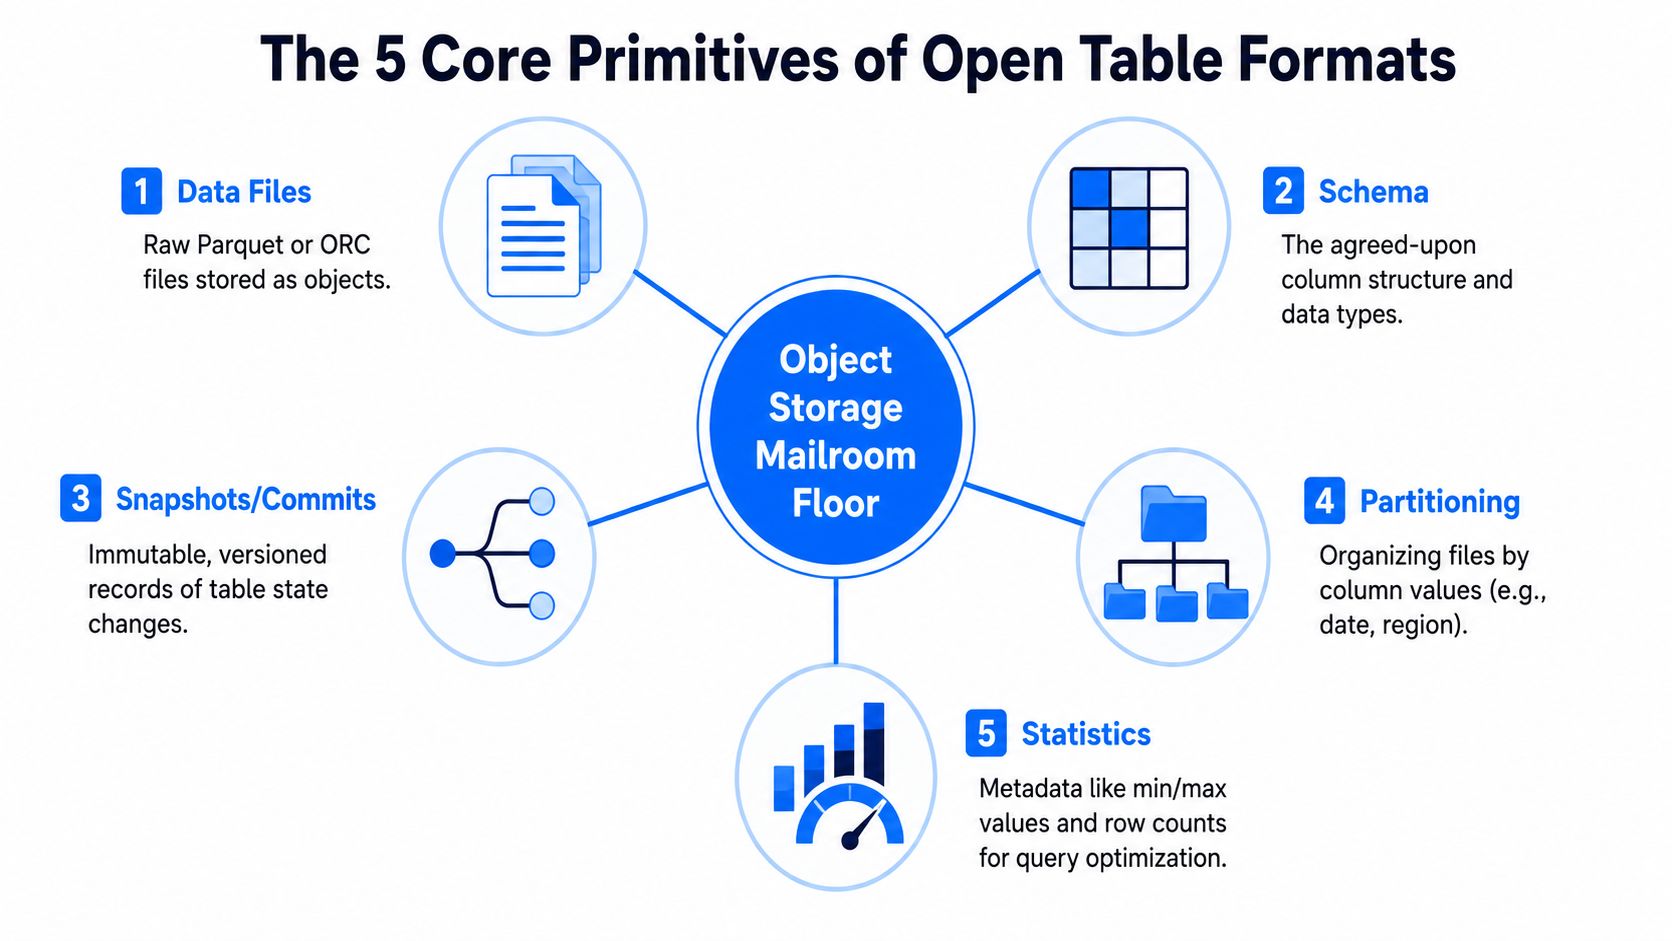
Les cinq registres dont le préposé a besoin
Les fichiers de données sont les caisses au sol de la salle de courrier. Ils contiennent les lignes réelles, généralement dans des formats en colonnes comme Parquet ou ORC. Le rôle de Parquet dans le stockage analytique se distingue de la gestion des tables. Parquet stocke les données efficacement, tandis que le format de table ouvert explique comment ces fichiers composent une table qui évolue.
Le schéma est le règlement de la forme de l'enveloppe. Il définit les noms de colonnes, les types de données et les attentes structurelles. L'évolution de schéma permet à une table de changer au fil du temps sans réécrire immédiatement chaque fichier historique, mais le changement autorisé exige toujours une gouvernance.
Les manifestes sont des inventaires détaillés. Une entrée de manifeste peut indiquer le chemin d'un fichier de données, ses valeurs de partition et les statistiques de colonnes. Dans Iceberg, les fichiers de métadonnées définissent la table, les listes de manifestes définissent les snapshots et les fichiers de manifeste énumèrent les fichiers de données avec des statistiques pour l'élagage (comparatif architectural sur Iceberg).
Les snapshots sont des instantanés des registres. Un lecteur peut interroger la table telle qu'elle existait à un snapshot antérieur et obtenir une réponse cohérente même pendant l'arrivée de nouveaux fichiers. Iceberg utilise des fichiers de métadonnées immuables et un historique de snapshots, chaque commit produisant une nouvelle version de métadonnées (spécification Iceberg).
Les transactions ACID sont les règles de commit du préposé. Une mise à jour de métadonnées devient visible comme opération complète ou n'entre pas dans l'état courant de la table. Cela protège les lecteurs contre la vision d'une demi-écriture et donne aux écrivains un moyen de coordonner les changements.
Pourquoi le partitionnement et les statistiques influent sur les performances
Le partitionnement, c'est l'organisation des rayonnages. Si les lignes sont regroupées selon une valeur qui revient souvent dans les filtres, un moteur peut ignorer des rayonnages entiers. Les statistiques donnent des indices plus fins, comme les valeurs minimale et maximale d'une colonne dans un fichier, afin que le planificateur évite les fichiers dont les plages ne correspondent pas à la requête.
C'est pourquoi les performances dépendent de la planification par métadonnées et pas seulement de la vitesse brute des fichiers. Une table bien organisée permet au moteur de réduire les E/S avant de scanner les données. Une table mal organisée peut rester techniquement correcte et forcer malgré tout de larges scans.
L'évolution de schéma mérite la même prudence. Ajouter une colonne peut être compatible avec les lecteurs existants, mais en supprimer une ou changer un type peut affecter tableaux de bord, modèles et contrats de données. Le format enregistre l'état structurel. Votre plateforme doit toujours décider si un changement proposé est acceptable.
Comment Iceberg, Delta Lake et Hudi sont nés
Iceberg, Delta Lake et Hudi ont grandi dans des équipes distinctes confrontées au même manque architectural : les fichiers dans le stockage objet ne sont pas des tables. Chaque projet a ajouté des métadonnées et un comportement de commit en privilégiant des charges de travail et des environnements d'exploitation différents. Leur histoire est donc une histoire de gouvernance des métadonnées, pas d'agencement des fichiers.
Apache Hudi est né chez Uber en 2016, lorsque les équipes ont eu besoin d'un stockage de lake capable de traitement incrémental et de données mutables. Sa conception s'articule autour des upserts, des suppressions, de l'indexation au niveau des enregistrements et d'une chronologie de commits. Ces choix conviennent aux pipelines qui appliquent de façon répétée des changements venus de systèmes opérationnels.
Databricks a introduit Delta Lake en 2017-2018 et l'a rendu open source en 2019. Delta conserve l'historique transactionnel dans un journal placé à côté des fichiers de données. Des entrées séquentielles en JSON ou Parquet sous _delta_log enregistrent les opérations et permettent aux moteurs de reconstruire l'état de la table et d'interroger des versions antérieures. Ce comparatif architectural d'Iceberg, Delta Lake et Hudi offre un aperçu concis de leurs conceptions.
Netflix a développé Iceberg en 2018 et l'a donné à l'Apache Software Foundation en 2019. Iceberg s'est concentré sur des métadonnées immuables, l'isolation par snapshot, le partitionnement masqué et un accès aux tables neutre vis-à-vis du moteur. Sa structure de métadonnées sépare les définitions de table, les références de snapshots et les manifestes au niveau des fichiers, et prend en charge l'évolution des partitions ainsi que l'élagage des requêtes. Notre présentation du format de table ouvert Apache Iceberg apporte davantage de contexte.
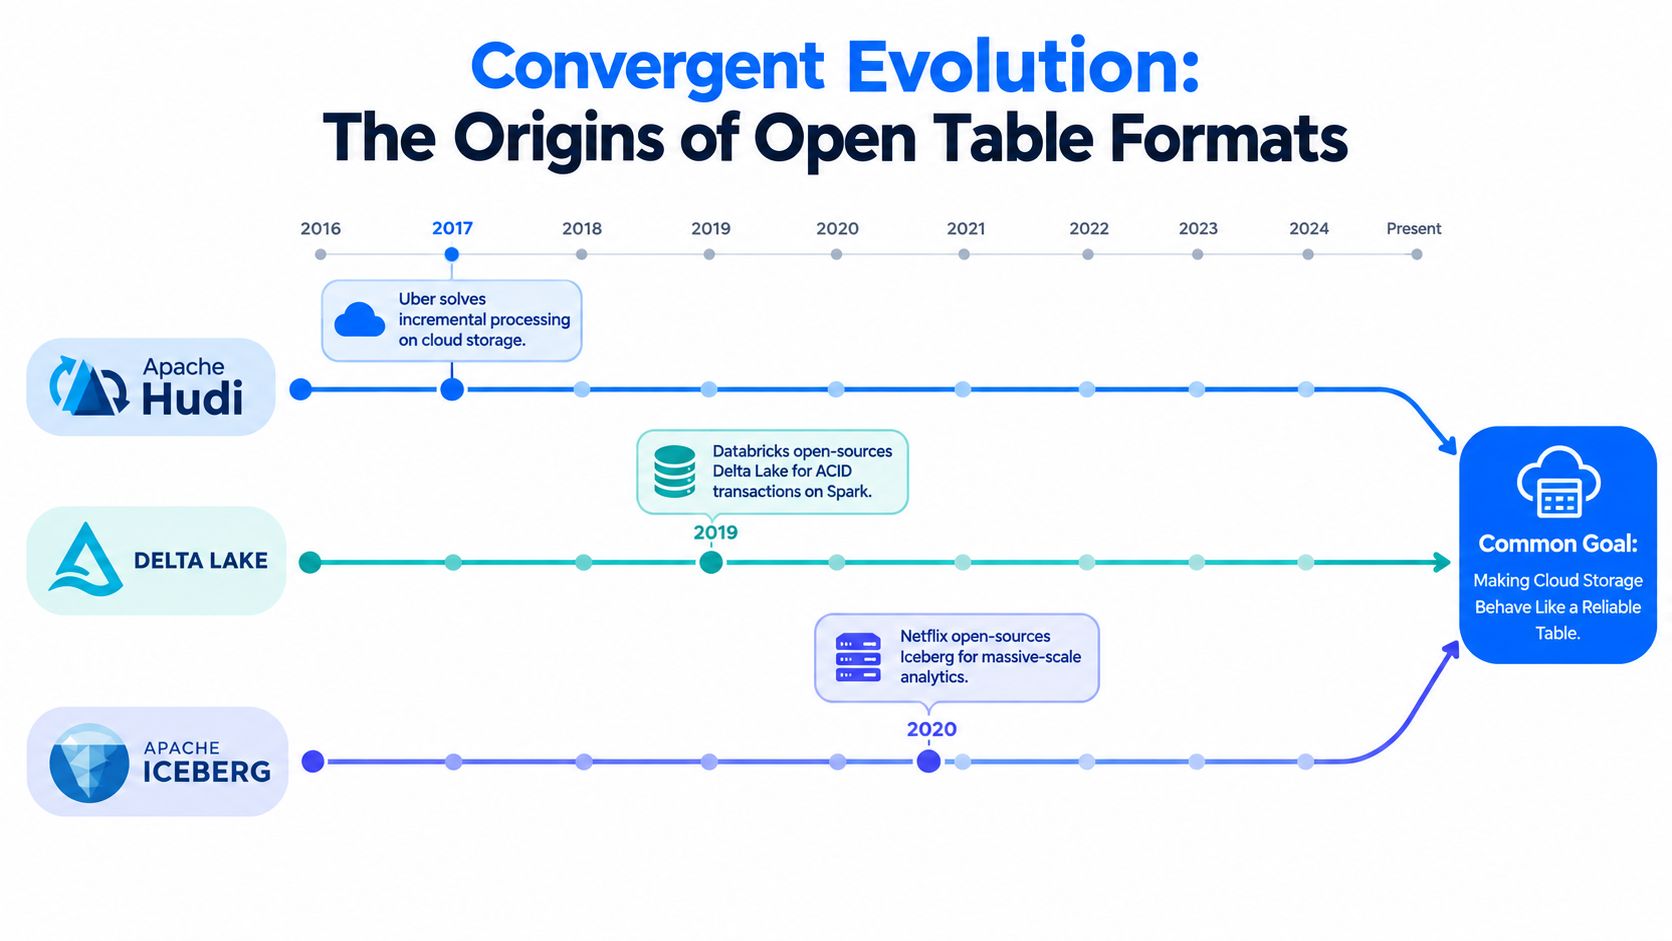
Ces formats ont convergé parce qu'ils traitent le même socle avec des modèles de métadonnées différents. La décision porte sur la façon dont les charges de travail écrivent les données, sur les moteurs qui doivent interopérer, sur la manière dont les catalogues coordonnent l'accès et sur l'équipe qui prend en charge la maintenance des tables.
Cette histoire éclaire aussi le manque opérationnel qui subsiste. Les atouts de Hudi au niveau des enregistrements, l'approche de Delta par journal de transactions et le modèle d'Iceberg fondé sur les manifestes fournissent des primitives de table utiles. Aucun ne définit à lui seul le lignage d'entreprise, les définitions métier, les politiques d'accès, la réponse aux anomalies ou l'approbation des changements. Une couche d'observabilité dans la base de données comme digna peut relier ces contrôles aux changements de schéma, à Timeliness et aux comportements anormaux.
Comparer Iceberg, Delta Lake et Hudi côte à côte
Les architectes de plateforme devraient comparer les formats selon la forme de la charge de travail et le mélange de moteurs, et non selon des promesses de fonctionnalités isolées. Les trois peuvent offrir un comportement de table transactionnel, la gestion du schéma, un historique de versions et une planification de requêtes guidée par les métadonnées. Leurs différences apparaissent mieux dans la façon dont ils représentent l'état et optimisent les écritures.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Modèle de métadonnées | Fichiers de métadonnées immuables, listes de manifestes, manifestes et historique de snapshots | Journal de transactions plat sous | Commits fondés sur une chronologie, avec métadonnées et structures d'index pour les changements d'enregistrements |
Style de partitionnement | Partitionnement masqué et transformations de partition, l'évolution des partitions étant traitée comme un changement de métadonnées | Colonnes de partition, plus agencement et fonctions d'optimisation propres à l'écosystème | Colonnes de partition, index au niveau des enregistrements et organisation assistée par le moteur pour les charges mutables |
Évolution de schéma | Métadonnées explicites de schéma et de partition, avec une évolution qui ne lie pas les requêtes aux colonnes physiques de partition | Métadonnées de schéma et de transaction gérées via le protocole Delta et les contrôles de plateforme environnants | Le schéma et la chronologie des commits portent les changements pour les pipelines d'ingestion et à fortes mises à jour |
Garanties de concurrence | Commits fondés sur les snapshots et isolation via des versions de métadonnées immuables | Commits via le journal de transactions et coordination optimiste autour de l'état de la table | Commits de chronologie, conçus pour les insertions, mises à jour et suppressions |
Adéquation à l'écosystème | Option solide pour les environnements à moteurs hétérogènes et les architectures orientées catalogue | Choix naturel pour les plateformes centrées sur Databricks et Spark, avec une interopérabilité plus large selon la prise en charge du protocole | Option solide pour l'ingestion riche en upserts, le traitement incrémental et les charges qui profitent de l'indexation au niveau des enregistrements |
Apache Iceberg
Iceberg séduit souvent quand de nombreux moteurs doivent partager des tables et que les colonnes physiques de partition ne devraient pas remonter dans la logique de requête. Le partitionnement masqué laisse le format gérer les transformations pendant que les requêtes se réfèrent à des colonnes logiques. Sa spécification prend aussi en charge l'évolution des partitions comme un changement de métadonnées seul, qui ne réécrit pas immédiatement les fichiers de données existants (documentation Iceberg).
La contrepartie est l'entretien des métadonnées. Les fichiers de manifeste et les structures de snapshots fournissent de riches informations de planification, mais les tables petites ou très souvent modifiées peuvent accumuler des métadonnées qui exigent une maintenance délibérée. Iceberg convient bien lorsque l'interopérabilité, l'évolution des partitions et une gouvernance orientée snapshots pèsent plus que la simplicité d'une pile mono-fournisseur.
Delta Lake
Le journal de transactions de Delta est facile à appréhender pour les équipes qui exploitent déjà Spark et Databricks. Le journal consigne les actions sur la table, et les checkpoints rendent la reconstruction de l'état plus efficace à grande échelle. Cette intégration peut raccourcir le chemin entre des pipelines Spark existants et des tables de lakehouse transactionnelles.
La limite honnête est le couplage. Delta fonctionne dans l'écosystème élargi, mais l'expérience la plus fluide dépend souvent des protocoles, runtimes, catalogues et pratiques d'optimisation de Databricks. Une plateforme qui attend de moteurs indépendants qu'ils écrivent et gouvernent les mêmes tables devrait valider ces chemins plutôt que de déduire la compatibilité de l'agencement des fichiers.
Apache Hudi
Hudi excelle dans les pipelines de capture de changements et les tables mutables. Son approche d'indexation au niveau des enregistrements peut diriger mises à jour et suppressions vers les groupes de fichiers appropriés, réduisant le besoin de recherches étendues pour localiser les enregistrements ciblés. Cet atout s'accompagne de davantage de concepts opérationnels propres au format, dont l'indexation, le compactage et les chronologies de commits.
Choisissez Hudi quand le comportement d'upsert est au cœur de la charge de travail et que l'équipe est prête à exploiter son modèle d'écriture et de maintenance. Choisissez Delta quand Spark et Databricks constituent le centre de gravité. Choisissez Iceberg quand la neutralité vis-à-vis des moteurs, la coordination par catalogue et des stratégies de partition évolutives sont les exigences premières.
Test de décision : énumérez les moteurs qui doivent lire et écrire la même table, puis les mutations, les contrôles de gouvernance et les comportements de rollback dont ces moteurs ont besoin. Le format qui correspond à cette intersection compte davantage qu'une promesse générique de portabilité.
Là où les formats de table ouverts cessent de résoudre le problème
Un format de table ouvert peut vous dire qu'un commit a réussi. Il ne peut pas vous dire si les enregistrements validés satisfont une règle métier.
Cette limite est volontaire. La couche de format gère la structure et l'état de la table, pas la signification de chaque enregistrement ni les attentes de niveau de service sur la livraison. Elle ne valide pas automatiquement qu'une transaction possède un statut autorisé, ne signale pas un snapshot tardif, ne détecte pas un changement inattendu de distribution et ne réconcilie pas un changement de schéma avec chaque contrat en aval.
Le déficit de gouvernance au-dessus de la table
L'évolution de schéma met le problème en évidence. Un format de table peut autoriser un changement additif sans casser les requêtes existantes, mais une équipe de production doit encore demander qui l'a approuvé, quels consommateurs dépendent de la colonne affectée, si un élargissement de type modifie le comportement d'un modèle et s'il existe une piste d'audit.
Une explication de Databricks datée de 2026 souligne que des changements de schéma légers peuvent encourager des modifications directes en production sans tests suffisants, tandis que les catalogues prennent de l'importance pour les snapshots faisant autorité et le contrôle d'accès (discussion de Databricks sur les formats de table ouverts). Des rapports indépendants de 2026 décrivent de même un écart entre la structure au niveau des tables et le lignage, les glossaires, la classification et la gestion des politiques entre moteurs à l'échelle du catalogue (analyse de l'architecture de données moderne).
Les équipes comblent souvent ce manque avec des outils déconnectés :
Flux de catalogue : la découvrabilité des actifs et la propriété vivent dans un système.
Tâches de validation : les contrôles métier s'exécutent dans des notebooks ou des tâches d'orchestration.
Moniteurs de fraîcheur : les alertes d'arrivée reposent sur des planificateurs et des métadonnées de pipeline.
Réponse aux incidents : analystes et ingénieurs utilisent des tableaux de bord séparés pour enquêter sur l'impact.
Cette fragmentation rend un incident de métadonnées plus difficile à suivre. Une nouvelle colonne apparaît dans un manifeste Iceberg, un modèle en aval continue de tourner, un tableau de bord change, et aucune vue unique ne relie l'événement structurel au risque métier qui se constitue.
La gouvernance peut remonter, pas disparaître
Les formats ouverts réduisent la dépendance au niveau du stockage, mais les organisations peuvent encore créer de la dépendance au-dessus des fichiers, via les catalogues, les systèmes de contrôle d'accès, les conventions de lignage et les pratiques d'exploitation. Le défi s'accentue dans la finance, la santé, les télécommunications et le secteur public, où les équipes ont besoin de contrôles cohérents entre moteurs et de preuves pour les changements importants.
Une couche de contrôle doit donc observer plus que l'état des fichiers. Elle devrait relier schéma, Timeliness, validité des enregistrements, anomalies, propriété et dépendances en aval, tout en laissant les données là où l'organisation les gouverne déjà.
Une approche de surveillance du data lake devrait commencer à la frontière de la table, puis suivre les métadonnées et le comportement des données vers l'extérieur, jusqu'aux pipelines, aux consommateurs et aux contrôles métier.
Comment digna comble le manque opérationnel
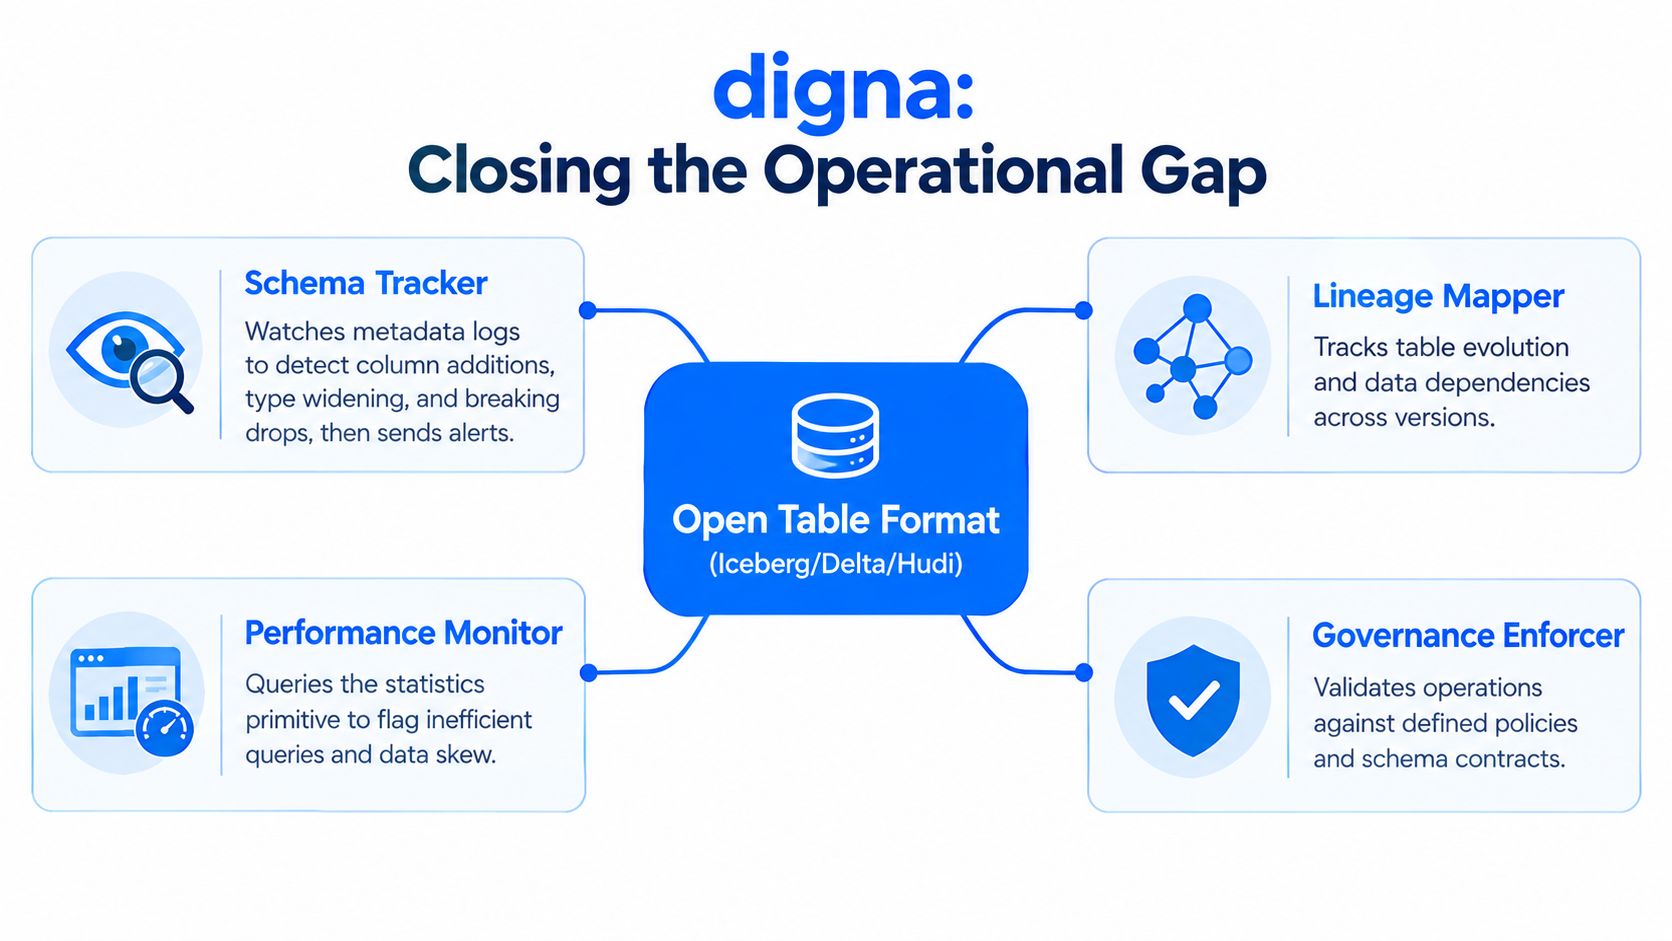
digna peut se placer au-dessus d'Iceberg, Delta Lake et Hudi comme couche d'observabilité dans la base de données. Le bon modèle mental n'est pas un format de table de plus. C'est un ensemble de contrôles opérationnels qui transforme les métadonnées de table et le comportement des snapshots en signaux pour les ingénieurs, les responsables de données et les équipes de gouvernance.
Commencer par le changement structurel
Schema Tracker observe les métadonnées structurelles et détecte les colonnes ajoutées, les colonnes supprimées et les changements de type. Pour une table ouverte, cela signifie relier les changements dans les fichiers de métadonnées Iceberg, les entrées du journal de transactions Delta ou les informations de commit Hudi aux personnes responsables et aux consommateurs qui dépendent de la table.
Un événement de schéma ne devrait pas devenir automatiquement un incident. La question qui compte est de savoir si le changement est compatible avec les contrats de la table. Un nouvel attribut nullable peut être acceptable, tandis qu'un identifiant supprimé ou un changement de type incompatible peut exiger une approbation et des tests en aval.
Ajouter le comportement de livraison et d'enregistrement
Timeliness compare l'arrivée réelle des snapshots aux schémas de livraison attendus et aux attentes de niveau de service. Il peut signaler des partitions tardives, des chargements manquants et des livraisons anticipées, ce qui aide les équipes à distinguer un commit réussi d'une livraison réussie du produit de données.
Data Anomalies profile les nouveaux snapshots pour faire apparaître des variations de volume inhabituelles, des comportements de valeurs nulles et des décalages de distribution. Cela complète les statistiques au niveau des fichiers. Les métadonnées peuvent aider un moteur de requête à élaguer, mais l'observabilité demande si les données fraîchement validées paraissent normales dans leur contexte métier.
Data Validation applique des règles au niveau des enregistrements et des contrats de schéma. Ces contrôles peuvent imposer des conditions telles que des relations valides, des valeurs autorisées ou des exigences d'audit avant que les consommateurs ne considèrent un snapshot comme prêt.
Relier les incidents à la santé de la plateforme
Data Platform Observability rassemble la santé des pipelines, le lignage, la fraîcheur, l'usage et le comportement de la plateforme dans une seule vue opérationnelle. Lorsqu'une table Iceberg en amont change de schéma, l'équipe peut suivre cet événement jusqu'aux tableaux de bord ou modèles concernés au lieu de fouiller séparément les journaux de stockage, l'historique d'orchestration et les alertes BI.
Le modèle d'exécution de digna dans la base de données maintient le calcul des métriques et l'analyse à l'intérieur des bases de données du client. Le modèle de déploiement prend en charge les environnements de cloud privé et sur site, ce qui peut compter lorsque des données réglementées ne peuvent pas être copiées vers un service de surveillance externe.
La frontière architecturale reste claire. Iceberg, Delta ou Hudi détient l'état de la table et ses métadonnées. digna surveille si cet état est structurellement sûr, ponctuel, valide et conforme aux attentes.
Un chemin concret vers l'adoption et la migration
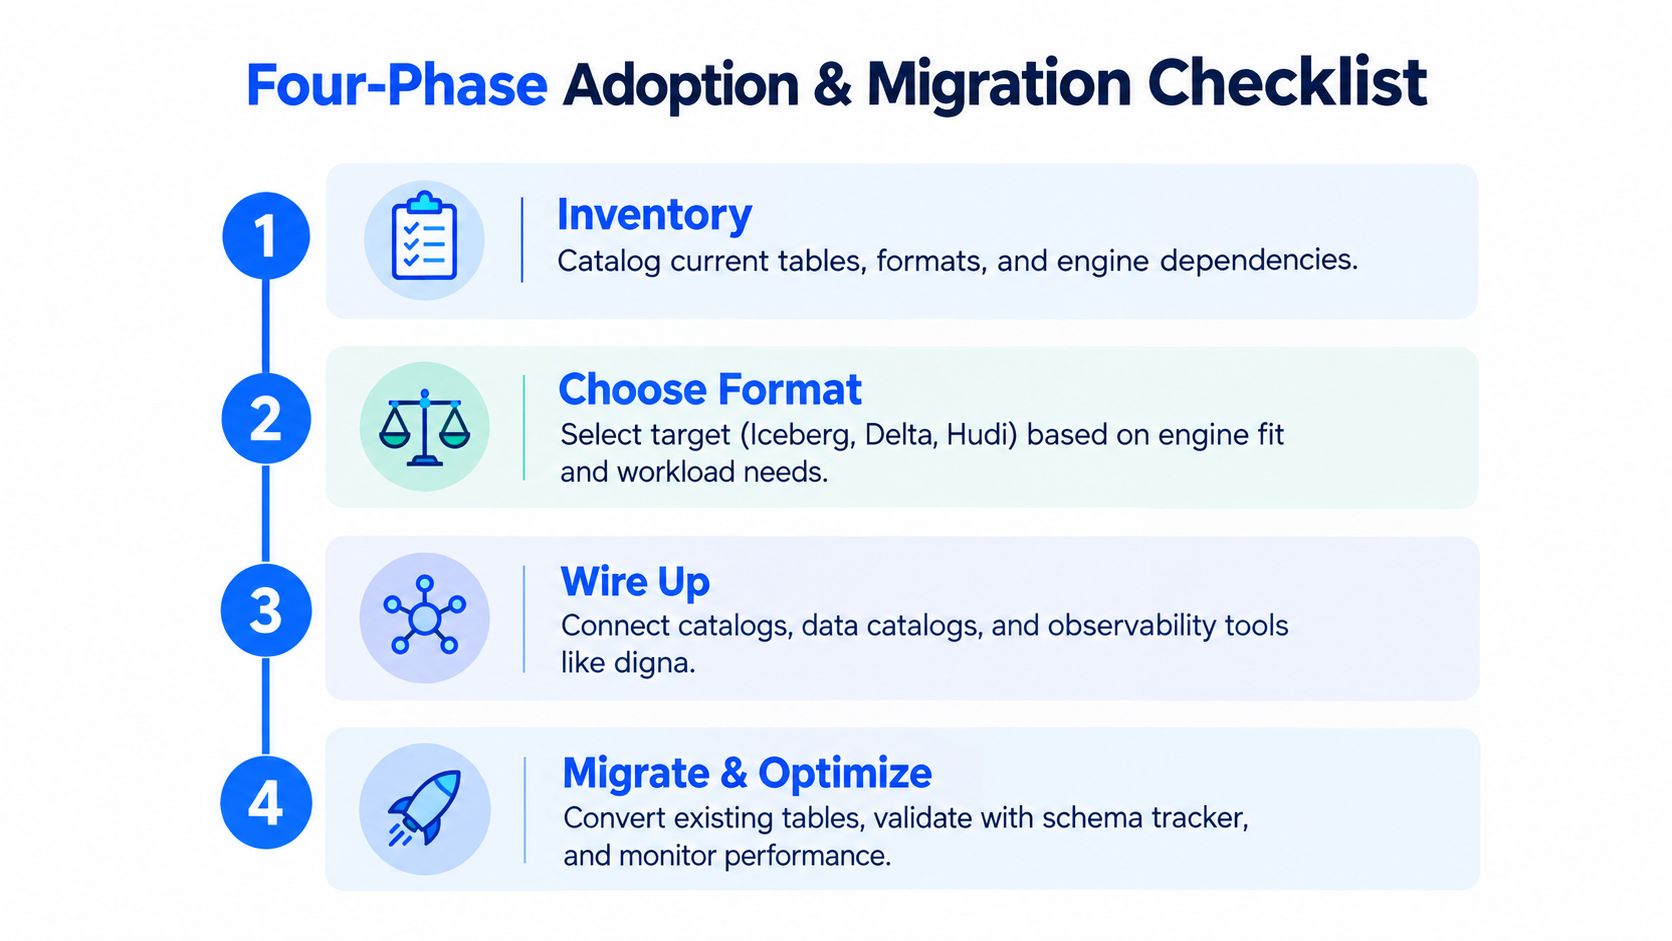
La migration fonctionne mieux en séquence maîtrisée qu'en conversion massive. Traitez chaque table comme un produit doté d'un format de stockage, d'une identité de catalogue, d'un ensemble de consommateurs et d'attentes opérationnelles.
Phase un : inventorier le patrimoine de données
Recensez les tables actuelles, les formats de fichiers, les motifs d'écriture, les schémas de partition, les dépendances aux moteurs et les consommateurs en aval. Repérez quelles tables ne reçoivent que des ajouts, lesquelles ont besoin de mises à jour ou de suppressions et lesquelles sont lues par plus d'un moteur.
Cet inventaire révèle les vrais critères de décision. Une table utilisée uniquement par Spark suit un chemin de migration différent d'une table écrite par Flink, interrogée par Trino et consommée par un entrepôt.
Phase deux : choisir la cible
Choisissez Iceberg, Delta Lake ou Hudi selon l'adéquation aux moteurs, les motifs de mutation, les besoins de partition, le comportement du catalogue et la capacité opérationnelle de l'équipe. Les équipes financières privilégieront peut-être la cohérence transactionnelle et l'application du schéma. Les pipelines du commerce préféreront peut-être le partitionnement masqué et les upserts issus d'un CDC en streaming. Les plateformes d'analytique SaaS pondéreront peut-être davantage les lectures multi-moteurs.
Le format n'est qu'une décision. Précisez quel catalogue définit l'identité de la table, comment les moteurs la trouvent, qui approuve les changements de schéma et comment fonctionne le rollback.
Phase trois : brancher les contrôles avant la bascule
Connectez le catalogue, les flux de validation, les preuves de propriété et l'observabilité avant de déplacer le trafic de production. Exécutez des lectures parallèles depuis la table héritée et la cible Iceberg, Delta ou Hudi. Comparez le schéma et les résultats au niveau des lignes avec Data Validation, puis fixez des seuils de fraîcheur et de comportement anormal.
Un cadre de planification des migrations de données devrait inclure les critères de rollback, la durée des lectures fantômes, l'acceptation par les consommateurs et la conservation des preuves. N'attendez pas le premier tableau de bord cassé pour découvrir que personne n'est responsable de la nouvelle table.
Phase quatre : migrer table par table
Convertissez une table délimitée, validez lectures et écritures, observez la croissance des métadonnées et le comportement des requêtes. Gardez l'ancien chemin disponible jusqu'à atteindre la parité et les seuils opérationnels, puis déplacez les consommateurs par étapes.
Le choix du format compte, mais la discipline sur les métadonnées compte davantage. Une table Hudi bien gouvernée peut surpasser un déploiement Iceberg mal entretenu pour sa charge de travail, tout comme un patrimoine Delta exploité avec soin peut mal convenir à une organisation qui a besoin de moteurs et de catalogues indépendants.
Choisissez le format qui correspond à votre charge de travail, mais concevez la couche de gouvernance en même temps. C'est ce qui transforme un stockage ouvert en table de lakehouse fiable.
digna surveille les changements de schéma, la ponctualité des snapshots, la validité des enregistrements et les comportements de données anormaux au sein de votre propre environnement, et donne aux équipes une couche opérationnelle au-dessus d'Iceberg, Delta Lake et Hudi. Rendez-vous sur digna pour évaluer comment ses capacités modulaires d'observabilité et de validation peuvent soutenir votre migration vers les tables ouvertes.
Là où s'arrête le format commencent les contrôles métier : Business Monitoring surveille si les chiffres produits par une table continuent de se comporter comme prévu.
Questions fréquentes
Éviter la dépendance à un fournisseur est-il la principale raison d'utiliser un format de table ouvert ?
Cette raison est incomplète. La portabilité des fichiers compte, mais le changement majeur est que la signification de la table — historique transactionnel, intention du schéma et métadonnées de planification des requêtes — quitte un moteur unique pour des fichiers que chacun peut lire. La dépendance est le symptôme ; l'endroit où réside la définition de la table est le véritable changement.
Quelles primitives Iceberg, Delta Lake et Hudi partagent-ils ?
Tous trois tiennent un journal de commits immuable, un manifeste décrivant quels fichiers appartiennent à quelle version, des statistiques par fichier pour l'élagage et un enregistrement de schéma qui évolue indépendamment des fichiers de données. Les différences portent sur la manière dont chacun écrit et compacte cette structure, pas sur le concept sous-jacent.
En quoi les trois formats diffèrent-ils en pratique ?
Iceberg bénéficie de la plus large prise en charge par les moteurs et de la conception la plus neutre à leur égard. Delta Lake s'intègre le plus profondément aux environnements Spark et Databricks. Hudi optimise les upserts fréquents et la consommation incrémentale. La comparaison honnête porte sur le motif d'écriture pour lequel chacun a été bâti, pas sur celui qui affiche le plus de fonctionnalités.
Où les formats de table ouverts cessent-ils de résoudre le problème ?
À la frontière entre structure et signification. Le format peut garantir que chaque moteur lit les mêmes lignes validées sous le même schéma ; il ne peut pas vous dire que ces lignes sont complètes, qu'elles sont arrivées à temps ou qu'elles contiennent des valeurs sensées. Cet écart est la place de la surveillance de la qualité.
À quoi ressemble un chemin d'adoption réaliste ?
Choisissez une table à la propriété claire et au motif de requête connu, convertissez-la pendant que l'original continue de tourner et comparez les résultats sur un cycle métier complet avant de déplacer les consommateurs. Attribuez la maintenance — compactage, expiration des snapshots, mises à niveau du catalogue — avant la fin du pilote, sinon elle ne sera la tâche de personne.



