Données historiques Snowflake : Time Travel et Fail-Safe
|
9
minute de lecture

À 3 heures du matin, un travail automatisé tronque une table client au lieu de charger sa partition suivante. Au moment où l'équipe arrive, les tableaux de bord sont vides, les modèles en aval échouent et personne ne parvient à s'accorder sur le fait que les dommages ont commencé avec le chargement, la transformation ou un script de nettoyage. Les données historiques de Snowflake peuvent transformer cet incident en une récupération contrôlée, mais seulement lorsque l'équipe sait quel historique existe encore, quels objets sont protégés et si la copie disponible est interrogeable ou réservée à la récupération.
L'hypothèse la plus dangereuse est que chaque table Snowflake dispose automatiquement de la fenêtre de Time Travel de 90 jours annoncée. Les objets permanents peuvent être configurés pour cette durée dans l'édition appropriée, mais les objets temporaires et transitoires ont des limites beaucoup plus étroites. Les données historiques sont donc plus qu'une simple fonctionnalité SQL. C'est une décision de conception qui implique la récupération, l'observability, les preuves d'audit, le stockage et le cycle de vie des objets.
Table des matières
Quand les données historiques sauvent votre environnement de production
Utiliser les données historiques pour l'Observability et les audits
Quand utiliser Time Travel par rapport aux sauvegardes externes
Quand les données historiques sauvent votre environnement de production
À 2 heures du matin, un chargement échoué remplace des enregistrements clients valides par des valeurs nulles. L'ingénieur d'astreinte arrête le processus d'écriture, vérifie si la table contient toujours un historique exploitable et enregistre l'incident avant qu'une nouvelle tentative ne modifie les preuves. Une requête historique peut afficher le dernier état stable connu, tandis qu'un clone offre à l'équipe une surface de récupération distincte. La production reste disponible pendant que la défaillance est examinée.
Ce résultat dépend de la préparation. Snowflake Time Travel préserve les états antérieurs des tables et prend en charge les opérations historiques de SELECT, de clonage et de UNDROP au sein de la fenêtre de rétention configurée. La période standard est de 1 jour, tandis que les bases de données, schémas et tables permanents peuvent être configurés de 0 à 90 jours, conformément à la documentation sur le Time Travel de Snowflake. La période de 90 jours annoncée s'applique uniquement lorsque le type d'objet, l'édition et les paramètres le permettent.
Le type d'incident que les équipes sous-estiment
Une table de production permanente peut conserver l'état requis alors que la table de staging transitoire qui l'a alimentée a déjà perdu son historique exploitable. Cet écart limite l'investigation. L'équipe pourrait récupérer l'aspect de la cible sans pouvoir prouver quel changement en amont a introduit les mauvaises valeurs.
Capturez la chronologie de l'incident avec une requête exécutable avant de restaurer quoi que ce soit :
La vue d'utilisation du compte présente une certaine latence, associez-la donc aux journaux d'orchestration et à l'historique des tâches lorsque l'incident est encore actif. Enregistrez les objets affectés, les symptômes observés et les ID de requête qui ont modifié la production.
Règle opérationnelle : Traitez la rétention comme un contrôle au niveau de l'objet, et non comme une promesse à l'échelle de la plateforme.
Utilisez une séquence de récupération prudente :
Arrêter le processus d'écriture : Mettez en pause la tâche, le pipeline ou le déploiement défaillant.
Inspecter avant de restaurer : Comparez les lignes historiques et actuelles, les clés, le comportement des valeurs nulles et les totaux métier.
Récupérer de manière isolée : Créez un clone ou une table distincte tant que le mécanisme de défaillance reste incertain.
Valider le remplacement : Testez les dépendances et les autorisations avant la promotion.
Les équipes qui mettent en place une pratique plus large de fiabilité peuvent connecter ce flux de travail à l'ingénierie de la fiabilité des bases de données. Les données historiques soutiennent alors l'observability et l'examen d'audit, et pas seulement la récupération d'urgence. La rétention doit être examinée en tenant compte de la propriété, du lignage, de la surveillance et des objectifs de récupération.
La croissance de Snowflake a également produit des cycles de vie d'objets plus complexes. À mesure que les déploiements s'étendent, les équipes héritent de jeux de données permanents, transitoires et temporaires présentant des comportements de récupération différents. La question pratique n'est pas de savoir si Snowflake propose 90 jours. Il s'agit de savoir quels objets conservent les preuves suffisamment longtemps pour récupérer et expliquer une défaillance de production.
Querying Past States with Time Travel
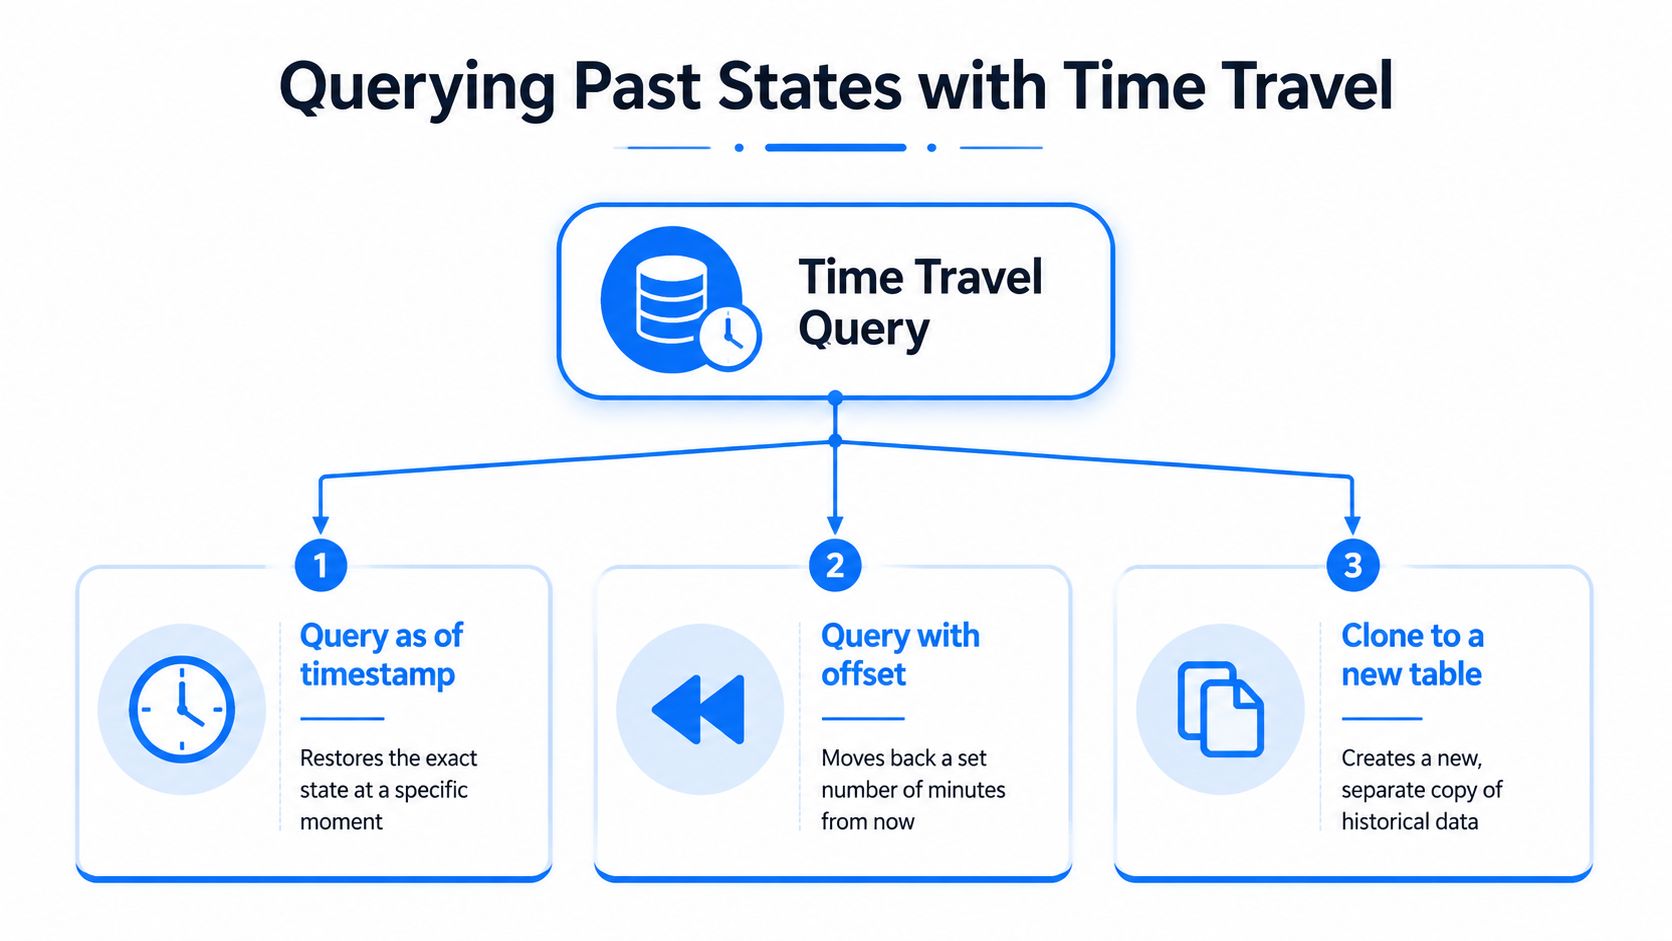
Time Travel fonctionne de manière optimale lorsque l'ingénieur sépare trois tâches : inspecter un état antérieur, identifier la limite exacte du changement et créer une copie isolée. La syntaxe prend en charge chaque approche, mais le choix affecte la précision avec laquelle vous pouvez reproduire l'incident.
Utiliser des horodatages pour une fenêtre d'incident connue
Si la surveillance montre qu'un chargement destructeur a commencé à un moment connu, interrogez la table telle qu'elle existait avant cet événement :
AT est utile lorsque la chronologie de l'incident provient des journaux d'orchestration, des enregistrements de déploiement ou de l'historique des requêtes. Il demande à Snowflake l'état de l'objet à un moment précis, ce qui permet de comparer une version connue comme correcte avec la table actuelle.
Vous pouvez également cloner cet état historique :
Le clone offre à l'équipe une surface d'investigation de travail sans écraser la source. Avant de vous fier au résultat, vérifiez que l'horodatage demandé se situe dans la fenêtre de rétention actuelle de l'objet.
Utiliser des décalages pour une investigation relative
Lorsque l'incident s'est produit récemment mais que l'horodatage exact est moins important, OFFSET permet de revenir en arrière d'un certain nombre de secondes :
C'est pratique lors d'un incident actif car cela exprime un point relatif dans le temps. C'est moins adapté pour un dossier d'audit formel, à moins que vous ne capturiez également l'heure d'exécution et l'horodatage résolu, car « il y a une heure » peut devenir ambigu après coup.
Utiliser les limites de transaction lorsque le changement est identifiable
Si l'historique des requêtes ou les outils de déploiement vous fournissent un identifiant de transaction, BEFORE vous permet d'inspecter l'état de la table avant cette transaction :
L'identifiant exact doit être disponible dans vos dossiers opérationnels. Ne le devinez pas. Une requête basée sur l'horodatage est généralement plus sûre lorsque l'équipe ne dispose que d'une heure d'incident approximative.
La validation de la rétention doit se faire avant le SQL de récupération, et non après l'échec d'une requête :
Inspectez le retention_time renvoyé, puis confirmez l'édition de la table et le type d'objet. Snowflake documente une période de rétention standard de 1 jour et une rétention configurable de 0 à 90 jours pour les bases de données, schémas et tables permanents dans les éditions concernées, comme décrit dans ses directives sur la disponibilité des données.
Time Travel n'est pas non plus une archive de sauvegarde classique. Il préserve les états historiques interrogeables pendant une période définie, mais il ne répond pas automatiquement aux exigences de rétention à long terme, de copie immuable ou de récupération sur un compte indépendant. Utilisez-le pour une investigation opérationnelle rapide et une récupération à un point précis dans le temps, puis évaluez si une autre couche de protection est nécessaire.
Comprendre les limites de rétention et les types d'objets
Le chiffre de 90 jours s'applique à une fonctionnalité, pas à tous les objets d'un compte. Les objets permanents peuvent avoir une période de Time Travel configurable de 0 à 90 jours, tandis que les objets temporaires et transitoires sont limités à 0 ou 1 jour, selon la documentation de Snowflake sur le coût de stockage et la rétention. Cette table de staging que votre pipeline a recréée lors d'un déploiement n'a peut-être pas la même protection que la table de production qu'elle alimente.
Rétention des données historiques Snowflake par type d'objet
Type d'objet | Time Travel (Standard) | Time Travel (Enterprise+) | Fail-safe |
|---|---|---|---|
Base de données, schéma ou table permanente | 1 jour par défaut | 0 à 90 jours | 7 jours après Time Travel pour les objets permanents |
Table transitoire | 0 ou 1 jour | 0 ou 1 jour | Non disponible |
Table temporaire | 0 ou 1 jour | 0 ou 1 jour | Non disponible |
Le tableau reflète le modèle de rétention documenté. Fail-safe n'est pas une extension de Time Travel interrogeable par l'utilisateur. Après l'expiration des données historiques, les objets permanents peuvent entrer dans une période Fail-safe de 7 jours, mais ces données sont destinées au support de récupération plutôt qu'à l'analyse SELECT normale. Traiter Fail-safe comme une couche de requête d'audit crée une fausse confiance lors d'un incident.
Auditer les paramètres avant une défaillance
Commencez par l'objet lui-même :
Examinez le retention_time, le type d'objet et l'édition qui régit le compte. Classez ensuite les tables par rôle. Les tables métier permanentes méritent généralement une politique différente de celle des tables d'atterrissage jetables, mais cette distinction doit être explicite et documentée.
Le stockage est le compromis. Une rétention plus longue signifie que Snowflake conserve plus de données historiques, les équipes doivent donc estimer l'impact pour les tables à forte activité au lieu d'activer la rétention maximale partout. Les fenêtres de maintenance des données historiques documentées par Snowflake s'étendent de 7 à 97 jours pour les objets permanents dans l'édition Enterprise, contre 0 à 1 jour pour les objets transitoires, ce qui place la classification des objets au cœur de la planification des coûts et de la conception de la récupération.
Règle pratique : Une politique de rétention doit répondre à trois questions : qu'est-ce qui doit être récupérable, qu'est-ce qui doit être auditable et qu'est-ce qui peut être recréé à partir d'une source faisant autorité.
Les exigences réglementaires ajoutent une autre contrainte. Une entreprise peut avoir besoin de conserver des preuves pendant une période qui ne correspond pas à Time Travel, ou elle peut avoir besoin d'un calendrier de suppression documenté plutôt que d'une conservation indéfinie. Pour ce travail de politique, les conseils sur le calendrier de conservation du RGPD offrent un contexte utile pour aligner la rétention avec l'objectif, les exigences légales et l'élimination contrôlée.
Les équipes qui conçoivent des ensembles de données à longue durée de vie doivent également séparer l'archivage de la récupération après incident. Les conseils sur la maîtrise de l'archivage des données sont pertinents car une archive doit être intentionnelle, gouvernée et découvrable. Time Travel protège un objet en mutation pendant une fenêtre limitée. Il ne remplace pas un catalogue d'archives ou un responsable de la rétention.
Récupérer des objets supprimés avec le clonage et UNDROP
Une table supprimée crée un problème de récupération différent de celui d'une mauvaise mise à jour. L'objet lui-même peut disparaître de l'espace de noms actif, l'ingénieur doit donc décider s'il convient de restaurer l'objet d'origine ou de créer une copie indépendante pour l'investigation.
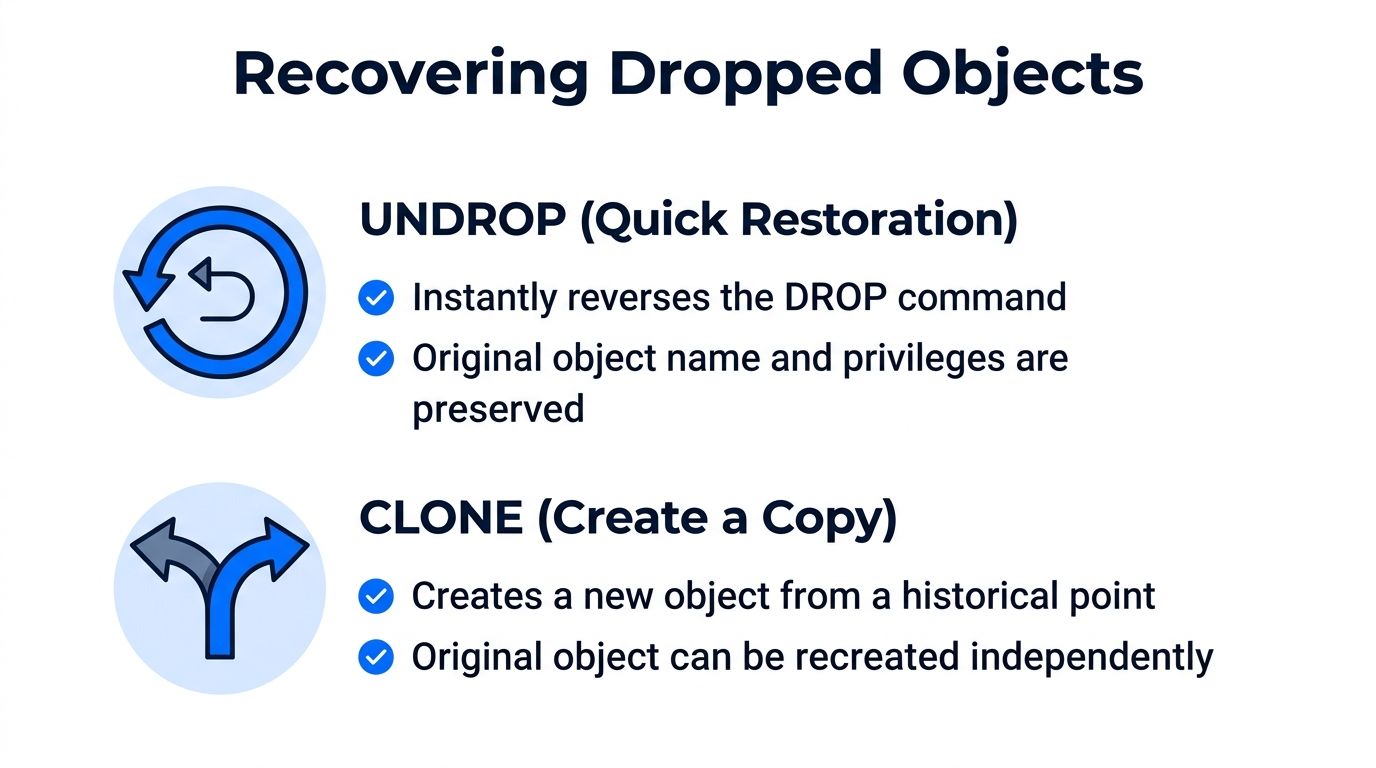
UNDROP est la voie directe lorsque l'objet a été supprimé au cours de sa période de récupération disponible :
Pour un schéma ou une base de données supprimé, utilisez la commande correspondante au niveau de l'objet :
Cette commande est intéressante lors d'une panne car elle annule la suppression plutôt que de nécessiter un flux de travail de déplacement de données. Néanmoins, la restauration ne doit pas être traitée comme une preuve que l'objet est correct. Vérifiez l'existence de l'objet, les privilèges, les dépendances et le schéma attendu de l'application avant de reconnecter les utilisateurs.
Cloner d'abord lorsque la défaillance n'est pas claire
Un clone est plus sûr lorsque l'équipe doit inspecter une version historique sans modifier le chemin de récupération de la production :
Cette approche préserve la source pendant que les ingénieurs comparent les enregistrements, testent les transformations et identifient l'instruction qui a causé les dommages. Elle soutient également un processus de promotion contrôlé : valider le clone, documenter les preuves, puis décider s'il faut remplacer ou réparer l'objet de production.
Les noms d'objets peuvent compliquer UNDROP. Si un nouvel objet a déjà pris le nom d'origine, l'opération de récupération peut nécessiter de renommer ou de supprimer d'abord l'objet en conflit. N'improvisez pas cette étape en production. Enregistrez les métadonnées actuelles de l'objet, préservez l'objet en conflit s'il est susceptible de contenir des preuves et utilisez un schéma de récupération dédié dans la mesure du possible.
Valider avant la promotion
Une liste de contrôle de récupération devrait inclure :
Confirmer la limite de la défaillance : Établir si la suppression, la mise à jour ou le remplacement a affecté une table, un schéma ou une base de données.
Vérifier l'éligibilité à la rétention : Vérifier que l'état historique de l'objet est toujours disponible et interrogeable.
Créer une copie isolée : Préférer un clone lorsque l'investigation ou la comparaison est encore nécessaire.
Comparer les valeurs critiques : Vérifier les clés, les exceptions au niveau des lignes, les agrégats et les attentes en aval.
Examiner les autorisations : Confirmer que la propriété et les privilèges correspondent au modèle d'accès prévu.
Promouvoir délibérément : Ne modifier les utilisateurs qu'une fois que l'objet récupéré a passé la validation.
L'architecture de micro-partitions de Snowflake signifie qu'un clone n'est pas une sauvegarde assemblée manuellement. Les états historiques restent liés au comportement de rétention et de stockage de la plateforme, de sorte que le plan de récupération nécessite toujours une stratégie indépendante pour les données qui doivent survivre au-delà de ce cycle de vie.
Les équipes qui formalisent ces procédures peuvent utiliser les meilleures pratiques en matière d'entrepôt de données comme référence opérationnelle plus large. L'objectif pratique est la répétabilité. À 2 heures du matin, un ingénieur doit suivre un chemin de décision connu plutôt que de chercher parmi des hypothèses non documentées sur les noms d'objets et la rétention.
Utiliser les données historiques pour l'Observability et les audits
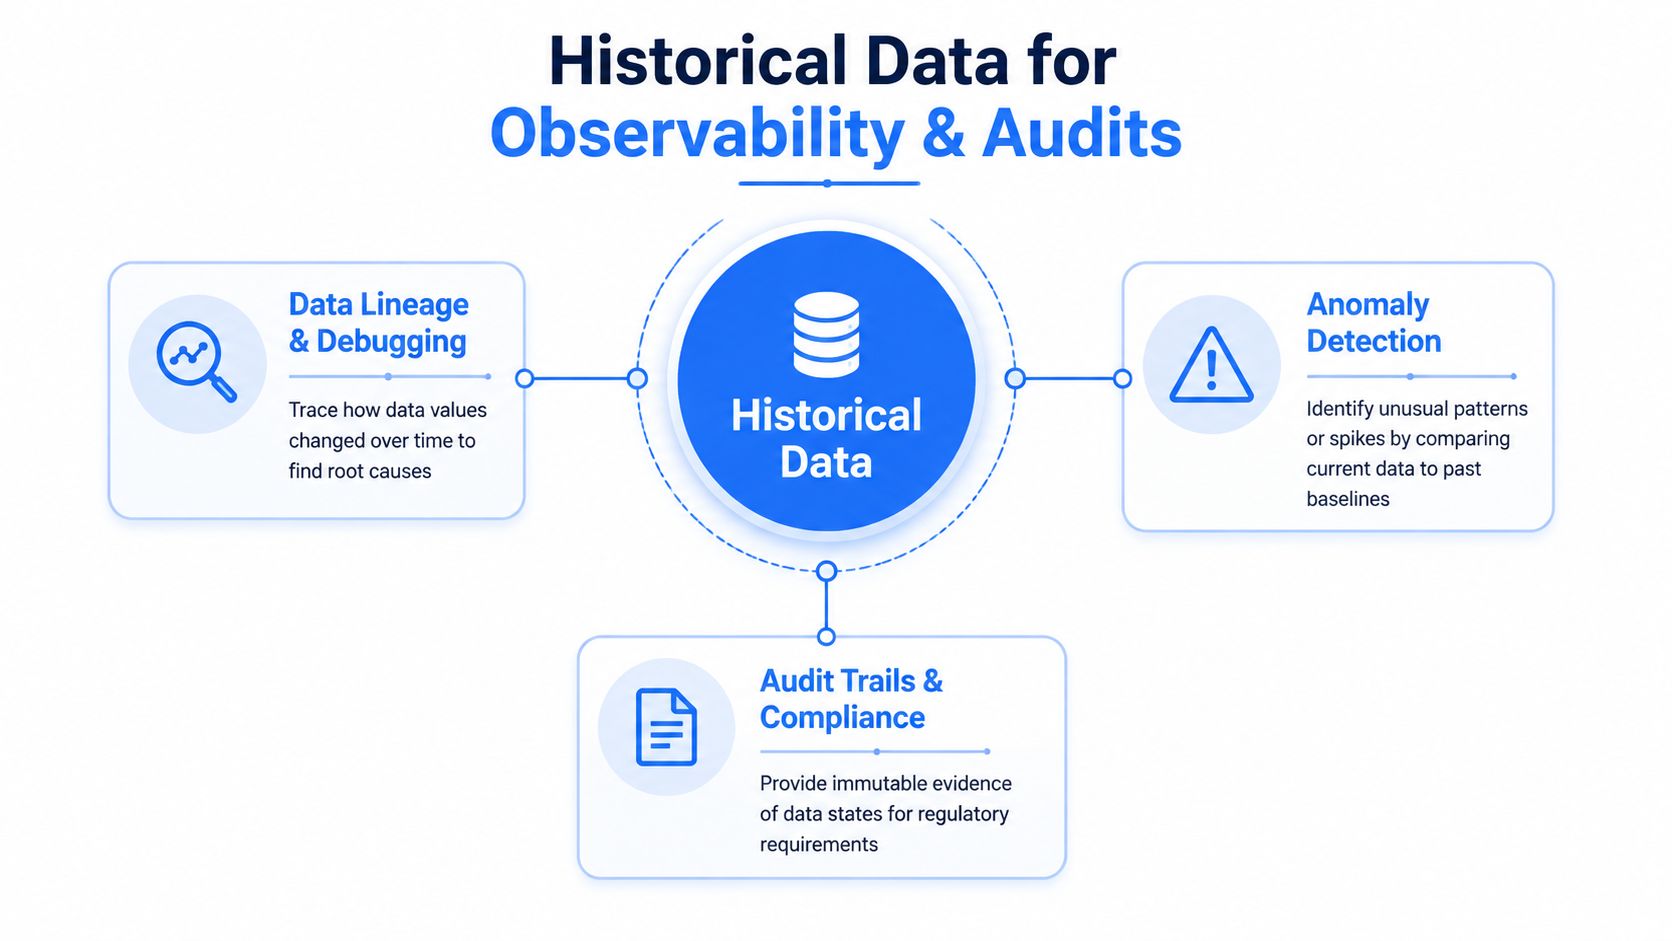
Un état de table historique répond à la question : « Que contenait cet objet à ce moment-là ? » L'Observability pose une question plus large : « Comment les données ont-elles évolué au fil du temps, et quand ce comportement est-il devenu anormal ? » Ces questions se complètent, mais elles ne sont pas interchangeables.
Une investigation utile commence par un symptôme observé. Une métrique chute, un chargement arrive en retard, une colonne change de type ou un total métier s'écarte de son modèle normal. Time Travel peut inspecter la table sous-jacente à un moment pertinent, tandis qu'un enregistrement d'Observability peut montrer si le changement était isolé, récurrent ou s'il s'inscrivait dans un problème de pipeline plus large.
Combiner des preuves ponctuelles avec des signaux continus
Le flux de travail est simple :
Détecter : Un moniteur signale un volume, une Timeliness, un schéma ou un comportement métier anormal.
Localiser : Les ingénieurs identifient la table, la tâche, l'instruction concernées et la fenêtre de changement approximative.
Comparer : Une requête Time Travel contraste l'état actuel avec un état historique.
Expliquer : Le lignage et les journaux de pipeline relient le changement de données à une action en amont.
Préserver : L'équipe stocke le contexte de l'incident et les résultats de la validation dans un enregistrement propice à l'audit.
Snowflake expose les informations de clustering via CLUSTERING_INFORMATION, y compris average_overlaps, average_depth et partition_depth_histogram. Ces métriques peuvent aider les ingénieurs à déterminer si un mauvais élagage contribue à la lenteur de l'analyse historique, mais le reclustering a un coût. Un flux de travail judicieux compare les partitions analysées avec le total des partitions, définit une base de référence pour le temps d'exécution des requêtes représentatives et examine la consommation de crédits dans AUTOMATIC_CLUSTERING_HISTORY avant de conserver une clé de clustering.
La surface d'historique des requêtes a également ses propres limites de rétention. La vue QUERY_HISTORY de l'utilisation du compte conserve les enregistrements pendant 1 an, soit 365 jours, tandis que les vues correspondantes de l'Information Schema et les fonctions de table ont des périodes de rétention plus courtes allant de 7 jours à 6 mois, comme résumé dans cet aperçu de Snowflake Time Travel et de l'historique des requêtes. Cette différence est importante lors des audits. Une table peut conserver des lignes historiques alors que les preuves opérationnelles expliquant le changement ont déjà expiré.
Une plateforme telle que l'data observability peut compléter Time Travel en préservant l'historique des métriques, en apprenant le comportement attendu, en suivant la Timeliness, en validant les enregistrements et en détectant les changements de schéma. L'architecture doit conserver les preuves dans l'environnement client et distinguer les états historiques bruts des signaux de surveillance dérivés. Cette séparation offre aux auditeurs à la fois le contexte des données sous-jacentes et l'histoire opérationnelle qui l'entoure.
Quand utiliser Time Travel par rapport aux sauvegardes externes
Time Travel est l'outil idéal pour une récupération locale et rapide après des erreurs récentes. C'est généralement un piètre substitut à une politique de sauvegarde à long terme, en particulier lorsque l'entreprise a besoin d'un historique au-delà de la fenêtre configurée, d'une récupération indépendante ou de preuves que les utilisateurs ne peuvent pas modifier via des opérations d'entrepôt normales.
Facteur de décision | Time Travel | Sauvegarde externe |
|---|---|---|
Objectif principal | Récupération et analyse opérationnelles | Récupération après sinistre et rétention à long terme |
Cible de récupération | Un état de table, de schéma ou de base de données | Une copie maintenue séparément ou un environnement plus large |
Précision historique | État à un point précis dans le temps au sein de la rétention | Dépend du calendrier des instantanés ou des exportations |
Vitesse opérationnelle | Rapide pour les objets éligibles | Peut nécessiter un travail de restauration, de transfert et de validation |
Limitation principale | Rétention, type d'objet et dépendance à la plateforme | Frais généraux de stockage, d'orchestration, de test et de gestion |
Utilisez Time Travel lorsque l'incident est récent, que l'objet affecté est éligible et que la portée de la récupération est étroite. Un clone est souvent suffisant pour l'investigation, tandis que UNDROP convient à une suppression accidentelle claire nécessitant une restauration rapide.
Choisissez une autre couche de protection lorsque l'exigence dépasse le modèle de rétention de Snowflake. Cela inclut la rétention réglementaire à long terme, les preuves immuables, la récupération entre environnements ou la protection contre les erreurs opérationnelles au niveau du compte. Les objets permanents peuvent bénéficier de 7 jours de Fail-safe après l'expiration de Time Travel, mais les objets transitoires et temporaires ne bénéficient pas de cette protection, et le Fail-safe n'est pas interrogeable par les utilisateurs. Le plan de récupération doit tenir compte de ces limites plutôt que de les traiter comme équivalentes à une copie externe.
Prendre la décision par rapport aux exigences de l'entreprise
Demandez au responsable de chaque jeu de données critique :
Jusqu'où la récupération doit-elle remonter ?
La copie doit-elle être contrôlée de manière indépendante ?
L'entreprise peut-elle tolérer une reconstruction à partir des systèmes sources ?
Les auditeurs doivent-ils inspecter directement les enregistrements historiques ?
Quelle vitesse de récupération est requise pour les flux de travail orientés client ?
La réplication native, les exportations gérées et les outils de sauvegarde tiers peuvent chacun combler des lacunes différentes. La conception correcte pourrait combiner un Time Travel à fenêtre courte pour une réparation immédiate avec une archive gérée séparément pour une rétention plus longue. Le coût ne se limite pas au stockage. Il comprend les tests opérationnels, les contrôles d'accès, le catalogage et le temps nécessaire pour prouver qu'une copie de récupération fonctionne.
Les équipes qui affinent leur plan de continuité global peuvent consulter ce guide pratique sur le DR pour les équipes modernes. Pour la partie Snowflake de la conception, les meilleures pratiques en matière de disponibilité des données aident à structurer la disponibilité comme une discipline opérationnelle plutôt que comme une simple commande de récupération.
digna aide les équipes chargées des données à surveiller le comportement des données Snowflake grâce à la détection d'anomalies, à la surveillance de la Timeliness, à la validation des enregistrements, au suivi des schémas et à l'analyse historique tout en maintenant l'exécution au sein de l'environnement du client. Visitez digna pour connecter la planification de la rétention et de la récupération à une observability continue avant le prochain incident de production.
Questions fréquentes
Combien de temps Snowflake conserve-t-il les données historiques ?
Moins que ne le supposent la plupart des équipes. La période standard de Time Travel est de 1 jour, tandis que bases, schémas et tables permanents peuvent être configurés de 0 à 90 jours. La fenêtre de 90 jours est un maximum configurable, pas un acquis automatique.
Pourquoi une table transitoire casse-t-elle une restauration ?
Parce que la rétention est un contrôle au niveau de l'objet, pas une promesse de plateforme. Une table permanente de production peut encore détenir l'état nécessaire alors que la table transitoire de staging qui l'alimentait a déjà perdu son historique exploitable.
Que capturer avant toute restauration ?
La chronologie de l'incident. Interrogez SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY sur la fenêtre concernée, en filtrant sur query_start_time et en lisant query_id, user_name, query_type, query_text et execution_status. Cette vue a de la latence : associez-la aux journaux d'orchestration et à l'historique des tâches.
Quelle est la séquence de récupération sûre ?
Arrêter d'abord l'écrivain : suspendez la tâche, le pipeline ou le déploiement fautif avant toute restauration. Récupérer pendant que le job à l'origine des dégâts tourne encore produit un second incident par-dessus le premier.
Qu'ajoute Fail-safe à Time Travel ?
Un ultime recours, pas un second palier de rétention interrogeable. Time Travel est la fenêtre que votre équipe maîtrise et utilise directement : un plan de reprise qui repose sur Fail-safe est déjà sorti des contrôles que vous pouvez tester à l'avance.


