Détection d’anomalies par machine learning : guide pratique
|
10
minute de lecture

Votre tableau de bord du chiffre d’affaires semble correct à 9 h. À 11 h 30, la finance remet en question les prévisions hebdomadaires, les responsables commerciaux contestent les chiffres du pipeline, et personne ne peut signaler la moindre panne système. Le problème n’est pas un job d’entrepôt défaillant. C’est un changement discret en amont. Une table source a commencé à dupliquer des enregistrements, un horodatage est arrivé en retard, ou la distribution des valeurs d’une colonne a juste assez dérivé pour corrompre la logique en aval sans déclencher la moindre alerte codée en dur.
C’est précisément le type de défaillance pour lequel la détection d’anomalies par machine learning est conçue. Pas les incidents bruyants, mais les incidents silencieux. Ceux qui passent les validations de base, arrivent dans des tables de confiance et érodent lentement la confiance dans chaque rapport et chaque modèle qui en dépendent.
Beaucoup d’équipes ne peinent pas par manque d’alertes. Elles peinent parce que la surveillance traditionnelle fondée sur des seuils ne parvient pas à suivre des données de grande dimension, une saisonnalité changeante, des pipelines en évolution et les contraintes des entreprises en matière de confidentialité et de déploiement. La détection d’anomalies moderne fonctionne lorsqu’elle apprend en continu le comportement normal, s’exécute au plus près des données et s’intègre dans des processus d’observabilité que les équipes opérationnelles peuvent maintenir.
Table des matières
Quand des erreurs de données silencieuses causent de gros problèmes
Considérations sur le déploiement et la surveillance en entreprise
Quand des erreurs de données silencieuses causent de gros problèmes
Un schéma de défaillance courant commence par un utilisateur métier qui fait confiance à des données techniquement présentes mais au comportement erroné. Les prévisions de ventes s’envolent. L’attrition des clients semble s’améliorer du jour au lendemain. Un feature store de ML récupère des valeurs biaisées et modifie les résultats du modèle. Personne ne voit de plantage, car rien n’a planté.
Les contrôles fondés sur des règles détectent généralement les défaillances évidentes : pics de valeurs nulles, fichiers manquants, nombre de lignes qui tombe à zéro. Ils peinent lorsque le problème est plus subtil, par exemple une source qui envoie des enregistrements en double, une distribution qui se déplace à l’intérieur d’une plage acceptée, ou des champs corrélés qui dérivent ensemble d’une manière qu’aucune règle statique n’avait anticipée.
Cet écart compte dans les opérations réelles. Les méthodes de détection d’anomalies fondées sur le machine learning surpassent les approches statistiques traditionnelles de 8 à 12 % en exactitude, certaines implémentations atteignant jusqu’à 15 % de précision supplémentaire dans la détection d’anomalies complexes et multivariées, en particulier dans des contextes de grande dimension comme la surveillance des transactions financières et la prédiction des pannes d’équipements industriels, selon ce résumé de recherche sur la détection d’anomalies.
Pourquoi la surveillance traditionnelle ne suffit plus
La surveillance traditionnelle suppose que les équipes peuvent définir les défaillances à l’avance. En pratique, elles ne le peuvent pas.
La logique métier change : Les nouvelles campagnes, les changements de prix, les réorganisations territoriales et les lancements de produits modifient le comportement des données plus vite que les règles d’alerte ne sont mises à jour.
Les pipelines se superposent : Un seul KPI peut dépendre de jobs d’ingestion, de modèles dbt, de synchronisations reverse ETL et d’API tierces.
Les anomalies se cachent dans les relations : Chaque colonne peut sembler normale prise isolément alors que le schéma combiné est manifestement erroné.
Règle pratique : si votre équipe découvre les problèmes de données par un utilisateur de tableau de bord plutôt que par la surveillance, votre logique de détection est trop fragile.
Les équipes qui cherchent à moderniser ces processus commencent souvent par corriger la couche d’ingestion et de transformation. C’est pourquoi des ressources comme les solutions de traitement des données d’Osher Digital offrent un contexte utile. Un traitement fiable réduit les défaillances évitables, mais ne remplace pas la détection d’anomalies. Vous avez toujours besoin d’un système capable de repérer les inconnues inconnues une fois que les données commencent à circuler.
Ce que change le machine learning
La détection d’anomalies par machine learning fait passer le travail de l’écriture de règles à l’apprentissage de références. Au lieu de demander à un ingénieur de définir à l’avance chaque état défaillant, le système modélise le comportement attendu et signale les écarts significatifs.
Ce changement est opérationnel, pas théorique. Il protège les prévisions, le reporting financier, les processus de conformité, la surveillance de la fraude et les entrées des modèles contre le type de dérive discrète qui provoque les débats les plus coûteux au sein des équipes data des entreprises.
Comprendre l’anatomie d’une anomalie
Une anomalie désigne des données qui s’écartent du comportement attendu. L’intérêt n’est pas dans la définition. Il est de savoir quel type d’écart vous observez, car les méthodes de détection échouent lorsque les équipes traitent toutes les anomalies comme un même problème.
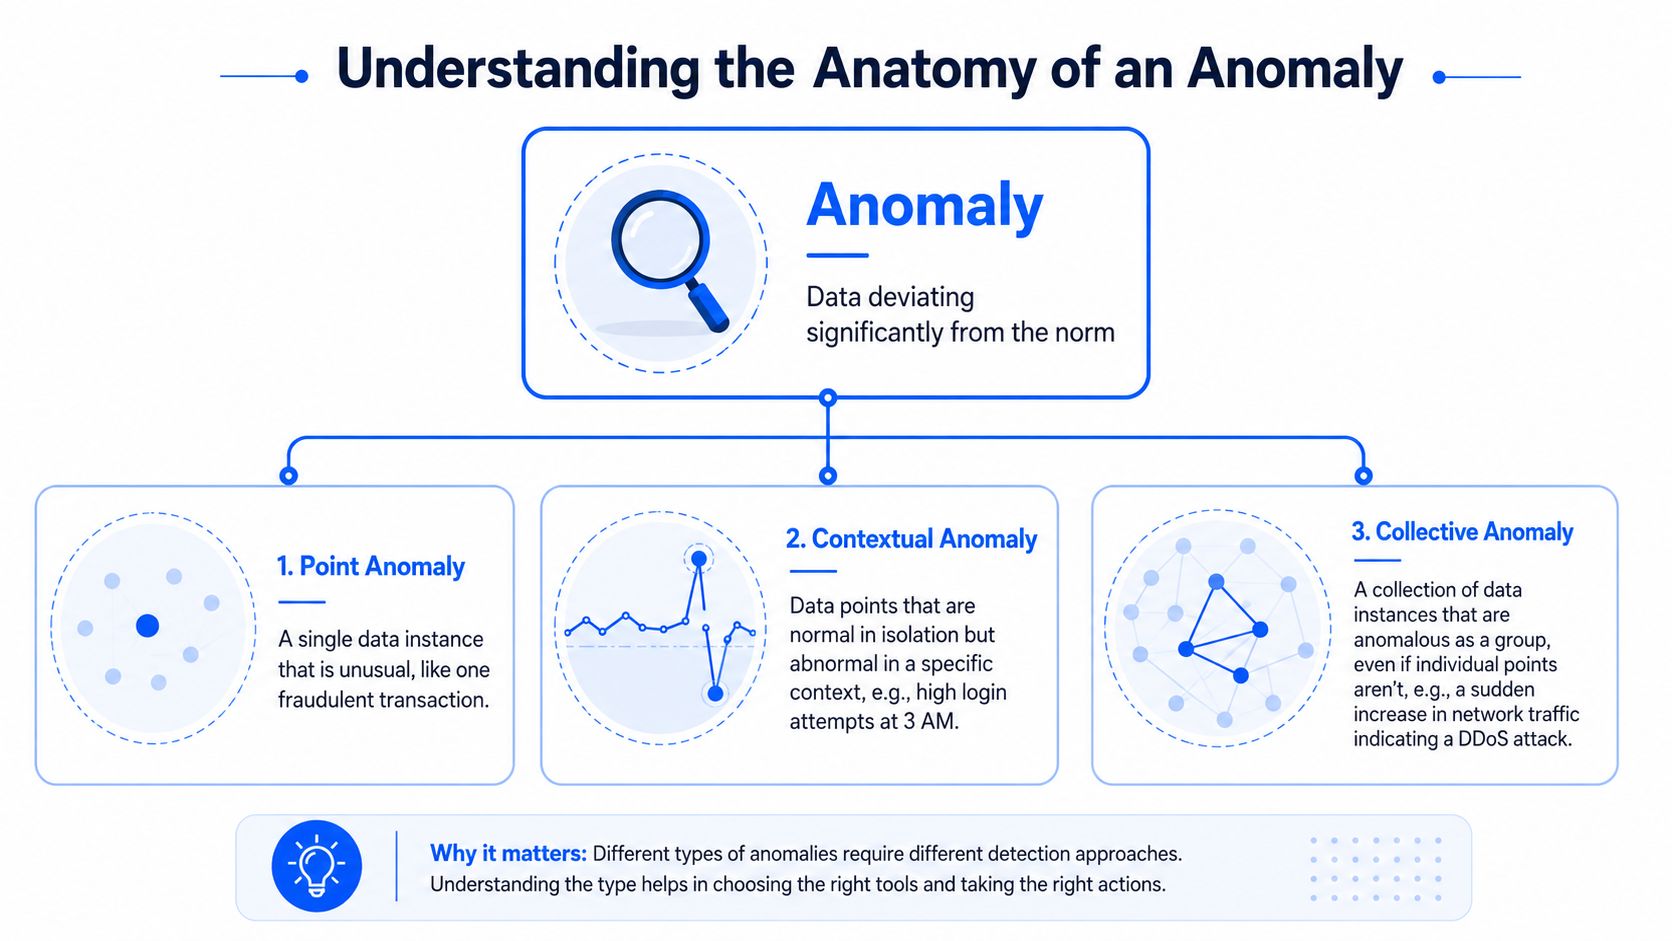
Anomalies ponctuelles
Une anomalie ponctuelle est la plus facile à se représenter. Un événement, une valeur, une ligne semble anormal. Pensez à une transaction par carte unique très éloignée du comportement habituel d’un client, ou à un chargement d’entrepôt avec un nombre d’enregistrements impossible.
Ce sont généralement les premiers cas pris en compte, car ils se traduisent facilement en alertes. Une valeur est trop élevée, trop basse, trop précoce, trop tardive ou trop éloignée de la norme.
Anomalies contextuelles
Une anomalie contextuelle semble normale jusqu’à ce que vous preniez en compte le moment, la saisonnalité ou les conditions environnantes. Un volume de connexions élevé à midi peut être normal. Le même volume à 3 h du matin sur un système interne sensible peut être un signal sérieux.
Les plateformes de données le constatent souvent. Un fichier arrivé tardivement peut être normal selon le calendrier d’un jour férié, mais alarmant un jour de bourse. Un pic de trafic peut être attendu lors du lancement d’une campagne, mais suspect pendant un week-end calme.
Anomalies collectives
L’anomalie collective est celle face à laquelle la surveillance en entreprise s’effondre souvent. Les enregistrements individuels semblent inoffensifs, mais le groupe forme un schéma qui ne devrait pas exister. Une attaque coordonnée de bots, une dérive de schéma subtile sur plusieurs champs ou une séquence d’événements qui évoluent ensemble peuvent tous entrer dans cette catégorie.
Un simple seuillage ne permet pas de saisir le contexte. Les équipes ont besoin de méthodes qui détectent les relations entre colonnes, fenêtres temporelles et entités.
Une mauvaise ligne est facile à repérer. C’est un mauvais schéma réparti dans un jeu de données d’apparence saine qui nuit à la confiance en production.
Pourquoi les seuils statiques échouent ici
Les seuils statiques sont séduisants parce qu’ils sont faciles à expliquer. Ils sont aussi coûteux à maintenir. Chaque nouvelle source, chaque schéma saisonnier et chaque exception métier ajoute de nouvelles règles. Au bout du compte, le système devient si bruyant que les gens l’ignorent.
Les plateformes modernes les remplacent par l’apprentissage adaptatif des références. Comme le décrit la présentation par digna des techniques de détection d’anomalies par IA, les systèmes de détection d’anomalies par machine learning profilent en continu le volume des enregistrements, les valeurs manquantes et les distributions de valeurs afin de définir dynamiquement les limites attendues, ce qui aide à détecter en temps réel des erreurs silencieuses comme des enregistrements manquants ou dupliqués.
Ce modèle d’exploitation change le quotidien des équipes data :
Moins de maintenance des règles : Les ingénieurs n’ont pas à régler manuellement les seuils pour chaque table et chaque métrique.
Une meilleure couverture : Le système peut surveiller des changements de comportement qui ne sont pas assez évidents pour être codés manuellement.
Des investigations plus transparentes : Les équipes peuvent comparer le comportement actuel aux références apprises au lieu de débattre de la justesse d’un seuil.
Ce que cela signifie dans la pratique de l’observabilité
En matière d’observabilité, la détection d’anomalies n’est pas isolée du reste de la pile. Elle côtoie la surveillance de la ponctualité, le suivi des schémas et la validation. L’un repère un schéma de métrique inattendu. Un autre confirme un retard. Un autre encore révèle une nouvelle colonne ou un changement de type de données. Ensemble, ils expliquent pourquoi la confiance a été rompue.
C’est là toute la valeur pratique. Vous ne vous contentez pas de détecter des valeurs aberrantes. Vous protégez les décisions métier contre des données qui, en apparence, restent disponibles, fraîches et interrogeables.
Les quatre grandes approches de machine learning
La bonne approche dépend moins de la popularité d’un algorithme que de ce dont dispose votre équipe data. Les labels, des références historiques stables, la structure séquentielle, le budget de calcul, les besoins de latence et la capacité de revue comptent tous davantage que la nouveauté.
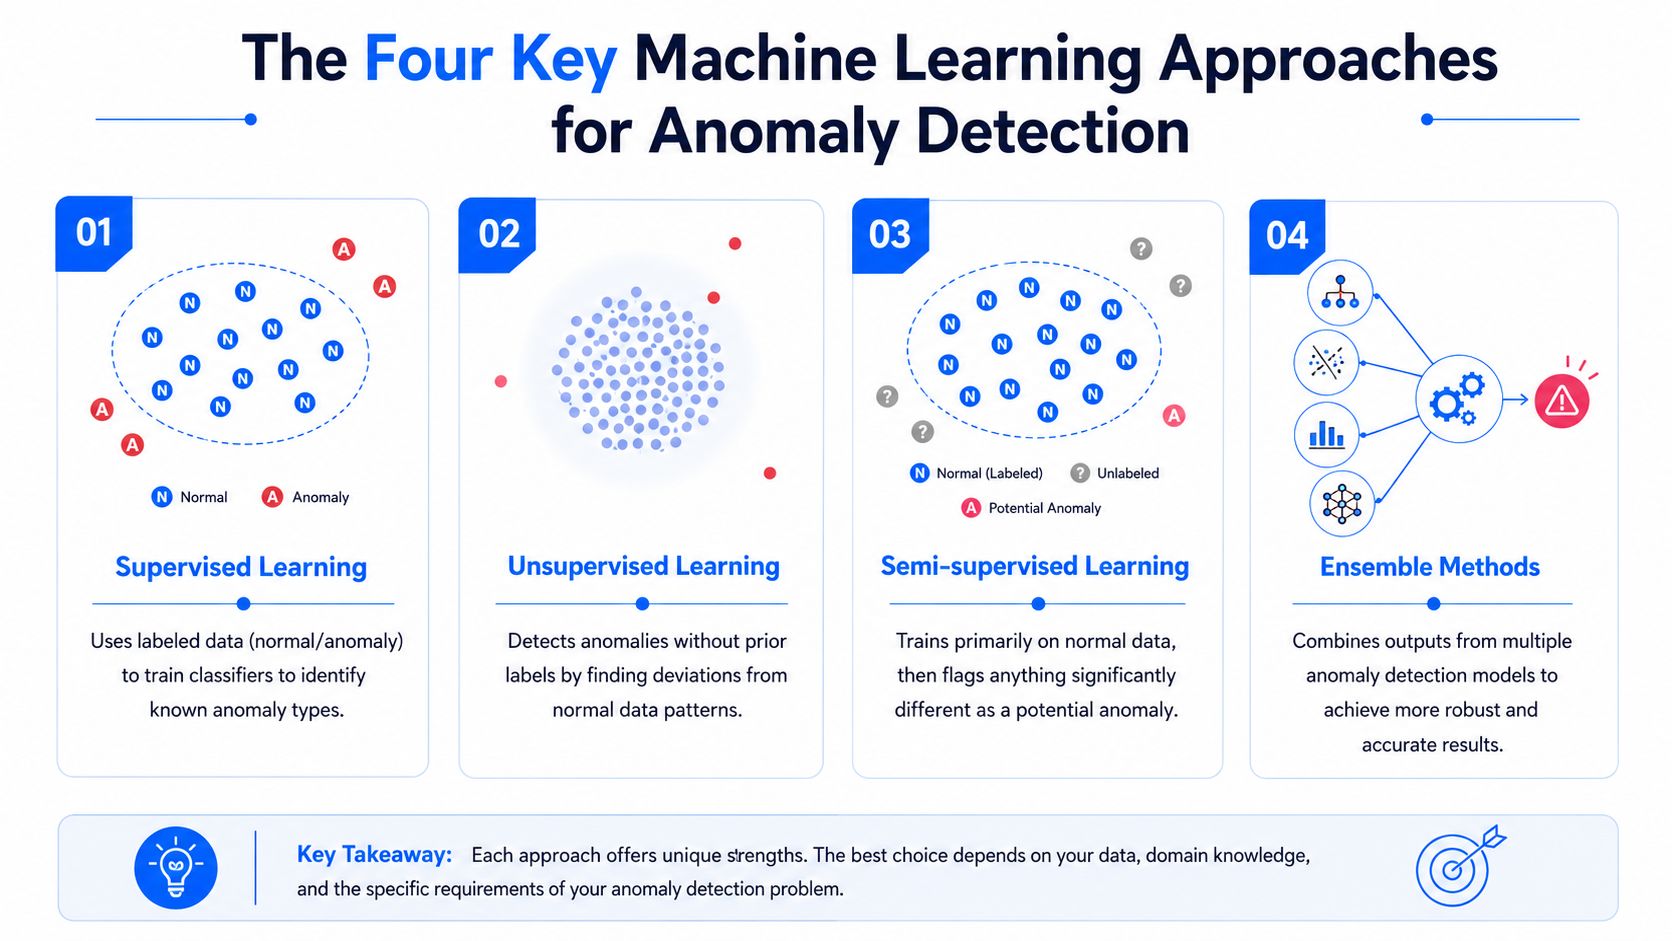
Apprentissage supervisé
La détection supervisée fonctionne lorsque vous savez déjà à quoi ressemble un problème et disposez de labels pour le prouver. Les systèmes de lutte contre la fraude, les pipelines d’examen des sinistres et certains processus de sécurité peuvent la justifier, car ils accumulent au fil du temps des incidents examinés.
L’avantage est la précision sur les modes de défaillance connus. Si vos anomalies labellisées sont représentatives, un classifieur peut apprendre directement ces schémas.
L’inconvénient est opérationnel. Les labels sont rares, coûteux et souvent obsolètes. Les problèmes de données en entreprise changent aussi de forme. La classe d’anomalies du trimestre dernier ne couvrira peut-être pas le bogue d’intégration de ce trimestre.
Recourez aux approches supervisées lorsque :
Des anomalies examinées existent : Votre équipe dispose de labels de haute qualité fournis par des analystes, des enquêteurs antifraude ou les opérations de sécurité.
Les types de défaillance se répètent : Vous faites face à des classes d’anomalies récurrentes et bien comprises.
Les actions à mener sont définies : Le métier sait déjà quoi faire lorsque le système signale un problème.
Apprentissage non supervisé
Les méthodes non supervisées sont la norme dans de nombreuses plateformes de données, car les labels sont souvent indisponibles. Le système recherche des écarts dans les données elles-mêmes plutôt que des exemples d’événements défaillants connus.
C’est souvent la voie la plus pratique pour l’observabilité en entreprise. Vous pouvez la déployer sur de nombreuses tables et métriques sans devoir d’abord mettre en place une activité de labellisation. Des méthodes comme le clustering, les modèles fondés sur l’isolement et le scoring fondé sur les distances entrent dans cette catégorie.
Une conception éprouvée en conditions réelles est décrite dans la documentation de Netdata sur la détection d’anomalies : un clustering k-means non supervisé avec k=2 sur des fenêtres glissantes, avec plusieurs modèles par métrique, qui rapporte une réduction de 99 % des faux positifs en exigeant un consensus unanime avant de signaler une anomalie. Cela rappelle utilement que les choix d’architecture peuvent compter autant que l’algorithme de base.
La première question en production n’est pas « Quel modèle est le plus intelligent ? », mais « Quelle approche peut résister à des données non labellisées, à des entrées bruitées et à la réalité des astreintes ? »
Apprentissage semi-supervisé
La détection semi-supervisée part d’une hypothèse pratique : vous ne connaissez peut-être pas toutes les anomalies, mais vous connaissez généralement un ensemble de données normales fiables. Le modèle apprend cette référence et considère les écarts significatifs comme suspects.
C’est particulièrement utile dans les pipelines d’entreprise, où les périodes saines sont plus faciles à identifier que les mauvaises. Vous pouvez entraîner le modèle sur des fenêtres historiques validées, puis évaluer les nouvelles données par rapport à cette représentation apprise.
Les méthodes semi-supervisées fonctionnent généralement bien lorsque :
Situation | Pourquoi le semi-supervisé aide |
|---|---|
Systèmes stables avec une dérive occasionnelle | Le modèle apprend une plage de fonctionnement normale claire |
Processus sensibles | Les équipes préfèrent une détection prudente ancrée dans des données fiables |
Faible fréquence des anomalies | Il n’y a pas assez d’exemples positifs pour l’apprentissage supervisé |
Deep learning
Le deep learning devient pertinent lorsque la structure est suffisamment complexe pour échapper aux modèles plus simples. Les signaux de séries temporelles, la télémétrie multivariée et les comportements de grande dimension entrent souvent dans cette catégorie.
Pour les séries temporelles industrielles et de pipelines, cette revue des méthodes de détection d’anomalies indique que des modèles de prévision LSTM combinés à la décomposition variationnelle en modes (VMD) peuvent extraire les composantes périodiques avant de détecter les anomalies dans les séries temporelles résiduelles. Concrètement, le modèle sépare d’abord le comportement normal récurrent du reste, puis vérifie si ce reste paraît suspect.
Le deep learning est utile lorsque :
les séquences comptent davantage que les enregistrements isolés
périodicité et dérive coexistent
le signal s’étend sur de nombreuses variables corrélées
Il implique aussi davantage de calcul, de réglages et de surveillance. Si une méthode plus simple détecte le problème avec une qualité de signal acceptable, elle constitue généralement le meilleur choix pour la production.
Les ensembles en pratique
De nombreux systèmes d’entreprise finissent par utiliser des méthodes d’ensemble, même si les équipes ne les décrivent pas ainsi. Elles combinent plusieurs détecteurs ou étapes de scoring pour réduire le bruit et améliorer la fiabilité.
Un ensemble pratique peut inclure un filtre statistique de référence, un score d’anomalie appris et une règle de validation. Un autre peut associer un autoencodeur à un seuillage fondé sur l’isolement. En production, les ensembles l’emportent souvent parce qu’ils tiennent compte d’une réalité désordonnée : un seul détecteur gère rarement bien toutes les tables, toutes les cadences et tous les modes de défaillance.
Choisir l’algorithme adapté à la tâche
Il n’existe pas de meilleur algorithme universel de détection d’anomalies. Il n’existe qu’un algorithme adapté à la structure de vos données, à la forme des anomalies, à vos exigences de latence et à votre processus de revue. Les équipes s’attirent des ennuis lorsqu’elles standardisent une méthode parce qu’elle a fonctionné une fois.
La distinction la plus importante consiste à savoir si vous devez détecter des anomalies globales ou des anomalies locales. Cela semble théorique jusqu’à ce que vous déployiez à grande échelle. Cela fait alors la différence entre repérer une véritable dérive et la manquer pendant des mois.
La distinction entre local et global compte
Certaines anomalies se situent très loin de l’ensemble du jeu de données. Ce sont des valeurs aberrantes globales. D’autres ne sont étranges qu’au sein d’un voisinage ou d’un cluster local. Ce sont des valeurs aberrantes locales.
Cette distinction modifie le choix du modèle. Selon des travaux publiés dans le Journal of Machine Learning Research, le choix de l’algorithme doit dépendre du caractère local ou global des anomalies. Lorsque les données contiennent plusieurs clusters de densité, les k plus proches voisins surpassent l’isolation forest, tandis que l’isolation forest convient mieux aux anomalies purement globales.
Cela concerne directement les données d’entreprise. Le comportement des clients se regroupe souvent par région, par produit ou par canal. Les métriques des équipements se regroupent par mode de fonctionnement. L’activité des utilisateurs se regroupe par rôle. Un point peut sembler normal globalement tout en étant très anormal au sein de son propre segment.
Aide-mémoire des algorithmes de détection d’anomalies
Algorithme | Type | Idéal pour | Point d’attention |
|---|---|---|---|
Isolation Forest | Détection des valeurs aberrantes globales | Anomalies claires et isolées dans des données tabulaires | Peut manquer des anomalies locales au sein de clusters denses |
k plus proches voisins (k-NN) | Fondé sur la densité locale et les distances | Jeux de données en clusters où le comportement du voisinage compte | Sensible à la mise à l’échelle et à la définition de la distance |
Local Outlier Factor | Fondé sur la densité locale | Détection d’enregistrements dont la densité locale est bien plus faible que celle des points voisins | Plus difficile à expliquer à des relecteurs non techniques |
Z-score | Référence statistique univariée | Contrôles rapides sur des métriques uniques aux distributions relativement stables | Faible sur les relations multivariées |
ECOD | Référence pour les valeurs aberrantes tabulaires | Référence légère pour les processus de qualité des données | À utiliser de préférence comme point de comparaison, pas comme réponse universelle |
LSTM | Modèle séquentiel | Séries temporelles avec dépendances temporelles et schémas récurrents | Coût opérationnel et effort de réglage plus élevés |
Autoencodeur | Fondé sur la reconstruction | Apprentissage de schémas normaux en grande dimension | Le seuillage et la gestion de la dérive demandent de l’attention |
Ce qui fonctionne pour les cas d’entreprise courants
Pour la surveillance de la qualité des données tabulaires, les références simples ont toujours leur place. Isolation Forest et ECOD sont des points de départ pratiques pour les colonnes, les métriques au niveau des lignes et les contrôles de santé des jeux de données.
Pour les données clients ou produits organisées en clusters, les méthodes fondées sur le voisinage méritent généralement d’être testées tôt. Si votre jeu de données présente plusieurs régimes de fonctionnement, les approches fondées sur la densité locale peuvent faire apparaître des anomalies que les méthodes globales lissent.
Pour les séries temporelles, choisissez en fonction de la quantité de mémoire qu’exige le schéma. Des contrôles d’écart à court terme peuvent fonctionner avec des méthodes statistiques plus simples. Des dépendances plus longues, la périodicité et le comportement résiduel peuvent justifier des modèles récurrents ou fondés sur la reconstruction. Si votre équipe évalue des conceptions propres aux séquences, ce guide sur la détection d’anomalies dans les séries temporelles est une référence opérationnelle utile.
Ne choisissez pas un algorithme parce qu’il est populaire. Choisissez-le parce que son mode de défaillance est acceptable pour vos données.
Les compromis que les équipes sous-estiment
L’algorithme n’est pas tout le système. Le succès en production dépend de plusieurs détails moins prestigieux :
Mise à l’échelle et prétraitement : Les modèles fondés sur les distances échouent lorsque les variables ne sont pas normalisées.
Interprétabilité : Les équipes de sécurité et les data stewards ont souvent besoin d’une raison, pas seulement d’un score.
Fréquence de réentraînement : Un détecteur performant se dégrade si le comportement de référence change et que personne ne le met à jour.
Processus de revue : Un modèle légèrement moins performant avec un tri plus propre l’emporte souvent sur un modèle plus performant qui inonde Slack.
C’est pourquoi le choix de l’algorithme doit se faire en parallèle de la conception opérationnelle, et non avant.
Comment mesurer le succès et éviter les fausses alertes
Lundi matin, le détecteur se déclenche sur 600 enregistrements. Douze nécessitent une action. Les autres sont des arrivées tardives normales, des changements de catalogue planifiés et un événement métier ponctuel. Si l’équipe doit trier cette pile chaque jour, le modèle échoue, même si son score hors ligne paraissait bon.

Pourquoi l’exactitude est trompeuse
L’exactitude masque la structure de coûts de la détection d’anomalies. Dans des jeux de données déséquilibrés, un modèle peut classer presque tout comme normal et paraître performant sur le papier. Cela n’aide ni l’analyste antifraude, ni le data steward, ni l’ingénieur plateforme qui a besoin que le système détecte les défaillances rares sans générer de bruit permanent.
Pour ce type de déséquilibre des classes, la précision, le rappel et le score F1 sont les métriques de départ habituelles. Les recommandations de Google en machine learning sur les métriques de classification pour les jeux de données déséquilibrés constituent une référence pratique si votre équipe a besoin d’une base commune pour l’évaluation.
Les métriques qui comptent en production
Chaque métrique répond à une question opérationnelle différente.
Précision : parmi les alertes envoyées à une personne ou à un système en aval, combien méritaient une action ?
Rappel : parmi toutes les anomalies, combien le détecteur en a-t-il repéré ?
Score F1 : dans quelle mesure la précision et le rappel sont-ils équilibrés lorsque vous avez besoin d’un seul chiffre pour comparer des modèles ?
Ces chiffres doivent correspondre à un coût métier. Dans les paiements, un rappel faible signifie des fraudes manquées. Dans les opérations data, une précision faible signifie que les files d’alertes se remplissent, que les équipes d’astreinte cessent de faire confiance au détecteur et que les incidents réels attendent plus longtemps avant d’être examinés.
Le réglage des seuils compte autant que le choix du modèle. Les équipes passent souvent des semaines à comparer des algorithmes, puis appliquent un seuil par défaut qui n’a jamais été ajusté à leur capacité de revue ni à la gravité des incidents.
Évaluer le processus d’alerte, pas seulement le modèle
Les jeux de test hors ligne sont utiles, mais ils passent à côté d’une réalité courante en entreprise : de nombreuses anomalies ne sont anormales que dans leur contexte.
Un changement de schéma peut correspondre à une version légitime. Un pic de commandes peut provenir d’une promotion planifiée. Un lot retardé peut correspondre à un SLA fournisseur modifié le trimestre dernier. Le détecteur peut signaler correctement le schéma et produire malgré tout une mauvaise alerte si le système manque de contexte métier.
Un meilleur processus d’évaluation comprend :
Des échantillons d’alertes examinés par les personnes responsables de la décision en aval.
Un scoring par segment, afin qu’une moyenne ne masque pas une défaillance dans une région, un niveau de clientèle ou un système source à haut risque.
Des tests de seuils au regard de la capacité de revue, pour confirmer que le volume quotidien d’alertes est gérable.
La collecte des retours, afin que les faux positifs et les vrais positifs confirmés améliorent les réglages futurs.
Pour les équipes qui construisent cette couche de revue, ce guide sur les méthodes d’identification des valeurs aberrantes est utile pour comparer, lors de la validation, des contrôles statistiques simples à des détecteurs fondés sur le ML.
Un rappel élevé avec une faible précision épuise les opérateurs. Une précision élevée avec un faible rappel crée des angles morts. Un détecteur utile s’adapte au modèle de réponse du métier.
Utiliser des références qui résistent à un audit
Commencez par une référence que l’équipe peut expliquer aux fonctions d’audit, de sécurité et d’exploitation. Il peut s’agir d’une règle fondée sur des percentiles, d’un seuil saisonnier ou d’un modèle non supervisé simple avec une logique de seuil claire. Si un détecteur plus complexe n’améliore qu’un benchmark hors ligne mais complique le tri, il n’a pas encore sa place dans le circuit d’alerte de production.
C’est encore plus important dans les environnements d’entreprise où les modèles s’exécutent au sein de l’entrepôt ou du lakehouse pour éviter de copier des données sensibles dans des systèmes séparés. L’exécution au sein de la base de données peut simplifier les contrôles de confidentialité et réduire les déplacements d’enregistrements réglementés, mais elle oblige aussi les équipes à choisir des métriques, des seuils et des processus de revue compatibles avec les outils d’observabilité existants. Le succès ne consiste pas seulement à détecter des anomalies. Il consiste à détecter les bonnes anomalies, avec un volume de revue que l’organisation peut absorber durablement.
Considérations sur le déploiement et la surveillance en entreprise
La plupart des écrits sur la détection d’anomalies par machine learning s’arrêtent au choix du modèle. Les équipes d’entreprise échouent généralement plus tard, lors du déploiement. Elles découvrent que le modèle exige trop de déplacements de données, enfreint les attentes en matière de confidentialité, alourdit l’exploitation ou produit des seuils qui perdent leur pertinence avec le temps.
Ce ne sont pas des problèmes marginaux. C’est le véritable travail de mise en œuvre.
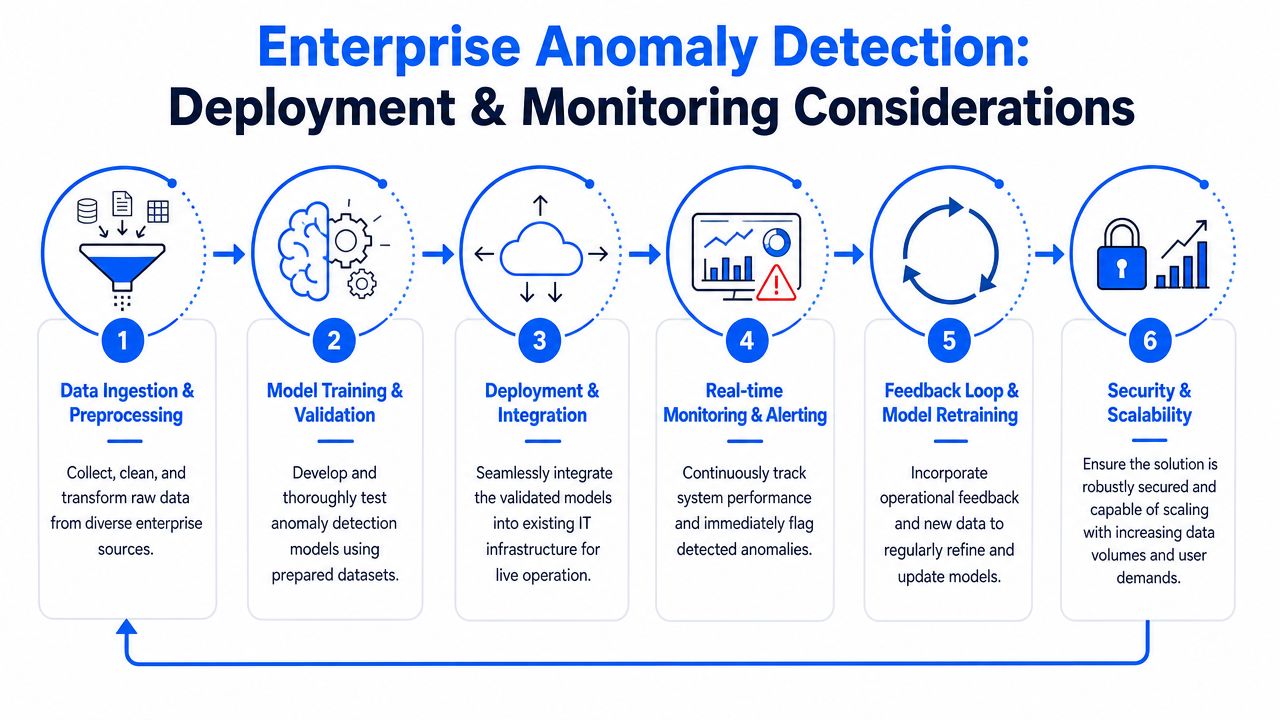
Temps réel ou traitement par lots
Toutes les anomalies n’ont pas besoin d’un scoring immédiat. Certains processus métier peuvent tolérer une détection par lots, où le système examine des fenêtres horaires ou quotidiennes. D’autres non. L’examen de la fraude, la télémétrie opérationnelle, les flux de données soumis à des SLA et les tableaux de bord de direction nécessitent souvent des boucles de rétroaction bien plus courtes.
Le compromis est simple :
Mode de déploiement | Fonctionne bien lorsque | Compromis |
|---|---|---|
Scoring en temps réel | Le retard est coûteux ou sensible au risque | Complexité d’infrastructure et d’exploitation plus élevée |
Détection par lots | Les tendances comptent davantage qu’une réponse instantanée | Les problèmes peuvent être découverts après l’impact en aval |
Les équipes surestiment souvent leur besoin de temps réel et sous-estiment le coût de sa maintenance. Si l’action métier a de toute façon lieu le lendemain matin, un scoring nocturne peut suffire.
L’exécution au sein de la base de données change l’équation économique
Dans les environnements d’entreprise, l’endroit où le modèle s’exécute peut compter autant que ce qu’il fait. Extraire des données de production vers une pile de surveillance externe ajoute de la latence, des revues de gouvernance, des coûts et de l’exposition. Cela duplique aussi la logique entre les systèmes.
Exécuter l’analyse au sein de la base de données ou de l’entrepôt du client résout plusieurs problèmes pratiques à la fois :
La confidentialité est mieux préservée : Les enregistrements sensibles restent dans l’environnement contrôlé.
Les performances s’améliorent : Moins de déplacements de données signifie moins de goulets d’étranglement.
L’exploitation se simplifie : Les équipes évitent d’exporter de grands ensembles de métriques uniquement pour les évaluer ailleurs.
La gouvernance est plus simple : Les équipes de sécurité et de conformité préfèrent généralement les architectures comportant moins de copies de données.
C’est un domaine où l’architecture du produit compte. Par exemple, digna repose sur le calcul des métriques et l’apprentissage des références au sein de la base de données, tout en fonctionnant en cloud privé ou sur site, ce qui le rend pertinent pour les équipes qui ont besoin de détection d’anomalies, de surveillance de la ponctualité, de suivi des schémas et de validation sans accès du fournisseur aux jeux de données de production.
Les seuils dynamiques ne sont pas facultatifs
Les seuils statiques ne résistent pas à des distributions changeantes. Ce problème devient sérieux à l’échelle d’une entreprise, car chaque jeu de données évolue différemment. Les nouvelles zones géographiques, les nouveaux canaux, les nouveaux calendriers métier et l’évolution des usages invalident tous les limites réglées manuellement.
Des travaux récents résumés dans cette recherche sur le seuillage dynamique des anomalies mettent en avant une réponse pratique : des systèmes fondés sur des autoencodeurs combinés à l’isolation forest peuvent utiliser un seuillage tenant compte des valeurs aberrantes pour adapter dynamiquement les seuils en fonction du comportement normal appris. C’est important, car le réglage manuel des seuils ne passe pas à l’échelle sur de vastes périmètres d’observabilité.
Surveiller le détecteur lui-même
Un détecteur d’anomalies est un système de production comme un autre. Il a besoin de sa propre surveillance.
Surveillez la dérive des entrées : si les schémas ou les distributions en amont changent, les scores d’anomalie peuvent perdre leur sens.
Suivez le volume d’alertes : une hausse soudaine peut indiquer de véritables incidents ou une dégradation du détecteur.
Mesurez les résultats des revues : si les analystes rejettent régulièrement les alertes d’un détecteur, réentraînez-le ou remplacez-le.
Versionnez soigneusement la logique du modèle : les changements dans l’ingénierie des variables ou dans les fenêtres peuvent modifier le comportement des alertes autant qu’un changement d’algorithme.
Un détecteur qui n’est pas surveillé devient une nouvelle défaillance silencieuse en puissance.
L’observabilité va au-delà des anomalies
Les configurations d’entreprise les plus utiles ne traitent pas la détection d’anomalies comme une fonctionnalité isolée. Elles la relient à la ponctualité, à la validation et à la surveillance des schémas. Une anomalie de volume prend tout son sens lorsque le même système montre aussi un chargement source retardé ou un changement de type de colonne. L’analyse des causes profondes s’accélère, car les opérateurs n’ont pas à passer d’un outil déconnecté à un autre.
C’est cette vision plus large qui rend la détection d’anomalies exploitable plutôt que simplement intéressante.
Bonnes pratiques et pièges courants à éviter
Les équipes obtiennent de meilleurs résultats lorsqu’elles traitent la détection d’anomalies par machine learning comme une discipline opérationnelle et non comme une expérimentation de modèles. Les déploiements les plus solides sont généralement ennuyeux, au bon sens du terme : un objectif clair, des entrées propres, une responsabilité définie et des retours mesurés.
Les bonnes pratiques qui tiennent en production
Partez d’une conséquence métier : reliez la détection à une défaillance réelle, comme des prévisions faussées, un reporting retardé, l’examen de la fraude ou des entrées de modèle corrompues.
Profilez les données avant de choisir le modèle : utilisez la mise à l’échelle des variables, le traitement des valeurs manquantes et une ingénierie des variables pertinente si nécessaire. Comme le résume cette présentation des méthodes de détection d’anomalies et du prétraitement, la normalisation, l’imputation, l’ingénierie des variables et le réglage des hyperparamètres sont des éléments essentiels de processus de détection d’anomalies efficaces.
Commencez par des références simples : une méthode statistique de base ou fondée sur des arbres peut révéler si le signal existe avant que vous n’investissiez dans des architectures plus lourdes.
Définissez la responsabilité de la revue des alertes : quelqu’un doit confirmer si une anomalie signalée est réelle et si le circuit de réponse a fonctionné.
Réentraînez de manière délibérée : les références vieillissent. Planifiez explicitement le réentraînement et la revue des seuils en fonction de l’évolution des données, plutôt que de compter sur la chance.
Les pièges qui créent du bruit et de la méfiance
Certaines erreurs reviennent régulièrement.
Un seul algorithme partout : les événements clients, les transactions financières, les flux de capteurs et les métriques de qualité au niveau des tables se comportent rarement de la même manière.
Ignorer le contexte : un pic sans informations sur le calendrier métier, la planification ou le segment génère souvent de fausses alertes.
Négliger le prétraitement : les méthodes fondées sur les distances et sur la densité se dégradent rapidement avec des entrées non mises à l’échelle ou de mauvaise qualité.
Considérer les alertes comme une vérité définitive : un score d’anomalie est une aide à la décision, pas une preuve de la gravité d’un incident.
Oublier les utilisateurs en aval : si le résultat n’est pas compréhensible pour les analystes, les opérateurs ou les data stewards, le système n’influencera pas les décisions.
Une liste de contrôle pratique
Avant de mettre un détecteur en production, vérifiez que ces questions ont des réponses claires :
Contrôle | Pourquoi c’est important |
|---|---|
Quelle action métier suit une alerte ? | Une détection sans réponse crée du bruit |
Quel type d’anomalie ciblons-nous ? | Les cas ponctuels, contextuels et collectifs nécessitent une logique différente |
Avons-nous besoin d’une sensibilité locale ou globale ? | Cela modifie sensiblement le choix de l’algorithme |
Comment évaluerons-nous la qualité ? | La précision, le rappel et le score F1 sont plus utiles que l’exactitude |
Où le scoring s’exécutera-t-il ? | L’architecture de déploiement influe sur la confidentialité, le coût et la latence |
Qui examine et labellise les cas limites ? | Les retours maintiennent l’utilité du système dans le temps |
La détection d’anomalies par machine learning gagne la confiance lorsqu’elle repère les problèmes tôt, fournit suffisamment d’explications pour permettre l’action et s’adapte aux réalités des opérations data en entreprise. Cela implique généralement moins d’obsession pour la nouveauté des modèles et plus de discipline en matière d’architecture, de boucles de revue et d’intégration à l’observabilité.
Si votre équipe a besoin d’une détection d’anomalies adaptée aux contraintes de l’entreprise, digna est une option à évaluer. Il se concentre sur les anomalies de données, la validation, la ponctualité et le suivi des schémas, avec une exécution au sein de la base de données dans des environnements contrôlés par le client, ce qui est utile lorsque la confidentialité, la simplicité opérationnelle et l’intégration à l’observabilité comptent autant que le modèle de détection lui-même.
Pour des références apprises sur les volumes des tables, les valeurs manquantes et les distributions de valeurs, sans seuils réglés manuellement, découvrez comment digna Data Anomalies exécute la détection d’anomalies au sein de votre base de données.
Questions fréquentes
Qu’est-ce que la détection d’anomalies par machine learning ?
Elle remplace les règles écrites à la main par des références apprises : le système modélise le comportement attendu et signale les écarts significatifs, repérant des erreurs silencieuses comme des enregistrements dupliqués, des horodatages tardifs ou des distributions qui dérivent. L’article cite des travaux montrant que les méthodes de ML surpassent les approches statistiques traditionnelles de 8 à 12 % en exactitude, en particulier sur des données multivariées de grande dimension.
Que sont les anomalies ponctuelles, contextuelles et collectives ?
Les anomalies ponctuelles sont des valeurs isolées qui semblent erronées, comme un chargement d’entrepôt avec un nombre d’enregistrements impossible. Les anomalies contextuelles dépendent du moment ou des conditions, comme un volume de connexions élevé à 3 h du matin. Les anomalies collectives sont des groupes d’enregistrements d’apparence inoffensive qui forment un mauvais schéma, comme une attaque coordonnée de bots ou une dérive de schéma sur plusieurs champs.
Faut-il utiliser une détection d’anomalies supervisée ou non supervisée ?
L’approche non supervisée est généralement le choix pratique par défaut, car les anomalies labellisées sont rares et coûteuses. Les méthodes supervisées conviennent lorsque des incidents examinés existent et que les types de défaillance se répètent, comme dans la lutte contre la fraude ou l’examen des sinistres. La configuration k-means non supervisée de Netdata avec k=2 a permis une réduction de 99 % des faux positifs en exigeant un consensus entre plusieurs modèles.
Isolation forest ou k plus proches voisins : lequel est le meilleur pour la détection d’anomalies ?
Cela dépend du caractère global ou local des anomalies. Des travaux publiés dans le Journal of Machine Learning Research ont montré que les k plus proches voisins surpassent l’isolation forest lorsque les données contiennent plusieurs clusters de densité, tandis que l’isolation forest convient aux valeurs aberrantes purement globales. Les données clients regroupées par région ou par canal nécessitent souvent l’approche locale, fondée sur le voisinage.
Comment mesurer les performances d’un détecteur d’anomalies ?
Laissez de côté l’exactitude, qui paraît élevée sur des données déséquilibrées même lorsqu’un modèle considère presque tout comme normal. Utilisez la précision, le rappel et le score F1, puis testez les seuils au regard de votre capacité de revue réelle : un détecteur qui se déclenche sur 600 enregistrements alors que seuls douze nécessitent une action échoue, quel que soit son score hors ligne.



