Définition de la curation de données : des données brutes aux actifs fiables
|
5
minute de lecture

La curation des données est le processus actif et continu de gestion des données tout au long de leur cycle de vie, afin qu'elles restent adaptées à leur usage, faciles à découvrir et réutilisables. En pratique, c'est la discipline qui transforme les données brutes en un actif d'entreprise fiable, au lieu d'une source récurrente de tableaux de bord cassés, de métriques contradictoires et de retouches évitables.
Si vous lisez ceci, il y a de fortes chances que votre équipe dispose déjà de nombreuses données. Ce qui vous manque, c'est la certitude que les données signifient la même chose d'un rapport à l'autre, qu'elles arrivent au moment prévu ou que quelqu'un puisse retracer un chiffre jusqu'à sa source sans avoir à ouvrir cinq outils et à interroger trois personnes.
C'est précisément dans cet écart que la plupart des équipes de données rencontrent des difficultés. Un rapport d'activité est publié. Un collaborateur de la finance, des opérations ou du produit remarque un chiffre qui ne correspond pas à un autre tableau de bord. La réunion cesse alors de porter sur la question métier pour se transformer en enquête. Dès que cela se produit à plusieurs reprises, les parties prenantes ne se contentent plus de remettre en question un seul graphique. Elles remettent en question l'ensemble du pipeline.
C'est pourquoi une définition claire de la curation des données est essentielle. Il ne s'agit pas d'un jargon universitaire. C'est un modèle opérationnel permettant de rendre les données utilisables, compréhensibles et suffisamment durables pour soutenir l'analytique, l'IA et les décisions quotidiennes.
Table des matières
Introduction : Pourquoi chaque équipe de données a besoin d'une stratégie de curation
Explication de la définition fondamentale de la curation des données
Le cycle de vie de la curation des données et les rôles clés
Comment les outils modernes d'Observability facilitent la curation des données
Votre liste de contrôle de mise en œuvre et les pièges courants
Introduction : Pourquoi chaque équipe de données a besoin d'une stratégie de curation
Le scénario de défaillance classique est simple. Un tableau de bord semble correct jusqu'à ce que quelqu'un remarque que le chiffre d'affaires total exclut une nouvelle ligne de produits, ou qu'un KPI hebdomadaire a chuté parce qu'un champ en amont a changé de type sans que personne ne s'en aperçoive. Le problème technique est parfois mineur, mais l'impact sur la confiance ne l'est généralement pas.
Les équipes réagissent souvent en nettoyant le jeu de données qui a posé problème. Cela aide temporairement, mais ne résout pas le dysfonctionnement systémique. Le rapport était erroné parce que personne n'a traité ce jeu de données comme un produit nécessitant une responsabilité, une documentation, une validation, du contexte et une maintenance continue dans le temps.
C'est précisément ce qu'apporte la curation des données. Selon la définition de la curation de données par la NISO (National Information Standards Organization), il s'agit de la gestion active et continue des données tout au long de leur cycle de vie afin de garantir qu'elles restent adaptées à leur usage et disponibles pour la découverte et la réutilisation. Cette définition est utile car elle impose un changement d'état d'esprit. Le travail ne s'arrête pas au chargement des données. L'objectif est de les maintenir utilisables.
Règle pratique : Si personne ne peut expliquer la signification d'un jeu de données, les modifications qu'il a subies et si l'on peut s'y fier aujourd'hui, alors il n'est pas curé. Il est simplement stocké.
Une stratégie de curation efficace transforme la façon de travailler des ingénieurs et des analystes. Les pipelines s'interrompent au niveau de barrières de qualité plutôt que de publier des enregistrements défectueux sans contrôle. Les analystes disposent de métadonnées et de définitions métier claires plutôt que de devoir deviner le sens des noms des colonnes. Les gestionnaires de données identifient clairement à qui incombe la responsabilité historique. Les utilisateurs de données savent quels actifs sont approuvés pour des décisions opérationnelles et lesquels sont purement exploratoires.
Trois aspects ont tendance à s'améliorer lorsque la curation fait partie intégrante de la livraison :
La confiance dans les rapports : Les équipes passent moins de temps à débattre de la validité d'un chiffre.
La rapidité d'analyse : Les analystes trouvent et interprètent les jeux de données plus rapidement grâce au contexte disponible.
La fiabilité des produits en aval : Les fonctionnalités de ML, les tableaux de bord et les rapports opérationnels tombent moins souvent en panne, car les problèmes de structure et de qualité sont gérés plus tôt.
Cela est d'autant plus crucial au sein des grandes entreprises où les données transitent par des entrepôts de données, des modèles de BI, des tâches d'ETL inversé et des systèmes d'IA. La collecte brute crée un potentiel, mais c'est la curation qui rend ce potentiel exploitable.
Explication de la définition fondamentale de la curation des données
En pratique, une définition de la curation des données commence au moment précis où la donnée brute entre en production. Le fichier est reçu, la table est chargée, le pipeline a fonctionné. Rien de tout cela ne signifie que la donnée est prête pour les rapports, l'ingénierie des fonctionnalités ou les décisions opérationnelles.
La curation est le travail continu de transformation de données stockées en un actif fiable que d'autres équipes peuvent trouver, comprendre, exploiter en toute confiance et réutiliser. Cela englobe la sélection, la standardisation, la documentation, le contrôle qualité, la traçabilité (lineage), les règles d'accès et la maintenance continue. Dans les environnements d'entreprise, ce travail doit résister aux dérives de schémas, aux changements en amont, aux ruptures de responsabilités et à l'apparition permanente de nouveaux modes d'utilisation.
La comparaison avec un musée reste pertinente, mais les aspects opérationnels importent davantage que l'analogie. Les conservateurs ne se contentent pas de garder des objets dans une pièce. Ils décident de ce qui intègre la collection, documentent la provenance, préservent l'état, décrivent le contexte et facilitent la recherche. Les équipes de données font de même avec les jeux de données, les colonnes, les modèles et les définitions métier.
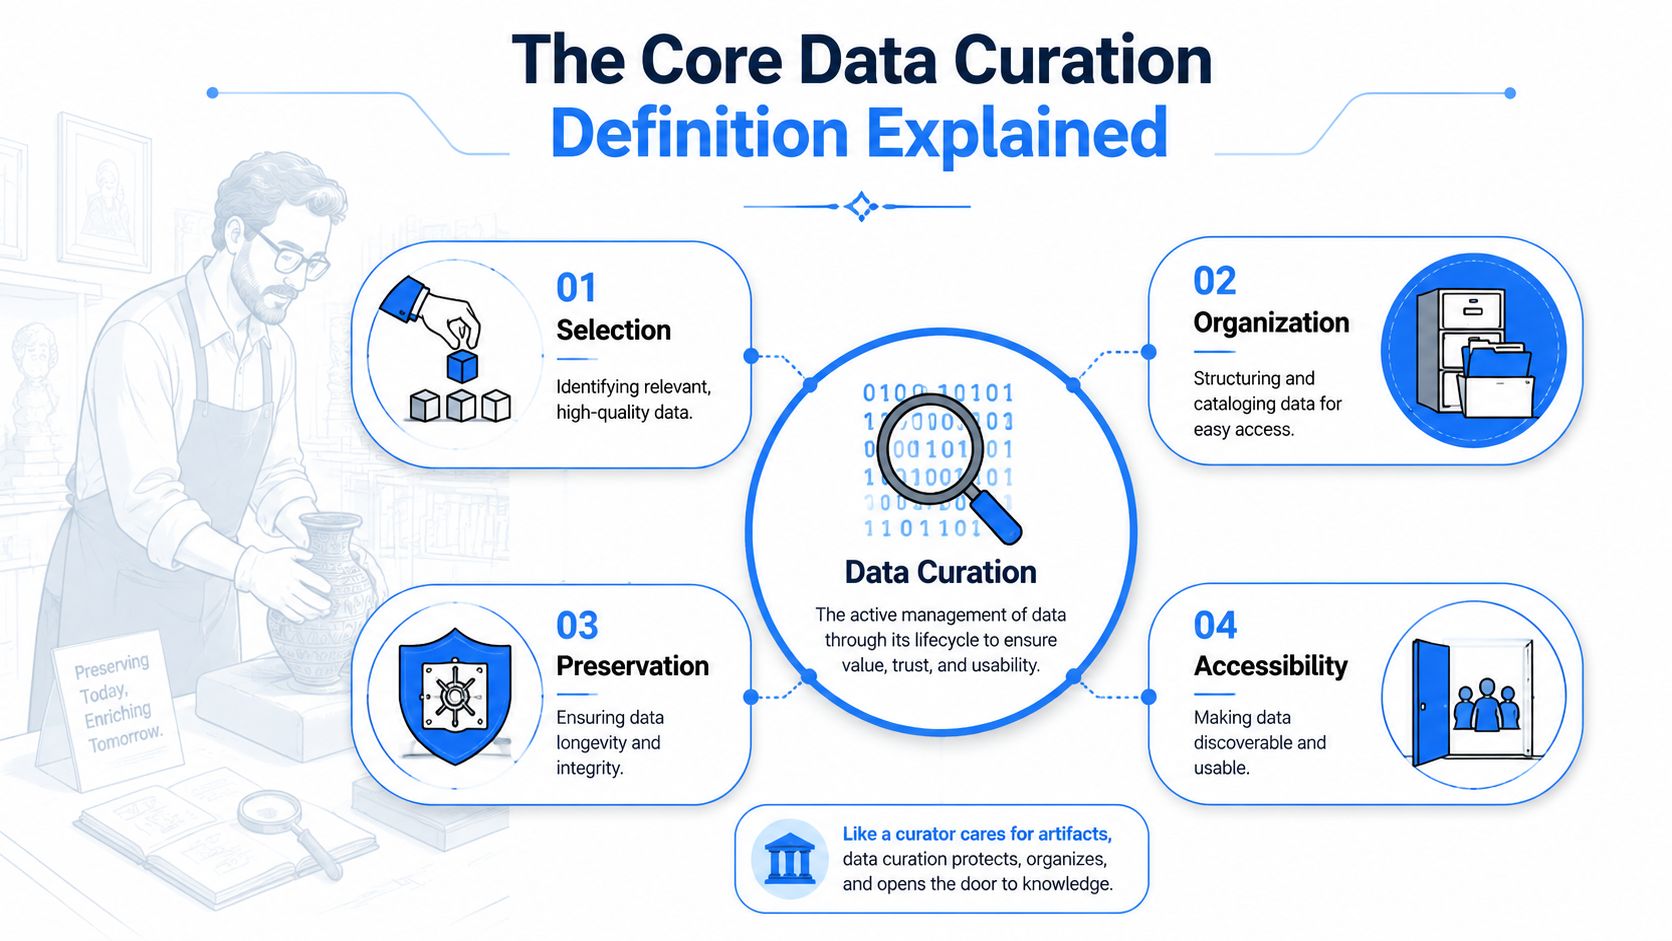
Pourquoi le simple stockage ne suffit pas
Le stockage maintient les données disponibles. La curation les rend utilisables.
Un entrepôt de données peut contenir chaque événement généré par vos applications tout en étant inutile pour l'entreprise. C'est un cas fréquent avec les données comportementales. La table existe, mais les noms des événements changent sans préavis, les horodatages mélangent les fuseaux horaires, les identifiants clients ne correspondent pas au CRM, et personne ne peut dire quelles colonnes sont fiables pour les rapports de direction. Les ingénieurs déclarent le service livré. Les analystes le qualifient d'inutilisable. C'est précisément ce fossé que la curation s'efforce de combler.
Comme mentionné précédemment, les définitions standards de la curation des données la décrivent comme une gestion de cycle de vie active visant à maintenir les données prêtes pour l'analyse et la réutilisation. Le modèle FAIR est très utile ici car il fournit un test opérationnel pour valider si un jeu de données est exploitable.
À quoi ressemble le principe FAIR en pratique
Le principe FAIR se concrétise lorsqu'il est intégré aux processus de déploiement :
Facile à trouver (Findable) : Le jeu de données est répertorié dans le catalogue avec des métadonnées interrogeables, une indication claire de responsabilité, des étiquettes et une description métier qui en précise l'usage opérationnel.
Accessible : Les utilisateurs autorisés peuvent l'interroger ou l'exploiter par des voies d'accès documentées, selon des contrôles de sécurité conformes aux politiques d'entreprise.
Interopérable (Interoperable) : Les clés, formats, données de référence et conventions de nommage sont standardisés afin de faciliter les jointures et la modélisation en aval.
Réutilisable (Reusable) : Les utilisateurs visualisent la traçabilité (lineage), l'actualité des données, les limites connues, l'historique des modifications et les hypothèses appliquées lors des transformations.
Il existe un test très simple en pratique : un nouvel analyste ou ingénieur ML doit être capable de s'approprier l'actif de données et de l'utiliser seul, sans avoir besoin d'explications de la part du créateur initial du pipeline.
Atteindre ce niveau de qualité manuellement et à grande échelle est complexe. Les définitions dérivent, les pipelines évoluent, les collaborateurs s'en vont et de nouvelles tables apparaissent plus vite que les équipes ne peuvent les documenter. C'est pourquoi les plateformes modernes de Data Observability jouent un rôle clé dans la curation. Elles rendent le processus reproductible en suivant la fraîcheur, les changements de schéma, les ruptures de traçabilité et les baisses de qualité lors des opérations quotidiennes, plutôt que d'en faire un exercice de documentation ponctuel.
Pour les produits de données (data products), les avantages sont évidents. Des données curées limitent les erreurs d'interprétation, accélèrent l'onboarding des nouveaux profils et réduisent le risque de voir des tableaux de bord, des modèles de ML ou des tâches d'ETL inversé basés sur des sources instables. C'est toute la différence entre une donnée qui existe simplement et une donnée sur laquelle l'entreprise peut s'appuyer.
Le cycle de vie de la curation des données et les rôles clés
Il est préférable de considérer la curation comme un cycle de vie opérationnel plutôt que comme une tâche ponctuelle. Le flux de travail est concret et continu. La présentation du fonctionnement par Atlan le définit comme une gestion active qui comprend l'identification des jeux de données de valeur, l'évaluation de leur précision et de leur exhaustivité, la création de catalogues de métadonnées et la maintenance continue des données afin d'éviter que leur qualité ne se détériore.
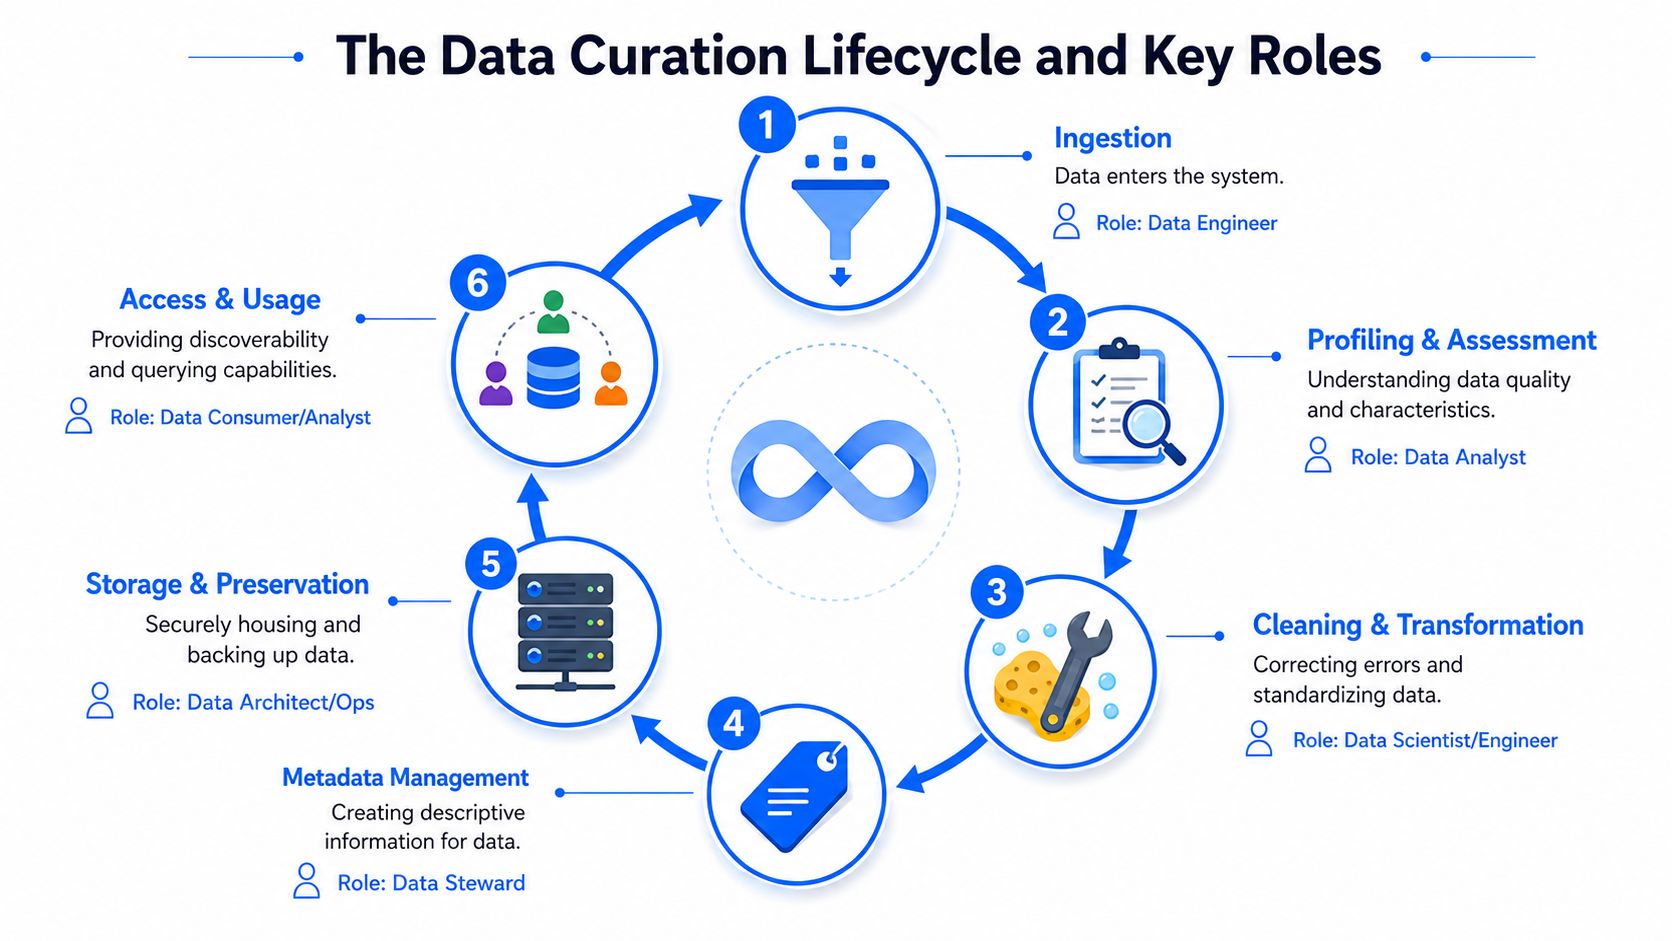
Le cycle de vie, de la donnée brute à l'actif réutilisable
Dans les environnements de production, le cycle de vie de la donnée se déploie généralement ainsi :
Identification et sourcing
Les équipes sélectionnent les jeux de données méritant un effort de curation d'après leur valeur pour l'entreprise, leurs dépendances en aval et les risques associés. Toutes les tables brutes ne justifient pas le même investissement ; les actifs à fort impact en ont besoin en priorité.Nettoyage et validation Les ingénieurs et analystes évaluent l'exactitude, l'exhaustivité, la cohérence et la fiabilité des données. À cette étape, les valeurs manquantes, les doublons, les formats incorrects et les jointures suspectes sont identifiés et corrigés.
Transformation et enrichissement
La donnée brute est standardisée pour créer des modèles exploitables. Les unités sont alignées, les clés sont normalisées, les règles de gestion métier sont appliquées et les données issues de plusieurs systèmes sont intégrées dans une structure cohérente.Métadonnées et catalogage
L'actif curé reçoit un nom, une description, une classification et se voit associer son propriétaire ainsi que sa traçabilité. Cette étape rend le jeu de données facile à découvrir et simple à comprendre, plutôt que simplement disponible.Archivage et préservation
Les équipes déterminent ce qui doit être conservé, historisé ou archivé. L'intégrité à long terme est cruciale, notamment au sein des environnements réglementés ou soumis à des audits de conformité.Maintenance continue
Même curée, la donnée évolue. Les schémas se modifient, les applications sources changent de comportement et les définitions métiers s'affinent. Sans maintenance continue, la curation s'érode rapidement.
Qui est responsable de quoi
Les rôles ont parfois tendance à se chevaucher dans les petites équipes, mais les responsabilités restent biens distinctes.
Rôle | Focus principal | Contribution type |
|---|---|---|
Data Engineer | Fiabilité et transformation des pipelines | Développe l'ingestion, les tests, la gestion des schémas et la livraison des flux |
Data Steward | Définitions, gouvernance et conformité | Gère les métadonnées, assigne les responsabilités, harmonise la terminologie et les règles d'usage |
Data Analyst ou Analytics Engineer | Signification métier et utilisabilité | Valide les métriques, modélise les couches de données curées et vérifie l'interprétation des utilisateurs |
Data Architect | Architecture système et choix de conservation | Définit les standards de stockage, de versioning, d'accès et d'interopérabilité |
Domain Owner | Signification opérationnelle | Confirme que les règles de gestion traduisent fidèlement les processus réels de l'entreprise |
En pratique, la clé du succès réside dans une gouvernance partagée avec des transferts clairs. En revanche, confier la « qualité des données » à tout le monde sans nommer de responsable officiel est voué à l'échec.
Un jeu de données curé doit avoir un propriétaire désigné, un groupe d'utilisateurs identifié et un processus de maintenance établi. Autrement, l'actif de données dérivera dès le départ de son concepteur d'origine.
Curation vs Nettoyage, Governance et Management
Ces notions sont fréquemment confondes, et cette confusion nuit à l'efficacité de leur mise en œuvre. De nombreuses équipes affirment faire de la curation alors qu'elles se contentent de corriger des anomalies à la volée. D'autres lancent des initiatives de Data Governance en pensant que la seule rédaction de chartes suffira à améliorer la qualité de leurs jeux de données.
Une comparaison pratique
Voici une approche simple pour distinguer ces différentes disciplines.
Discipline | Objectif principal | Périmètre d'action | Exemple d'activité |
|---|---|---|---|
Data Curation | Rendre les données prêtes à l'usage, compréhensibles et réutilisables | À l'échelle du jeu de données et du produit sur l'ensemble de son cycle de vie | Création de métadonnées, validation de la qualité, documentation de la traçabilité, gestion des versions |
Data Cleaning | Corriger les anomalies immédiates des données | Au niveau de l'enregistrement et du champ individuel | Suppression des doublons, standardisation des formats, gestion des valeurs nulles |
Data Governance | Définir les règles, les responsabilités et les chartes | À l'échelle de l'entreprise | Attribution des rôles, définition des droits d'accès et des standards |
Data Management | Administrer l'infrastructure technologique globale des données | Au niveau de l'infrastructure et de l'organisation générale | Gestion du stockage, de l'intégration, de la sécurité et des contrôles opérationnels |
Le nettoyage fait partie de la curation, mais il n'en constitue qu'un élément. La gouvernance définit quant à elle les principes de propriété, de sécurité et de standards, mais elle ne crée pas de jeu de données exploitable à elle seule. Le management est encore plus vaste, puisqu'il englobe toute l'infrastructure opérationnelle entourant le stockage, les flux et l'administration.
Là où les équipes s'y perdent
L'erreur la plus fréquente consiste à réduire la curation au simple nettoyage. Le nettoyage est par nature réactif : un problème survient et on le corrige. La curation est proactive et continue : l'équipe conçoit le jeu de données pour que les utilisateurs puissent l'exploiter, le comprendre et s'y fier dans la durée.
La seconde erreur consiste à penser que la gouvernance seule va résoudre les problèmes opérationnels. Les chartes d'entreprise sont nécessaires, mais elles doivent se traduire concrètement dans le quotidien. Si votre équipe d'ingénierie cherche à définir des modèles de propriété ou des processus de validation, ce guide pratique sur comment mettre en œuvre la data governance se révélera très utile pour décliner les règles théoriques en processus opérationnels.
Un test rapide permet d'évaluer la situation. Posez-vous ces quatre questions sur un jeu de données :
Les utilisateurs peuvent-ils le trouver facilement ?
Peuvent-ils en comprendre précisément le sens ?
Peuvent-ils se fier aux données en temps réel ?
Peuvent-ils le réutiliser sans devoir solliciter le créateur d'origine ?
Si la réponse est négative pour la plupart de ces points, le problème ne relève probablement pas d'un manque de nettoyage, mais bien d'un manque de curation.
Pratiques concrètes pour une curation de données réussie
Les bons programmes de curation ne reposent pas sur des exploits individuels. Ils s'appuient sur des pratiques reproductibles qui rendent la qualité des données transparente et le contexte pérenne.
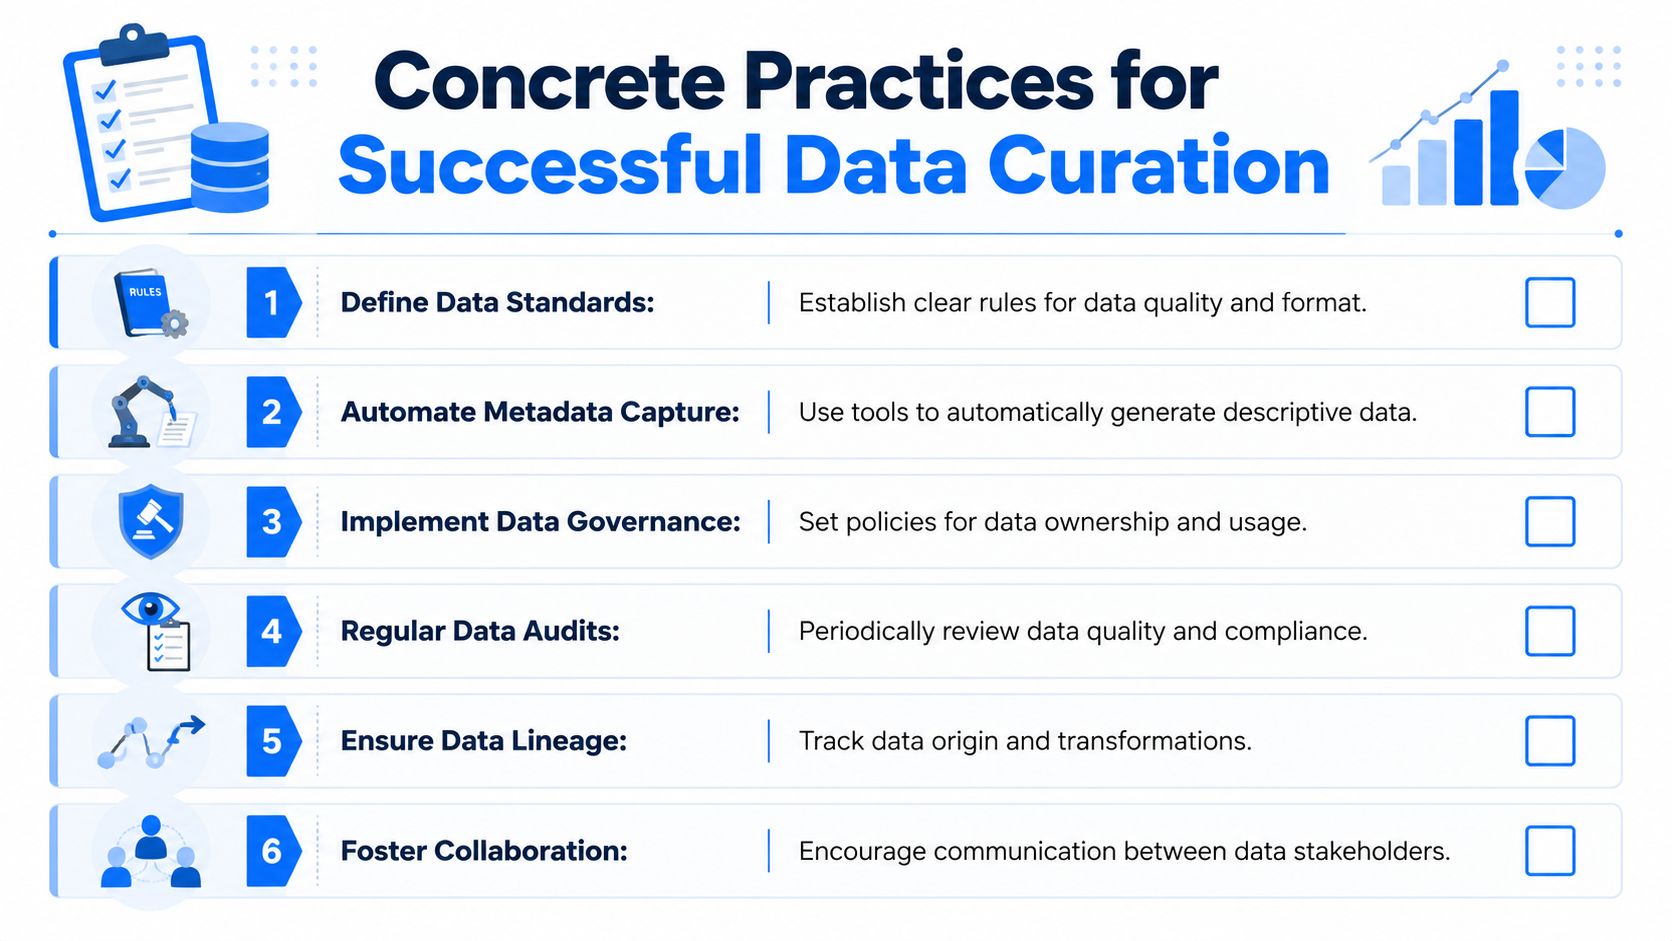
Pratiques qui tiennent la route en production
Adoptez en priorité des exigences claires que les ingénieurs peuvent intégrer à leurs processus de livraison.
Définir les dimensions de qualité : Fixez des objectifs explicites en matière d'exactitude, d'exhaustivité, de cohérence, de fraîcheur et de validité. Faute de critères partagés, les revues de qualité tournent rapidement aux débats d'opinion.
Collecter des métadonnées riches : Un actif de données valorisable requiert des définitions métiers claires, des indications sur les sources, le contexte de ses transformations, ses propriétaires et des conseils d'utilisation. Les seuls noms de colonnes ne suffisent pas à documenter.
Gérer les versions de vos jeux de données : Si un modèle, un tableau de bord ou un rapport critique repose sur un jeu de données, la gestion des versions est indispensable. Les modifications silencieuses rendent l'analyse des incidents bien plus complexe.
Documenter la traçabilité (lineage) : Les utilisateurs de la donnée doivent être en mesure de comprendre comment une donnée brute s'est transformée pour devenir un indicateur final. C'est un prérequis pour le débogage ainsi que pour la conformité réglementaire.
Valider les règles métiers : S'assurer de la validité de la structure est insuffisant. Les enregistrements doivent également respecter la logique métier, à l'image des états autorisés, des contraintes d'intégrité ou des dépendances de valeurs entre champs.
Auditer régulièrement : L'ensemble de vos actifs curés doit faire l'objet de revues périodiques, car les formats sources, les processus d'entreprise et les contextes sémantiques évoluent constamment.
Les équipes découvrent souvent l'importance de ces enjeux lors de projets de migration. Une bascule d'infrastructure ou une refonte d'application fait rapidement ressortir les angles morts non documentés. Si votre entreprise planifie un tel projet, ce guide de migration de bases de données se révélera précieux pour structurer la démarche et garantir l'intégrité de la donnée lors des changements de schémas.
Note de terrain : Des métadonnées rédigées dans l'urgence après une panne sont rarement complètes. Celles intégrées dès le départ du projet d'ingénierie se révèlent précieuses pour l'équipe suivante.
Comment évaluer si la curation fonctionne
Il est inutile de concevoir des indicateurs complexes pour valider vos progrès. Fiez-vous simplement aux signaux concrets émis par vos opérations quotidiennes, le ressenti des utilisateurs et la stabilité de votre système.
Observez notamment les indicateurs suivants :
Accélération du délai d'analyse : Les analystes perdent moins de temps à identifier et déchiffrer les schémas de données.
Adoption forte des données qualifiées : Les équipes délaissent d'elles-mêmes les extractions ad hoc au profit des modèles consolidés et documentés.
Diminution des sollicitations de support : Les ingénieurs reçoivent moins de requêtes du type « qu'exprime cette colonne ? » ou « d'où vient ce changement de tendance dans mon dashboard ? ».
Résolution rapide des pannes : En cas d'incident technique, l'accès direct aux informations de traçabilité et de propriété permet de réduire considérablement le temps de diagnostic.
Stabilité des produits finaux : Vos outils décisionnels, processus d'ETL inversés ou fonctionnalités de ML souffrent moins de ruptures dues à des failles évitables sur la source.
Mesurer la curation au seul volume de documents rédigés ou de tickets fermés est une erreur. C'est l'usage serein de la donnée au quotidien, et non les processus administratifs, qui en détermine le succès.
Comment les outils modernes d'Observability facilitent la curation des données
Un projet d'ingénierie documenté le lundi peut perdre toute crédibilité dès le mercredi. Une équipe modifie un champ à la source, un pipeline prend du retard ou une formule de calcul dérive légèrement, altérant le tableau de bord sans pour autant déclencher d'alerte système. À l'échelle de l'entreprise, s'assurer de la qualité n'est plus une formalité documentaire : c'est un véritable modèle opérationnel.
Pourquoi la curation manuelle échoue à grande échelle
Les analyses manuelles fonctionnent sur des volumes limités et des environnements stables. Elles atteignent leurs limites dès que de multiples équipes déploient des pipelines, que les architectures de données évoluent fréquemment et que différents utilisateurs finaux s'appuient sur ces tables pour leurs analyses, leviers marketing ou modèles prédictifs. Les listes de tâches manuelles sur tableur ou les pages de documentation en ligne ne peuvent rivaliser avec la réalité opérationnelle de la production.
La curation moderne nécessite des relevés automatiques et continus sur l'état de la donnée. L'Observability apporte cette réactivité en suivant les indicateurs de fraîcheur des livraisons, l'évolution des structures, la traçabilité des flux, le volume d'appels et les anomalies de valeurs dans les opérations de tous les jours. Pour les équipes en quête de repères théoriques clairs, cet article expliquant ce qu'est la data observability en pratique établit la corrélation entre surveillance intelligente et confiance globale dans les données, bien au-delà de la seule vérification opérationnelle des flux.
Le compromis est simple à comprendre : multiplier les points de contrôle accroit les métriques récoltées, au risque d'engendrer de nombreuses fausses alertes si la configuration manque de précision. Les organisations performantes n'appliquent pas la même rigueur partout. Elles déploient des règles très strictes sur leurs produits critiques tout en s'appuyant sur des méthodes légères pour les flux secondaires.
Ce que l'observabilité automatise efficacement
Un outil d'Observability performant prend en charge la détection répétitive des incidents techniques, libérant ainsi du temps pour les gestionnaires de données, les analystes ainsi que les ingénieurs d'infrastructure afin qu'ils se concentrent sur la résolution, la gouvernance de données et les choix d'architecture.
Voici les chantiers de curation automatisables les plus fréquents :
Détection automatique d'anomalies : Les outils signalent immédiatement les écarts inhabituels de volumétrie, les taux de valeurs manquantes anormaux ou les dérives de métriques d'activité. L'éclairage complémentaire d'Oracle au sujet d'anomaly detection basée sur l'IA montre à quel point l'analyse prédictive dynamique s'adapte aux évolutions réelles de l'activité plutôt que de s'en remettre à des barèmes figés. C'est essentiel pour la curation car l'activité fluctue selon la saisonnalité, l'état des marchés ou le comportement global des clients.
Surveillance des modifications structurelles : Les suppressions de colonnes, changements de typologies de variables ou renommages d'objets dégradent souvent l'affichage final dans les dashboards des utilisateurs métiers bien avant qu'ils ne s'en rendent compte.
Contrôle qualité des attributs : Les validations métiers telles que l'unicité de valeurs, le respect de référentiels d'identifiants uniques ou le dépassement de seuils critiques se transforment en tests exécutés de manière continue.
Suivi des délais de livraison : Les retards, dysfonctionnements partiels ou absences de mise à jour des données sont directement qualifiés d'incidents d'intégrité dès lors qu'ils impactent l'expérience utilisateur.
Analyse historique des variations : Les équipes distinguent facilement un signal temporaire isolé d'une réelle dérive qualitative de fond, optimisant la priorisation des chantiers de correction.
En pratique, l'observabilité s'impose comme le moteur indispensable d'une approche industrialisée en unifiant métadonnées, traçabilité, revues de qualité et alertes opérationnelles. C'est l'essence même d'un produit de données durablement entretenu, à l'inverse du projet de nettoyage ponctuel.
Certaines directions ont besoin de partenaires technologiques de confiance pour déployer la curation de données auprès d'architectures modernes basées sur des infrastructures Lakehouse ou d'entrepôts distribués. Si vous cherchez un tel accompagnement, un comparatif comme compare Databricks consulting services vous permettra d'identifier le partenaire le plus pertinent selon vos contraintes d'environnements de données et d'objectifs de livraison.
Votre liste de contrôle de mise en œuvre et les pièges courants
Le constat d'un besoin de curation intervient généralement suite à une rupture de confiance majeure. Un indicateur financier fait une anomalie à la suite d'un changement applicatif, un modèle prédictif s'exécute sur des données incomplètes ou les analystes avancent différentes versions de calcul pour le même KPI. Résoudre ces situations ne nécessite pas d'emblée la mise en place d'un programme lourd de réformes, mais plutôt un déploiement ciblé et sous contrôle, doté de responsables clairs, d'exigences explicites et d'alertes détectant les écarts de qualité avant que les utilisateurs métiers n'en pâtissent.
Une liste de contrôle de départ pratique
Sélectionnez en priorité un jeu de données dont l'impact sur les choix opérationnels est avéré. Ce projet pilote sera plus motivant si son effet levier sur l'activité est parlant et si son envergure technique reste maitrisable pour les équipes.
Identifier un jeu de données prioritaire : Sélectionnez une table d'entités directement rattachée à un tableau de bord à forte visibilité, une automatisation opérationnelle ou un modèle prédictif métier.
Établir des contraintes opérationnelles minimales : Déterminez d'un commun accord les critères satisfaisants pour l'usage du fichier, parmi lesquels les contraintes sémantiques, les objectifs de fraîcheur et la tolérance face aux anomalies.
Attribuer les responsabilités : Identifiez l'ingénieur en charge des pipelines, le responsable fonctionnel garant des définitions ainsi que le point de contact métier validant l'usage légitime de la donnée.
Documenter le socle sémantique : Décrivez les systèmes émetteurs, les définitions des attributs, les plans de rafraîchissement des flux, les applications consommatrices et les restrictions identifiées.
Industrialiser les contrôles : Mettez en place des tests automatiques sur les modifications de structure, les retards de traitement, les anomalies de volumes et les incohérences métiers.
Planifier des revues périodiques : Identifiez et traitez ensemble à intervalle régulier les incidents récents, les métadonnées manquantes, les questions de gouvernance et les évolutions souhaitées.
Une check-list efficace ne cherche pas à accumuler de la documentation pour le plaisir. Elle jette les bases logiques d'un produit de données durable et résilient. L'apport d'outils d'Observability est ici déterminant : les revues manuelles n'offrent plus de garanties suffisantes lorsque la donnée est mise à jour fréquemment par des profils hétérogènes.
Les modes de défaillance courants à surveiller
Les écueils des démarches de curation surviennent en général dans le quotidien opérationnel des équipes, rarement au niveau des plans d'intention théoriques.
Absence d'implication des utilisateurs métiers : Les ingénieurs gèrent les contraintes de formats ainsi que la disponibilité technologique des flux, mais ils ne peuvent arbitrer le sens fonctionnel d'un indicateur sans l'appui des décideurs finaux.
Documentation reléguée au second plan : Repousser la rédaction de la documentation d'architecture favorise la transmission informelle d'informations clés, ce qui aggrave les pannes techniques et fragilise l'entreprise lors des départs de collaborateurs ou d'audits réglementaires.
Périmètre initial trop étendu : Viser trop large génère de l'attente sur les validations, dilue les responsabilités et éparpille les exigences alors que le processus n'est pas encore maîtrisé par l'équipe.
Gouvernance collégiale indifférenciée : Le partage flou des responsabilités nuit à la résolution des anomalies techniques. Un incident nécessite avant tout un décisionnaire identifié.
Approche uniquement technologique : Les outils guident les équipes dans la détection des failles et l'organisation des flux d'alertes, mais ils ne créent pas la confiance à eux seuls.
Agissez en priorité là où la confiance est la plus entamée. Rétablir un seul produit de données à fort impact vous attirera davantage de soutien interne que de chercher à curer un grand volume de données secondaires.
Éviter ces écueils requiert une réelle rigueur. L'apport d'une solution logicielle dédiée unifie et automatise les validations de conformité, la visualisation de la traçabilité et les flux opérationnels de résolution, vous évitant de fastidieux suivis manuels.
Si votre organisation souhaite structurer sa curation de données pour la rendre opérationnelle, digna peut vous aider à repérer les anomalies, valider les règles métiers, suivre les modifications de structure et anticiper les retards de livraison dans vos infrastructures de production, garantissant ainsi l'intégrité de vos produits de données à grande échelle.


