Créer un jeu de données
|
8
minute de lecture

Vous pouvez déployer un jeu de données qui semble propre en staging, passe chaque test unitaire, et tout de même perturber l'activité deux semaines plus tard. J'ai vu cela se produire lorsqu'une discrète normalisation de fuseau horaire a modifié les totaux de revenus dans un tableau de bord et qu'une tâche marketing a continué à ingérer des ID utilisateurs nuls parce que rien au moment de la construction ne considérait ce champ comme critique. Le plus douloureux, c'est que l'équipe avait déjà qualifié le jeu de données de « terminé ».
C'est l'erreur que la plupart des guides laissent de côté. Le travail de Create data set n'est pas une étape finale de livraison, c'est la première étape d'un processus de contrôle continu, de la même manière que le National Institute of Standards and Technology définit la qualité des données comme une capacité façonnée par l'accessibilité, la pertinence, la Timeliness, les métadonnées, la documentation, les capacités des utilisateurs, le contexte et le coût, la génération, l'évaluation et l'amélioration formant un cycle plutôt qu'une ligne d'arrivée (document de perspective du NIST). En production, le jeu de données n'est pas réel tant que personne ne s'en approprie la responsabilité, ne le surveille, n'en gère les versions et ne sait ce qui doit se passer lorsqu'il dérive.
Table des matières
Quand un jeu de données terminé n'est que le début
L'équipe pensait que le jeu de données sur les événements clients était solide. Il comportait des colonnes typées, une construction propre et les contrôles habituels de valeurs nulles, ils l'ont donc publié et sont passés à autre chose. Deux semaines plus tard, la finance a remarqué une dérive des totaux de revenus, et le marketing a découvert qu'une tâche de segmentation avait accepté des enregistrements avec des ID utilisateurs manquants.
La cause profonde n'était pas spectaculaire. Une règle de normalisation du fuseau horaire a changé en amont, et personne n'a considéré cela comme un changement majeur parce que le schéma n'avait pas bougé. Dans le même temps, le jeu de données autorisait les valeurs nulles dans un champ que les consommateurs en aval supposaient obligatoire, de sorte que les mauvais enregistrements ont circulé jusqu'à ce qu'un segment de campagne paraisse plus grand qu'il ne l'aurait dû. C'est le piège : un jeu de données peut être syntaxiquement correct et tout de même opérationnellement erroné.
Le véritable échec résidait dans le contrôle, non dans la construction
Un jeu de données en production nécessite plus qu'une construction réussie. Il a besoin de seuils d'acceptation, de détection de dérive, de propriété et d'un chemin de retour en arrière, car la définition de « bon » change dès lors que de vrais consommateurs en dépendent. Cette idée s'aligne avec la réalité de l'entreprise selon laquelle une mauvaise qualité des données coûte cher, et qu'une faible proportion seulement des données de l'entreprise est considérée comme conforme aux normes de qualité de base dans les recherches sectorielles largement citées (chiffre Gartner et résumé associé).
Règle pratique : si un tableau de bord, un modèle ou un flux de travail en aval peut échouer silencieusement, le jeu de données n'est pas encore terminé.
Le reste du travail consiste à prévenir le type exact de rupture qui apparaît après le lancement. Un garde-fou aurait détecté le changement de fuseau horaire. Un autre aurait signalé les ID utilisateurs nuls avant que l'équipe marketing ne s'y fie. Le reste de cet article constitue le guide de prévention.
Concevoir le schéma avant d'écrire une seule requête
Les erreurs de schéma coûtent cher car elles se figent rapidement. Une fois que les équipes commencent à charger et à modéliser autour d'une table, modifier le grain ou réinterpréter une colonne devient un projet de migration, pas une simple refactorisation propre. La solution la plus sûre est de décider de la structure avant la première extraction, puis de documenter les choix afin que personne n'ait à deviner l'intention initiale plus tard.
Commencer par le grain, les clés et la sémantique temporelle
Choisissez le grain de manière explicite. Si une ligne représente un événement utilisateur, indiquez-le dans le document de conception et dans la description de la table, car cette décision dicte la déduplication, l'agrégation et les jointures en aval. Utilisez des clés de substitution là où des identifiants naturels stables ne sont pas garantis, et figez les horodatages en UTC avec un décalage source documenté pour que les futurs consommateurs puissent reconstruire l'heure locale sans deviner.
Une table user_events mal conçue montre généralement ses problèmes dans les noms de colonnes. On y trouve un mélange de casses, des booléens ambigus comme is_active, des valeurs de event_type en texte libre qui dérivent vers des quasi-doublons, et des horodatages dont la signification change selon la personne qui les a chargés. Une version rigoureuse semble d'une simplicité rassurante, avec des enums ou des catégories contrôlées pour les types d'événements, des indicateurs de nullité ayant une signification explicite, et des identifiants stables qui ne dépendent pas de ce que l'application en amont a bien pu générer cette semaine-là.
Utiliser des noms qui survivent aux opérations réelles
La nomenclature des entrepôts et des lacs de données doit indiquer clairement où se situe une table dans le pipeline. Des préfixes comme raw_, stg_, et dim_ rendent cela visible, ce qui est crucial lorsque quelqu'un cherche à comprendre si une table est prête pour l'ingestion, la transformation ou la consommation. Si vous souhaitez une taxonomie plus approfondie des options structurelles, le guide interne sur les types de schémas est une référence utile.
Documentez chaque colonne avant que la première ligne n'arrive. Un fichier schema.yml, ou des commentaires dans information_schema, oblige l'équipe à déclarer le type, la signification, les valeurs autorisées et la propriété pendant que la conception est encore facile à modifier.
Domaine de décision | Anti-pattern | Prêt pour la production |
|---|---|---|
Grain | Implicite, déduit plus tard | Déclaré explicitement avant la construction |
Identifiant principal | Clé naturelle composite provenant de sources instables | Clé de substitution ou identifiant durable stable |
Horodatages | Heures locales mixtes, sans note de décalage | UTC avec décalage source documenté |
Booléens |
| Indicateur nullable avec sémantique écrite |
Types d'événements | Chaînes de caractères en texte libre | Catégories contrôlées ou valeurs de type enum |
Documentation | Ajoutée après le lancement | Rédigée avant le premier chargement |
Sourcer les données sans perdre la provenance
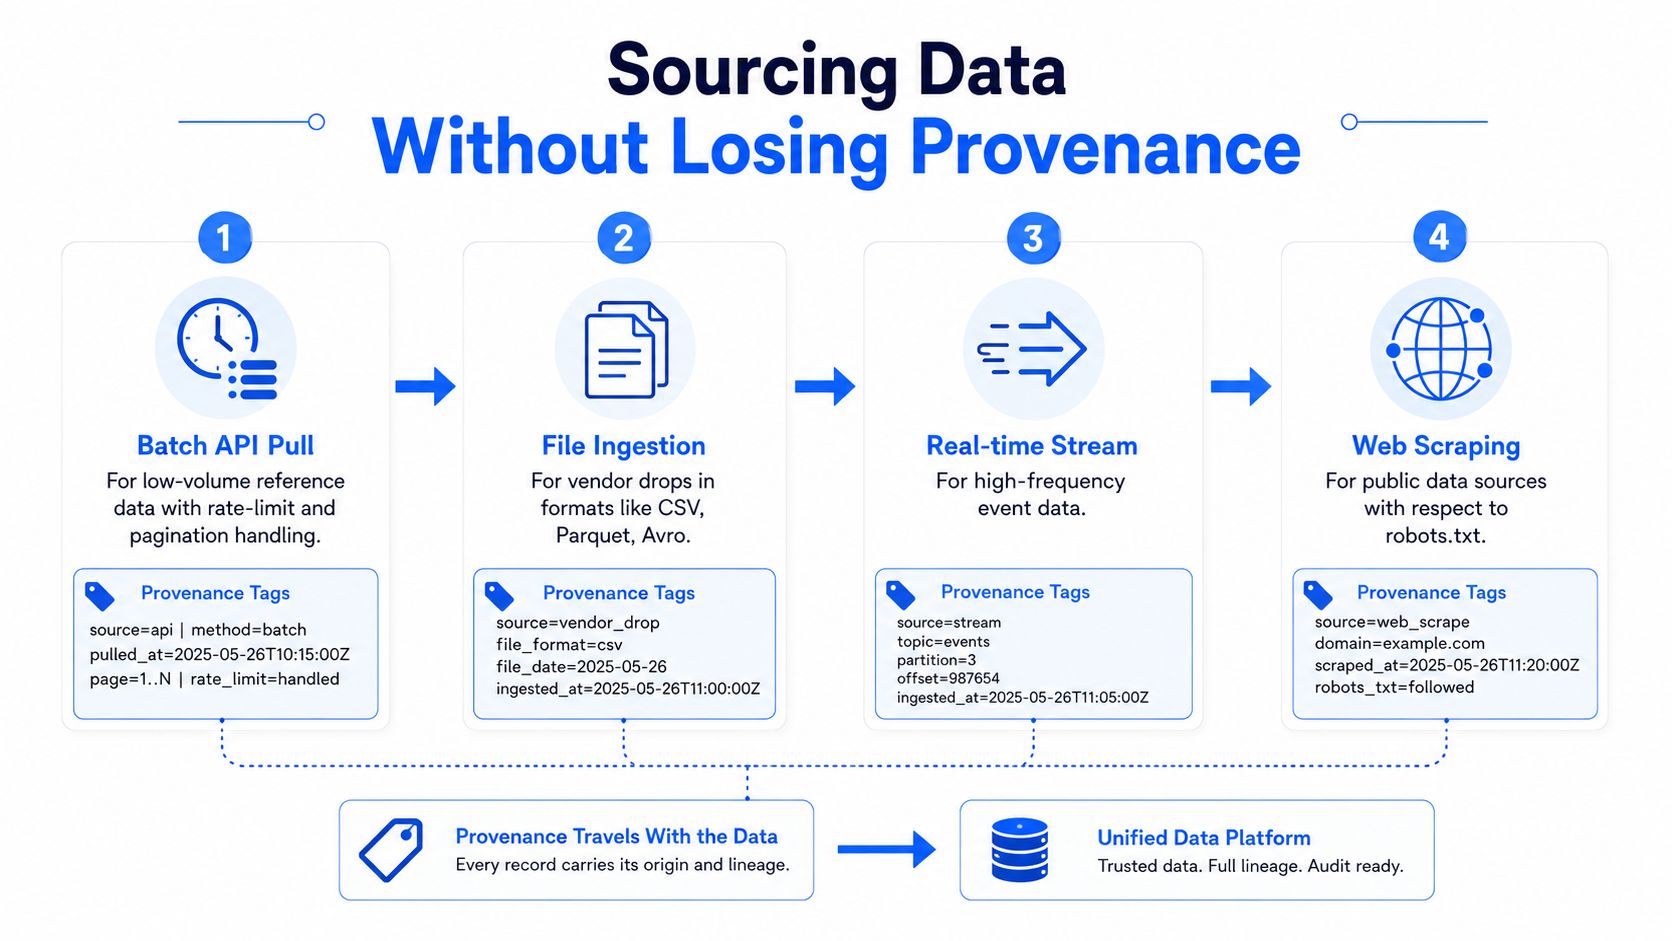
La source importe autant que la structure. Une extraction d'API par lot, un dépôt de fichier, le CDC et les données synthétiques résolvent chacun un problème différent, et ils échouent de manières différentes. Si vous choisissez le mauvais modèle de source, vous passerez des mois à compenser l'absence de lignage au lieu d'améliorer le jeu de données.
Associer la méthode d'acquisition au cas d'usage
Utilisez des extractions d'API par lot pour les données de référence à faible volume, où la pagination et les limites de débit sont les principales contraintes. Utilisez l'ingestion de fichiers pour les dépôts de fournisseurs au format CSV, Parquet ou Avro lorsque les contrats de schéma importent le plus, car les fichiers facilitent le raisonnement sur le versionnage et le rejeu. Utilisez la capture de données modifiées (CDC) lorsque vous avez besoin de chargements d'entrepôt en quasi-temps réel à partir de bases de données opérationnelles, et utilisez des données synthétiques lorsque vous devez tester des pipelines avant que les flux de production n'existent.
L'élément essentiel est la provenance. Capturez source_system, source_loaded_at, source_record_hash, et ingestion_run_id au moment de la lecture, et non plus tard dans la couche de transformation. Le lignage ajouté en aval est toujours une reconstruction, et la reconstruction est le moment où les équipes commencent à inventer des certitudes qu'elles n'ont jamais eues.
Enregistrez la provenance au point de lecture. Tout le reste se transforme en conjecture sous la pression.
Pour les sources web publiques ou les flux de scraping, la même règle s'applique, et la méthode d'acquisition ne doit être choisie qu'après avoir vérifié les contraintes en amont et les modes de défaillance. Un guide pratique sur ce qu'il faut rechercher dans les API rappelle utilement que la disponibilité, la pagination et le comportement contractuel façonnent le jeu de données autant que les lignes elles-mêmes. Si vous souhaitez comprendre la distinction conceptuelle entre lignage et provenance, l'explication interne sur la provenance des données par rapport au lignage des données mérite d'être conservée à portée de main.
Versionner le contrat, pas seulement les données
Les API externes et les flux de fournisseurs doivent être traités comme des dépendances. Figez la version du contrat, documentez les champs obligatoires et faites en sorte qu'un changement de schéma apparaisse sous la forme d'une pull request visible plutôt que d'une rupture silencieuse. De cette façon, lorsqu'un fournisseur modifie le nom ou le type d'un champ, l'équipe voit la différence avant que le pipeline ne l'absorbe.
Des contrôles de validation qui détectent les vrais problèmes
Un jeu de données peut sembler complet et tout de même échouer dès que quelqu'un l'utilise. Les contrôles de valeurs nulles ne détectent qu'une seule catégorie de problème. Les références rompues, les valeurs hors limites, les lignes arrivant en retard et les clés incohérentes peuvent tous laisser une table techniquement remplie mais opérationnellement inutile.
Valider d'abord au niveau de l'enregistrement
Commencez par les contrôles qui protègent les hypothèses en aval. Utilisez l'unicité sur les identifiants naturels là où des doublons compteraient deux fois les enregistrements, l'intégrité référentielle entre les clés de dimension et de fait, des listes de valeurs approuvées pour les champs catégoriels, et des règles de précision pour les colonnes monétaires. Si un champ de revenus doit toujours comporter deux décimales, écrivez cela dans la règle au lieu de faire confiance à chaque système source pour s'y conformer.
Des ensembles de valeurs autorisées réutilisables aident ici, en particulier pour les pays, les départements/états et les codes de statut. Si vous construisez une bibliothèque de règles, l'approche du module de Data Validation dans digna suit ce modèle, avec des contrôles limités à la table ou à un sous-ensemble filtré selon les besoins. L'important n'est pas l'outil. C'est de rendre les règles communes explicites au lieu de les enfouir dans des notebooks ponctuels.
L'élément que vous ne pouvez pas ignorer est la provenance. Capturez source_system, source_loaded_at, source_record_hash et ingestion_run_id au moment de la lecture, et non plus tard dans la couche de transformation. Si ces champs sont ajoutés après l'ingestion, ils cessent d'être des faits et deviennent des conjectures sous la pression.
Ajouter des contrôles de distribution et de Timeliness
Une fois les règles au niveau de la ligne stabilisées, observez la table dans son ensemble. Des nombres de lignes qui s'écartent trop de la référence récente, des taux de valeurs nulles qui grimpent dans des champs critiques et une dérive de la cardinalité catégorielle indiquent tous des problèmes qu'une règle à l'échelle d'une seule ligne manquera. Pour la Timeliness, définissez un objectif de niveau de service clair lié à l'objectif de la table, comme une courte fenêtre de latence pour les flux en quasi-temps réel et une plus longue pour les lots.
La partie difficile est le réglage. Les références d'anomalies ont besoin d'une période de rodage avant de signifier quoi que ce soit, car un tout nouveau jeu de données n'a pas encore de forme stable. Séparez les échecs critiques des simples avertissements, orientez les avertissements vers le traitement des incidents, et assurez-vous que chaque contrôle a un propriétaire, une procédure et un chemin de contournement. Les contrôles sans propriétaire finissent par devenir du bruit de fond, et les alertes trop bruyantes ne sont plus lues.
Traitez les seuils d'acceptation comme une décision de governance, pas comme un détail technique. Si un flux peut tolérer une petite quantité de données facultatives manquantes mais ne peut pas tolérer des clés rompues, indiquez-le clairement dans les contrôles et dans le processus de validation. Cela évite à l'équipe de débattre de chaque alerte comme si tous les échecs avaient le même poids.
Couche de validation | Exemple de contrôle | Seuil suggéré | Propriétaire + Escalade |
|---|---|---|---|
Intégrité de l'enregistrement | Unicité de la clé naturelle | Aucun doublon autorisé | Data engineering, alerte immédiate en cas de violation |
Intégrité des relations | Les clés de fait correspondent aux clés de dimension | Aucune ligne orpheline | Propriétaire du pipeline, quarantaine pour le lot défectueux |
Domaine de valeurs | Pays, statut ou liste d'enums | Uniquement les valeurs approuvées | Propriétaire du domaine, file de traitement |
Précision numérique | Échelle monétaire | Précision décimale requise | Analytics engineer, blocage de la publication |
Tendance de volume | Dérive du nombre de lignes | Dans les limites de la référence normale | Data engineer d'astreinte, investigation |
Stabilité des valeurs nulles | Taux de nullité des colonnes critiques | Faible et stable pour la table | Propriétaire du jeu de données, premier avertissement simple |
Timeliness | Délai entre l'événement et le chargement | Correspondance avec le SLA du flux | Propriétaire de la plateforme, alerte en cas de retard |
Pour une vue plus précise de la manière dont les contrôles s'articulent tout au long du cycle de vie d'un jeu de données, voir règles de validation des données, contrôles et qualité continue des données.
Partitionnement, versionnage et dérive de schéma
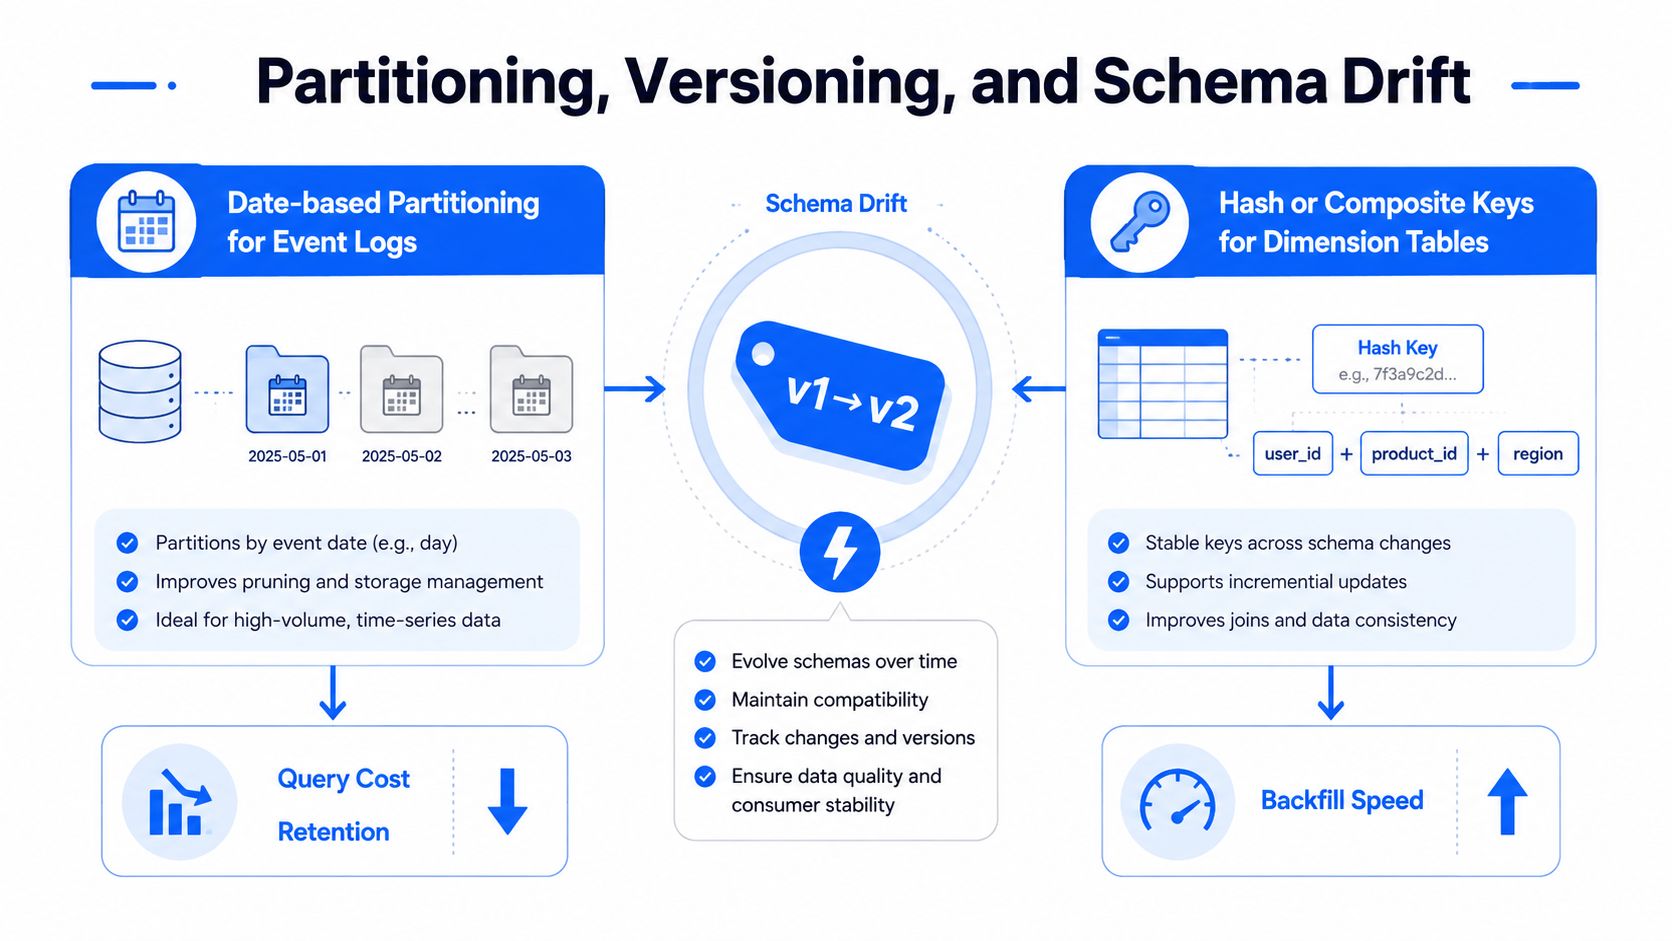
Le partitionnement détermine bien plus que l'organisation du stockage. Il influe sur le coût des requêtes, la vitesse de rattrapage (backfill) et la facilité d'application des règles de conservation. Les équipes choisissent souvent un schéma de partitionnement pour accélérer un tableau de bord spécifique, puis découvrent plus tard qu'il complique le retraitement ou masque des données historiques dont elles ont encore besoin.
Choisir l'organisation en fonction de l'utilisation de la table
Utilisez le partitionnement basé sur la date pour les journaux d'événements et les tables de faits à fort volume d'ajouts. Cela vous donne une unité propre pour la conservation, les rattrapages incrémentiels et les requêtes limitées dans le temps. Pour les instantanés de dimensions ou les structures à changement lent, les clés de hachage ou composites peuvent rendre les recherches et les reconstructions plus prévisibles, en particulier lorsque la table n'est pas naturellement organisée par le temps. Dans des systèmes comme BigQuery, Snowflake et Apache Iceberg, la syntaxe exacte diffère, mais le principe opérationnel reste le même.
Traitez le jeu de données comme étant versionné dès le premier jour. Des versions sémantiques dans les métadonnées, des balises immuables par Release et une fenêtre d'obsolescence pour les anciens consommateurs évitent à l'équipe de prétendre que chaque Release est interchangeable. Lorsqu'une version change, l'ancienne doit rester disponible jusqu'à ce que les consommateurs aient migré, car le pire moment pour supprimer une table est lorsqu'un rapport y est encore rattaché.
Make drift a pipeline failure, not a surprise
La dérive de schéma est le tueur silencieux. De nouvelles colonnes apparaissent, des colonnes requises disparaissent, et les types de données se restreignent juste assez pour casser une jointure ou un transtypage en aval. Le modèle le plus propre est une ingestion permissive dans la zone de réception, suivie d'un profilage, d'une validation stricte à la frontière suivante, et de tests de staging qui font échouer le pipeline si le schéma a changé de manière incompatible.
Cette logique doit résider dans le code, pas dans un commentaire de révision de notebook. Si une couche de transformation peut détecter la différence de schéma, elle peut stopper le déploiement avant que les consommateurs ne soient surpris. Une documentation versionnée et un journal des modifications complètent la boucle en expliquant au prochain analyste pourquoi la table actuelle a cette structure.
Un guide pratique de contrôle de version pour les équipes de Compliance de DPP Grid est utile ici car il présente le versionnage comme un problème de governance, et pas seulement comme une habitude de stockage. Si vous êtes déjà confronté à la dérive de schéma en production, l'explication interne sur la dérive de schéma et les changements structurels qui brisent les pipelines de données aide à concrétiser les modes de défaillance.
Gouvernance et découvrabilité dès le premier jour
La governance est généralement traitée comme une étape d'examen à la fin, mais c'est en réalité un problème de découvrabilité associé à la Compliance. Si les gens ne peuvent pas savoir à quoi sert un jeu de données, qui en est le propriétaire et quelles données il contient, ils vont soit l'utiliser de manière incorrecte, soit l'éviter. Les deux issues sont coûteuses.
Rédiger le minimum de métadonnées avant la publication
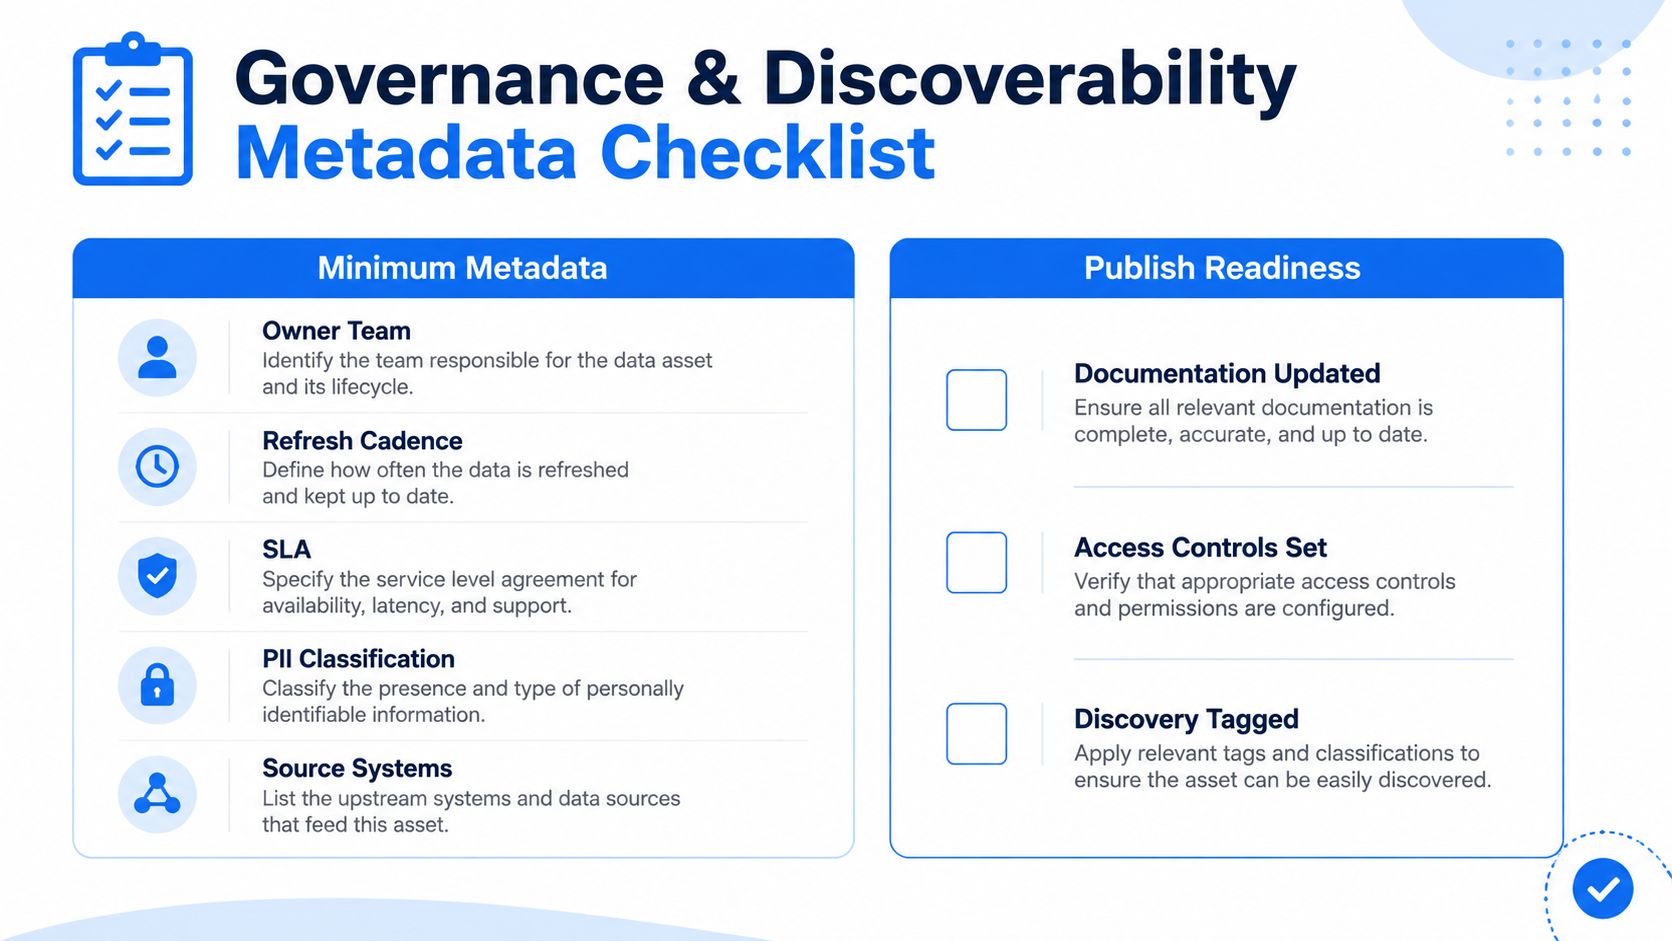
Chaque jeu de données doit être livré avec une équipe propriétaire, une fréquence de rafraîchissement, un SLA, une classification PII, des systèmes sources et une courte déclaration d'utilisation prévue indiquant également ce à quoi le jeu de données n'est pas destiné. Ces six champs semblent basiques parce qu'ils le sont, et c'est précisément cette simplicité qui maintient la table utilisable lors des audits, des transferts et de l'arrivée de nouveaux consommateurs.
Associez les contrôles d'accès à la classification. Masquez les données PII restreintes, appliquez des politiques au niveau de la ligne là où les règles régionales s'imposent, et séparez les rôles de production de ceux du bac à sable (sandbox) afin que l'accès exploratoire ne fuie pas vers l'utilisation opérationnelle. Si le jeu de données comprend des données personnelles, préservez le lignage du consentement en le reliant à la base légale et au calendrier de conservation qui le régit.
Le catalogue est l'endroit où tout cela devient visible. L'aperçu interne de qu'est-ce qu'un catalogue de données rappelle utilement que la découverte ne fonctionne que lorsque les métadonnées et la politique d'accès sont alignées.
Rendre la réutilisation safe, not accidental
Un jeu de données facile à trouver mais difficile à croire crée plus de travail, pas moins. L'objectif est de faire en sorte que l'étape de publication ne soit considérée comme complète que lorsque le jeu de données est balisé, documenté et associé au moteur de politique qui contrôle l'accès. De cette façon, la classification ne dérive pas des autorisations au fil du temps.
Si l'entrée du catalogue est vague, le jeu de données sera mal réutilisé.
C'est pourquoi la checklist pratique est courte : propriétaire, classification, SLA, utilisation prévue, rafraîchissement et contact. Remplissez-les dès la création, et vous éviterez des semaines d'allers-retours lors des audits ultérieurs.
Comment savoir quand votre jeu de données est assez bon
« Assez bon » n'est pas un sentiment, c'est un contrat. L'erreur consiste à attendre une couverture parfaite avant d'autoriser le jeu de données en production, car ce réflexe se traduit généralement par un retard indéfini. Il est préférable de définir le critère de passage, puis de laisser les données faire leurs preuves pour le franchir.
Utiliser des critères d'acceptation liés à la décision
Un premier critère utile est la complétude. Si un champ obligatoire présente un taux de nullité élevé, le jeu de données n'est pas adapté à la décision qu'il est censé éclairer. Un deuxième critère est la fraîcheur, car des données obsolètes peuvent être propres tout en étant erronées pour un usage opérationnel. Un troisième critère est la représentativité, qui vérifie si des segments clés sont suffisamment biaisés pour fausser un modèle ou un rapport en aval.
Les contrôles de biais relèvent de ce troisième critère. Recherchez les déséquilibres de classes, les lacunes géographiques, les écarts démographiques et le biais de survie dans les sources jointes, puis décidez de la mesure à prendre face au résultat. Certains jeux de données doivent être acceptés en l'état, certains doivent être suréchantillonnés ou complétés, d'autres doivent exclure certains usages, et certains doivent être documentés comme étant partiels par conception.
Critère d'acceptation | Métrique | Exemple de seuil | Décision en cas d'échec |
|---|---|---|---|
Complétude | Taux de nullité sur les champs requis | Suffisamment bas pour le cas d'usage | Bloquer la publication ou le rattrapage |
Fraîcheur | Actualité par rapport à la latence de décision | Dans la fenêtre autorisée | Retenir jusqu'à la mise à jour |
Représentativité | Couverture des segments à travers les groupes clés | Pas de déséquilibre critique | Suréchantillonner, exclure ou documenter |
Stabilité | Résultats de qualité répétés dans le temps | Réussite sur plusieurs cycles | Maintenir en mode fantôme (shadow mode) |
Promouvoir par étapes, pas en un seul bond
Le déploiement le plus propre est progressif. Intégrez d'abord les métriques de qualité, comparez ensuite avec un jeu de données de contrôle, et ne faites du nouveau jeu de données l'option par défaut qu'après sa validation sur plusieurs cycles répétés. Cela oblige l'équipe à être honnête sur le fait que les données sont prêtes ou simplement fraîchement construites.
Assez bon signifie que le jeu de données soutient la décision sans imposer de compensations cachées ailleurs.
La discussion autour de la création de jeux de données concerne réellement le contrôle, et non la collecte. Si vous recherchez une plateforme qui surveille la validation, la Timeliness, les modifications de schéma et les comportements anormaux au sein de votre environnement, digna réalise cela sur les données d'entrepôt et de pipeline sans déplacer vos données. Visitez digna pour découvrir comment cela s'intègre dans le cycle de vie d'un jeu de données qui requiert une attribution de propriété, des seuils et des contrôles continus, plutôt qu'une simple construction ponctuelle supplémentaire.
Questions fréquentes
Quand un jeu de données est-il réellement terminé ?
Pas au moment où il se construit correctement. Si un tableau de bord, un modèle ou un workflow en aval peut échouer en silence, le jeu de données n'est pas terminé. Un jeu de données en production a besoin de contrôle après la mise en service, pas seulement de construction avant.
Que faut-il décider avant d'écrire la première requête ?
Le grain, les clés et la sémantique temporelle, car les erreurs de schéma durcissent vite et coûtent cher. Choisissez le grain explicitement plutôt que de le laisser émerger, et retenez des noms qui survivent à l'exploitation réelle, car une table d'événements négligée montre d'abord ses problèmes dans ses noms de colonnes.
Pourquoi les jeux de données cassent-ils des semaines après la mise en service ?
Parce que la cause première relève du contrôle et non de la construction. Le build a passé tous les tests et paraissait propre en préproduction, et rien de spectaculaire ne s'est produit ensuite ; il manquait simplement un moyen de remarquer que la donnée ne se comportait plus comme le schéma le laissait entendre.
Quels contrôles accompagner dès le premier jour ?
La validation, la discipline de partitionnement et le contexte de gouvernance, plus une surveillance des modes de défaillance silencieux. Les ajouter après un incident coûte toujours plus cher que de les concevoir d'emblée, car à ce moment-là des consommateurs décident déjà sur cette base.
Quelle part des données d'entreprise respecte vraiment des standards de qualité ?
Une faible part seulement, selon des travaux sectoriels largement cités, aux côtés des estimations de Gartner sur le coût de la mauvaise qualité. La lecture utile n'est pas que la plupart des données sont inutilisables, mais que la plupart n'ont jamais été mesurées face à un standard énoncé.


