Audit de qualité des données : le mener correctement
|
9
minute de lecture

On ne vous demande généralement pas un audit de données quand tout est calme.
Cela commence quand un tableau de bord cesse de concorder avec la finance, qu'un régulateur demande comment un chiffre a été produit, ou qu'un modèle se met à réagir bizarrement après un changement de système source que personne n'a documenté. À ce moment-là, les équipes découvrent qu'elles faisaient des contrôles ponctuels, pas un audit de qualité des données. Elles peuvent dire qu'une table « avait l'air correcte la semaine dernière », mais pas montrer quels critères ont servi, quelles preuves ont été recueillies, qui a revu le résultat, ni si le même contrôle produirait la même conclusion le mois prochain.
Cet écart compte plus qu'on ne le croit. Une requête ponctuelle peut repérer un défaut. Un audit doit tenir quand quelqu'un réclame des preuves.
Table des matières
Pourquoi l'audit de qualité des données compte avant même de vérifier un enregistrement
Ce dont les équipes ont réellement besoin dans un audit
Ce que produit un audit complet
Cadrer l'audit et inventorier ce qu'il faut vraiment vérifier
Partez de l'adéquation à l'usage
Construisez l'inventaire à rebours depuis le résultat
Posez les limites avant que quiconque ne teste quoi que ce soit
Documentez le lignage tant que le système est encore frais dans les mémoires
Choisir les bons contrôles et décider comment les tester
Partez des dimensions, puis transformez-les en contrôles
L'échantillonnage, les scans complets et la surveillance continue ont chacun leur place
Testez les contrôles à blanc avant d'en faire des preuves
Mener l'audit et recueillir des preuves qui tiennent
Exécutez au plus près des données
Traitez lignage et traçabilité comme des preuves, pas comme de la décoration
Consignez aussi les presque-incidents et les changements de source
Transformer les constats en corrections, avec propriété et suivi clairs
Le rapport doit faire plus que résumer des défauts
Attribuez la responsabilité par point de contrôle, pas par faute
Suivez jusqu'à la clôture par vérification, pas par simple statut
Rendre les audits reproductibles et prêts pour la surveillance continue
Gardez le cycle d'audit court et riche en preuves
Surveillez les modes de défaillance que les audits révèlent sans cesse
Passez à l'échelle en normalisant le modèle de contrôle
Pourquoi l'audit de qualité des données compte avant même de vérifier un enregistrement
Le moment de tension est familier. Une partie prenante veut savoir si un rapport est fiable, et l'instinct est de foncer sur les comptages de lignes, les contrôles de valeurs nulles et les doublons. C'est utile, mais ce n'est pas encore un audit. Sans critères définis d'abord, il ne reste qu'une activité technique sans conclusion défendable.
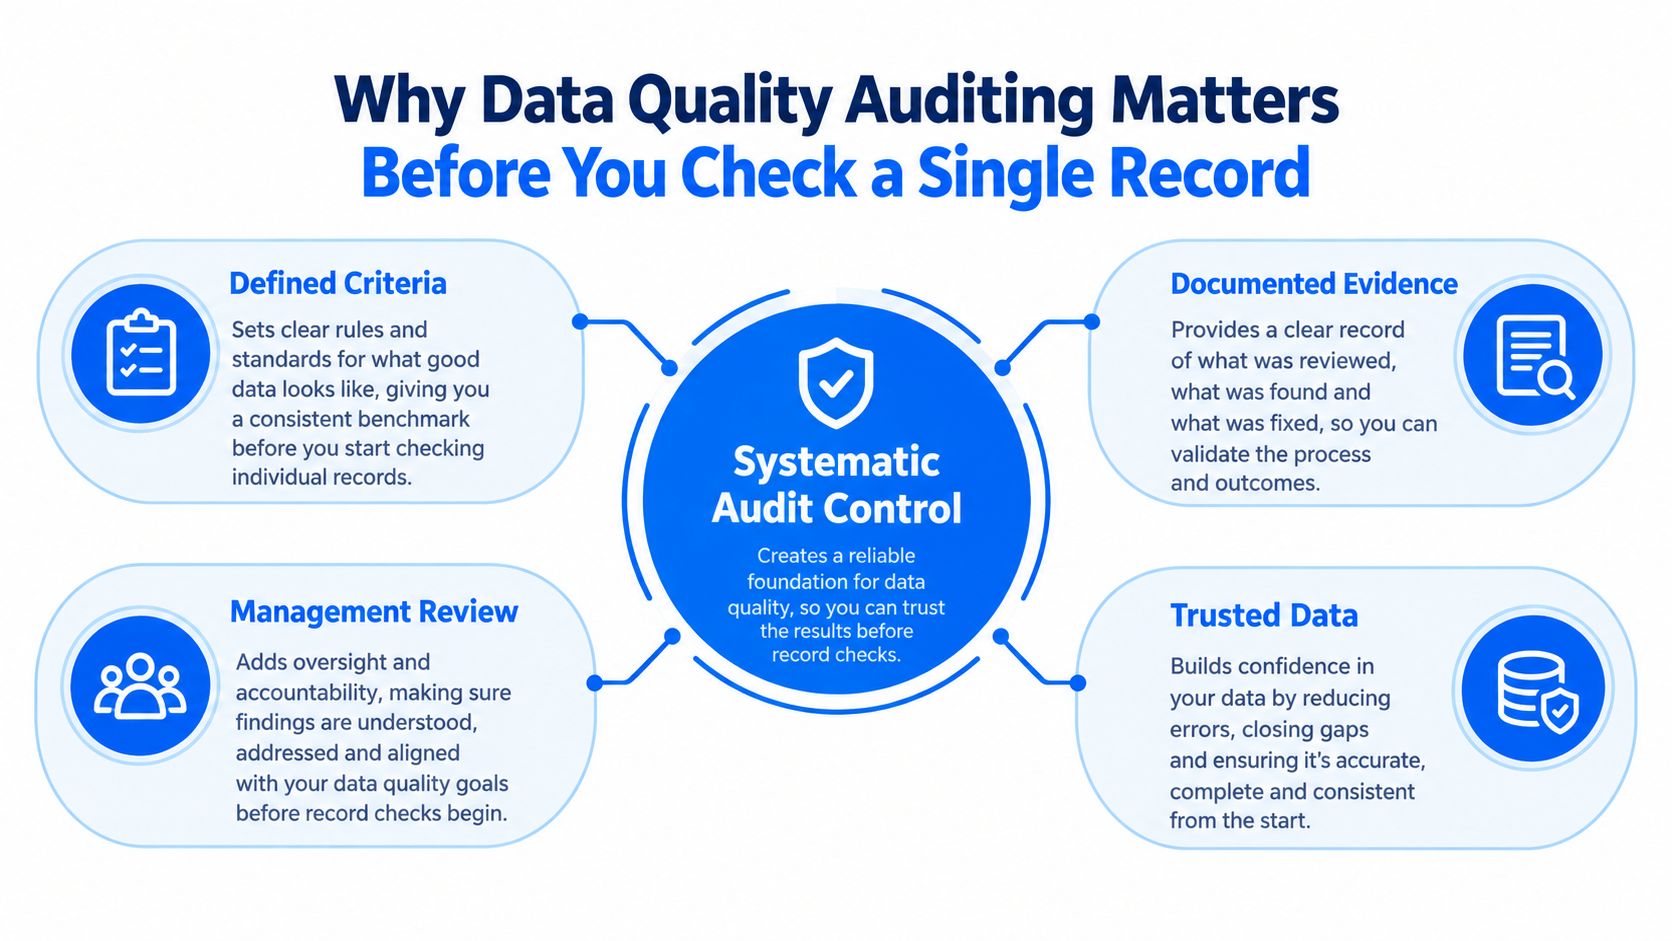
Un standard durable existe pour cela. L'ISO définit un audit comme un « processus systématique, indépendant et documenté » visant à obtenir des preuves et à les évaluer au regard de critères, base d'audits de qualité des données reproductibles dans les secteurs et les administrations, comme le résume le manuel de l'ONU et d'Eurostat sur les méthodes et outils d'évaluation de la qualité des données. Cette définition est plus pratique qu'il n'y paraît. Elle dit ce qu'un véritable audit doit prouver :
Systématique signifie que les contrôles ne sont pas improvisés.
Indépendant signifie que les constats résistent à un examen hors de l'équipe qui livre.
Documenté signifie qu'une autre personne pourra inspecter les preuves plus tard et aboutir à la même conclusion.
Ce dont les équipes ont réellement besoin dans un audit
En pratique, le premier gain est un langage commun. Les programmes d'audit du secteur public structurent souvent les constats autour de l'exactitude, la complétude, la cohérence, la Timeliness, la validité et l'unicité. Ces dimensions n'ont rien d'académique. Elles mettent fin à la dispute habituelle où l'ingénierie dit « le pipeline a réussi », la finance « le rapport est faux » et la conformité « les données sont arrivées en retard ».
Une équipe qui audite par dimension peut séparer des modes de défaillance distincts :
L'exactitude demande si la valeur reflète la chose.
La complétude demande s'il manque des enregistrements ou des champs attendus.
La Timeliness demande si les données sont arrivées à temps pour la décision.
La cohérence demande si le même fait concorde d'un système à l'autre.
La validité demande si les valeurs respectent règle et format.
L'unicité demande si une entité apparaît une seule fois quand elle le doit.
Si votre organisation traite encore cela comme des étiquettes abstraites, il est utile de les relier à la raison pour laquelle la qualité des données importe à une organisation. Toute question de confiance posée par la direction finit par atterrir sur l'une de ces dimensions.
Ce que produit un audit complet
Un audit complet ne s'arrête pas à « nous avons trouvé de mauvaises lignes ». Le même manuel de l'ONU et d'Eurostat souligne que les conclusions doivent être résumées dans un rapport, revues par la direction et converties en plan d'action. C'est cette boucle de contrôle que beaucoup d'équipes sautent.
Règle pratique : si le produit du travail n'est qu'un tableur d'anomalies, vous avez mené une inspection. Si le produit est preuves, conclusions, revue et action corrective, vous avez mené un audit.
C'est pourquoi l'audit de qualité des données compte avant même que quiconque ne vérifie un enregistrement. Le cadre d'audit détermine ce qui fait preuve, ce que signifie un échec, qui valide et ce qui suit. Sans cela, même de bons contrôles techniques ne produiront pas de résultats fiables.
Cadrer l'audit et inventorier ce qu'il faut vraiment vérifier
Un audit faible échoue généralement avant le premier test. Le périmètre est flou, les responsables imprécis, et la moitié des données du rapport ne figure même pas à l'inventaire. Les équipes perdent alors du temps à valider des colonnes sans importance tout en manquant la transformation même qui porte la décision qui préoccupe tout le monde.
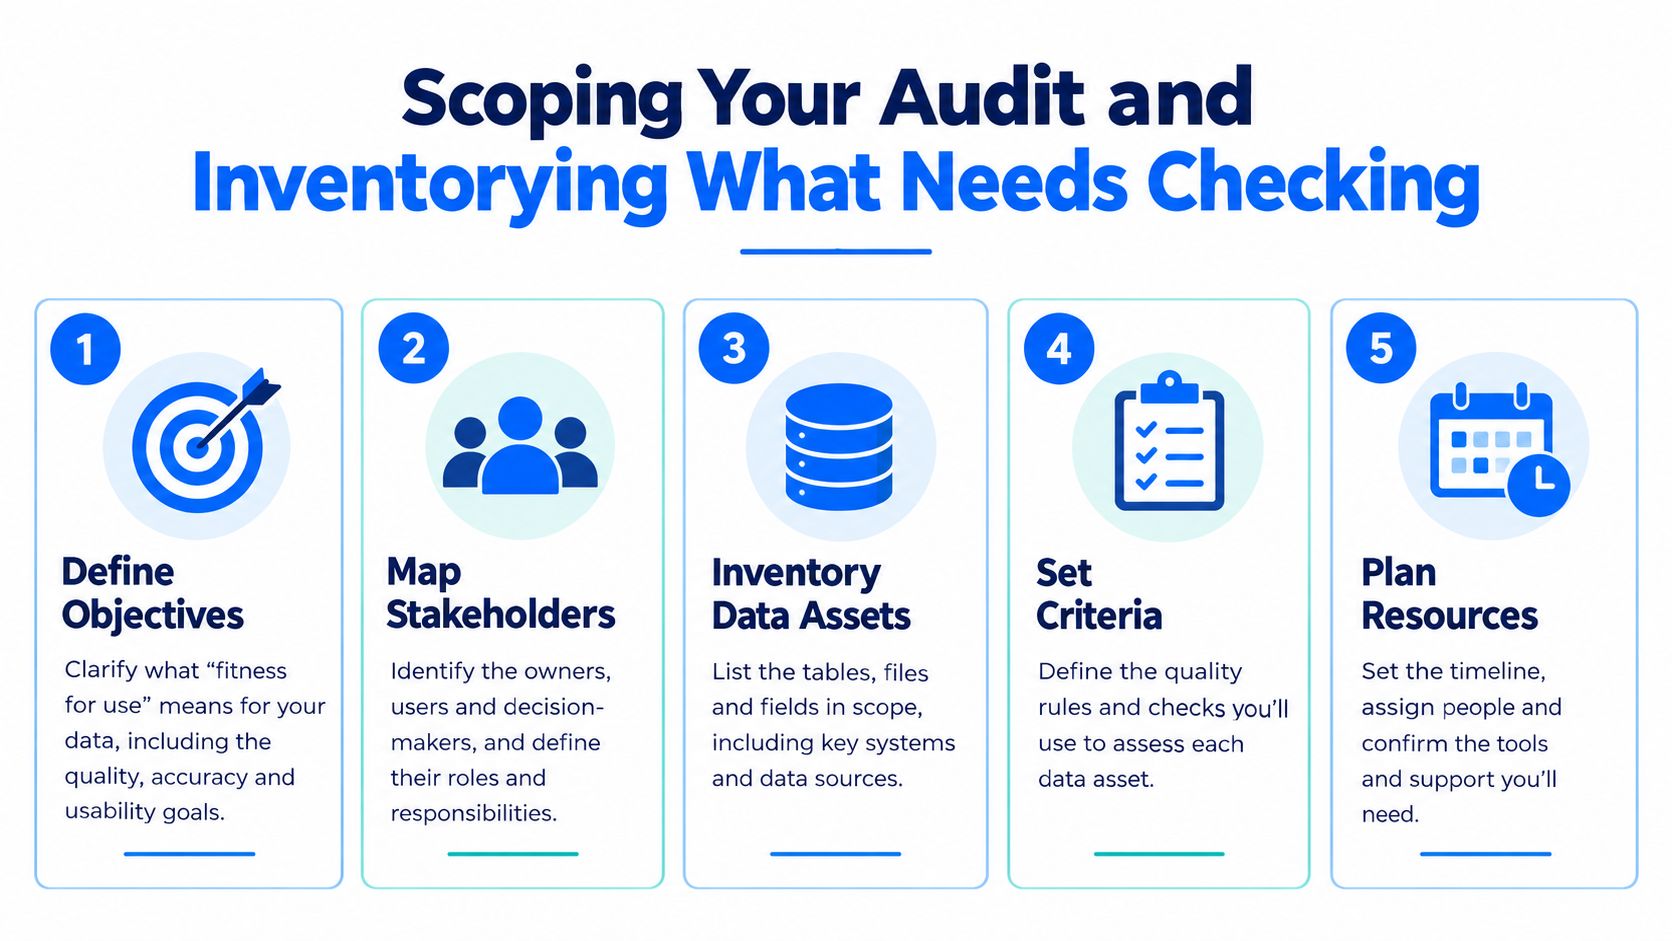
La première discipline est simple. Cadrez l'audit autour de l'usage prévu, pas autour des tables les plus faciles d'accès.
Partez de l'adéquation à l'usage
Les travaux du NIST sur la qualité des données insistent sur son caractère contextuel : elle doit s'évaluer au regard de l'usage prévu, non d'un score universel abstrait, la qualité étant définie comme adéquation à l'usage et rattachée aux exigences métier dans cette discussion d'inspiration NIST sur le contexte et l'évaluation de la qualité des données. Autrement dit, un jeu de données peut réussir un audit et en échouer un autre si le contexte décisionnel change.
Une déclaration réglementaire, par exemple, exige des critères de complétude et de traçabilité différents d'un tableau de bord interne de performance. Un jeu d'entraînement peut tolérer un peu de retard, mais pas des classes mal étiquetées. Un flux d'opérations clients peut exiger une fraîcheur stricte même si certains champs d'enrichissement sont facultatifs.
Avant de lister les actifs, notez trois choses :
La décision ou l'obligation métier que les données soutiennent.
Le résultat précis auquel on se fie ou qui est contesté.
La conséquence d'une défaillance si les données sont en retard, fausses, incomplètes ou structurellement modifiées.
Construisez l'inventaire à rebours depuis le résultat
Ne partez pas du catalogue de l'entrepôt en espérant que la pertinence apparaisse. Partez du rapport, du tableau de bord, du jeu de variables d'un modèle ou de l'artefact déclaratif, puis remontez vers les tables sources, les jointures, les transformations, les données de référence et les traitements de livraison.
Un inventaire exploitable contient plus que des noms de tables :
Les résultats critiques : rapports, modèles, alertes ou déclarations externes.
Les actifs en amont, y compris tables sources, couches de staging, logique de transformation et tables de référence métier.
Les dépendances opérationnelles : calendriers, engagements de livraison et consommateurs en aval.
Des responsables nommés pour les données sources, la logique de transformation et l'acceptation métier.
Pour formaliser tout cela, une liste définie d'éléments de données critiques est souvent le moyen le plus rapide d'arrêter la dérive de périmètre. Tous les jeux de données ne méritent pas la même profondeur d'audit. Ceux qui portent la déclaration réglementée, les décisions clients, les écritures financières ou l'IA en production, si.
Posez les limites avant que quiconque ne teste quoi que ce soit
L'essentiel des frictions d'audit vient d'erreurs de limites. Une équipe déclare que le « pipeline de chiffre d'affaires client » est dans le périmètre, mais personne ne précise si cela inclut les extractions du système source, la logique d'enrichissement, les dimensions à évolution lente, les corrections manuelles ou la gestion des exceptions.
Utilisez des limites explicites comme celles-ci :
Domaine de périmètre | Ce qu'il faut définir |
|---|---|
Limite métier | Quelle décision, quel rapport, quelle déclaration ou quel modèle est couvert |
Limite de données | Quels jeux de données, champs et périodes sont inclus |
Limite de processus | Quelles transformations, quels calendriers et quelles passations sont inclus |
Limite de responsabilité | Qui approuve les règles, qui corrige, qui valide |
Le périmètre d'audit doit être assez étroit pour être exécuté et assez large pour expliquer le chiffre final.
Documentez le lignage tant que le système est encore frais dans les mémoires
La documentation du lignage est reportée parce que les équipes supposent pouvoir la reconstituer plus tard. En général, elles ne le peuvent pas. La personne qui sait pourquoi une jointure de repli existe s'en va, ou le contournement d'urgence d'il y a six mois devient un comportement normal invisible.
En inventoriant les actifs, consignez :
d'où provient chaque champ critique
quelle transformation le crée ou le modifie
s'il existe un ajustement manuel
quel calendrier ou événement le livre
qui est censé remarquer s'il cesse d'arriver
Ce niveau d'inventaire ne paraît lourd que jusqu'à la première réunion de revue. Il fait alors la différence entre une courte investigation et une semaine de suppositions.
Choisir les bons contrôles et décider comment les tester
Une fois le périmètre réel, l'erreur suivante est de choisir les contrôles par habitude. Les équipes se rabattent souvent sur les taux de valeurs nulles, les comptages de doublons et quelques règles regex parce que c'est facile à scripter. Pour l'hygiène de base, très bien. Pour un audit défendable, insuffisant.
Il vous faut des contrôles qui correspondent à l'objectif de l'audit, et une approche de test adaptée au risque, au volume et au rythme de changement des données.
Partez des dimensions, puis transformez-les en contrôles
Le cadre de qualité des données DAMA, courant en gouvernance d'entreprise, identifie six dimensions essentielles : exactitude, complétude, cohérence, Timeliness, unicité et validité, et le même document définit la Timeliness de manière opérationnelle comme le fait que les données soient assez fraîches pour servir, avec des contrôles d'exemple formulés en seuils mesurables, par exemple un délai depuis la dernière mise à jour inférieur à une limite choisie, disons moins d'une heure depuis l'ingestion, comme le décrit ce panorama des dimensions de la qualité des données et des contrôles opérationnels.
Cela compte parce que des attentes floues deviennent des contrôles testables. « Les données doivent être à jour » n'est pas auditable. « Cette table doit se mettre à jour dans le seuil de fraîcheur convenu pour l'exécution du rapport » l'est.
Voici une façon compacte de choisir.
Objectif d'audit | Contrôles recommandés | Approche de test |
|---|---|---|
Reporting réglementaire ou de direction | Complétude, exactitude, Timeliness, contrôles de rapprochement | Scans complets des champs et enregistrements clés, plus surveillance planifiée de la Timeliness |
Données de référence clients ou entités | Unicité, validité, cohérence inter-systèmes | Détection complète des doublons sur les identifiants centraux, contrôles de règles ciblés sur les attributs critiques |
Tableaux de bord opérationnels à évolution rapide | Timeliness, stabilité du schéma, anomalies de volume d'enregistrements | Surveillance continue avec contrôles de seuil et de dérive |
Variables de modèles ou jeux d'entrée IA | Validité, complétude, cohérence des étiquettes ou attributs | Contrôles continus sur les champs critiques, revue plus poussée périodique sur des échantillons représentatifs |
Systèmes sources nouvellement raccordés | Validité de format, motifs de valeurs nulles, cohérence référentielle | D'abord des tests pilotes, puis une exécution plus large une fois les motifs stabilisés |
L'échantillonnage, les scans complets et la surveillance continue ont chacun leur place
L'échantillonnage fonctionne encore quand les volumes sont importants et le processus stable, mais il cède quand les schémas changent souvent ou quand un défaut rare a un fort impact. Les scans complets sont plus solides pour les règles déterministes sur des données critiques, surtout dans les entrepôts modernes où l'exécution dans la base est praticable. La surveillance continue s'impose quand des chargements tardifs, une dérive structurelle ou des changements d'exploitation peuvent rompre la confiance entre deux cycles formels d'audit.
Les cadres d'audit indépendants confirment aussi que le choix de méthode compte. La littérature récente résumée dans le cadre de la FAO décrit quatre approches de haut niveau et 15 méthodes distinctes, rappel utile qu'auditer avec maturité relève du choix de méthode et non d'une liste figée, comme l'expose le document de la FAO sur les méthodes d'évaluation de la qualité des données.
Quelques arbitrages reviennent sans cesse :
L'échantillonnage est plus léger quand l'inspection manuelle des enregistrements coûte cher, mais il ne saisira pas tous les cas limites.
Les scans complets sont plus solides pour la complétude, la validité, l'unicité et les règles métier déterministes.
Les contrôles continus sont nécessaires quand fraîcheur et changements de schéma peuvent invalider des résultats en aval entre deux revues planifiées.
Testez les contrôles à blanc avant d'en faire des preuves
L'un des échecs les plus courants en audit vient d'une mauvaise conception des tests. Les recommandations d'audit clinique signalent les dossiers incomplets ou inexacts comme écueil récurrent et préconisent des tests pilotes avant la collecte, un nettoyage des données au fil de leur arrivée, l'identification des biais comme les enregistrements systématiquement exclus, et la révision des formulaires ou protocoles quand les erreurs se répètent, comme le résume la même référence de cadre d'audit de la FAO.
C'est aussi un bon conseil d'ingénierie. Testez vos contrôles sur un échantillon plus petit mais représentatif avant de les exécuter à grande échelle. Vous détecterez vite les mauvaises hypothèses :
une règle de validité qui rejette des valeurs anciennes mais acceptées
une règle de doublons qui confond tables d'historique et tables d'état courant
une règle de Timeliness qui ignore des calendriers métier connus
un test de complétude qui prend des champs volontairement peu remplis pour des défauts
Pour des exemples concrets de conception de règles et d'application permanente, ce guide des règles de validation, contrôles et qualité des données en continu est utile car il reste proche de la mise en œuvre plutôt que de la théorie.
Un contrôle n'est pas bon parce qu'il s'exécute. Il est bon parce qu'un relecteur voit pourquoi il existe, ce que signifie son échec et si le seuil correspond à l'usage métier.
Mener l'audit et recueillir des preuves qui tiennent
C'est à l'exécution que beaucoup d'audits deviennent fragiles. Les contrôles tournent, des constats apparaissent, puis personne ne sait répondre aux questions élémentaires de revue : quelle version de la règle a tourné ? Sur quel état du jeu de données ? La source était-elle en retard ? Le schéma a-t-il changé avant l'échec ? S'agissait-il d'un défaut isolé ou de la conséquence d'un changement amont connu ?
Voilà pourquoi la conception des preuves compte autant que celle des tests.
Exécutez au plus près des données
Pour la plupart des environnements d'entrepôt et de lake, le schéma le plus propre consiste à exécuter les contrôles dans la base. Cela réduit les déplacements, préserve les frontières de sécurité et évite le problème annexe de créer encore une copie de données sensibles pour l'audit.
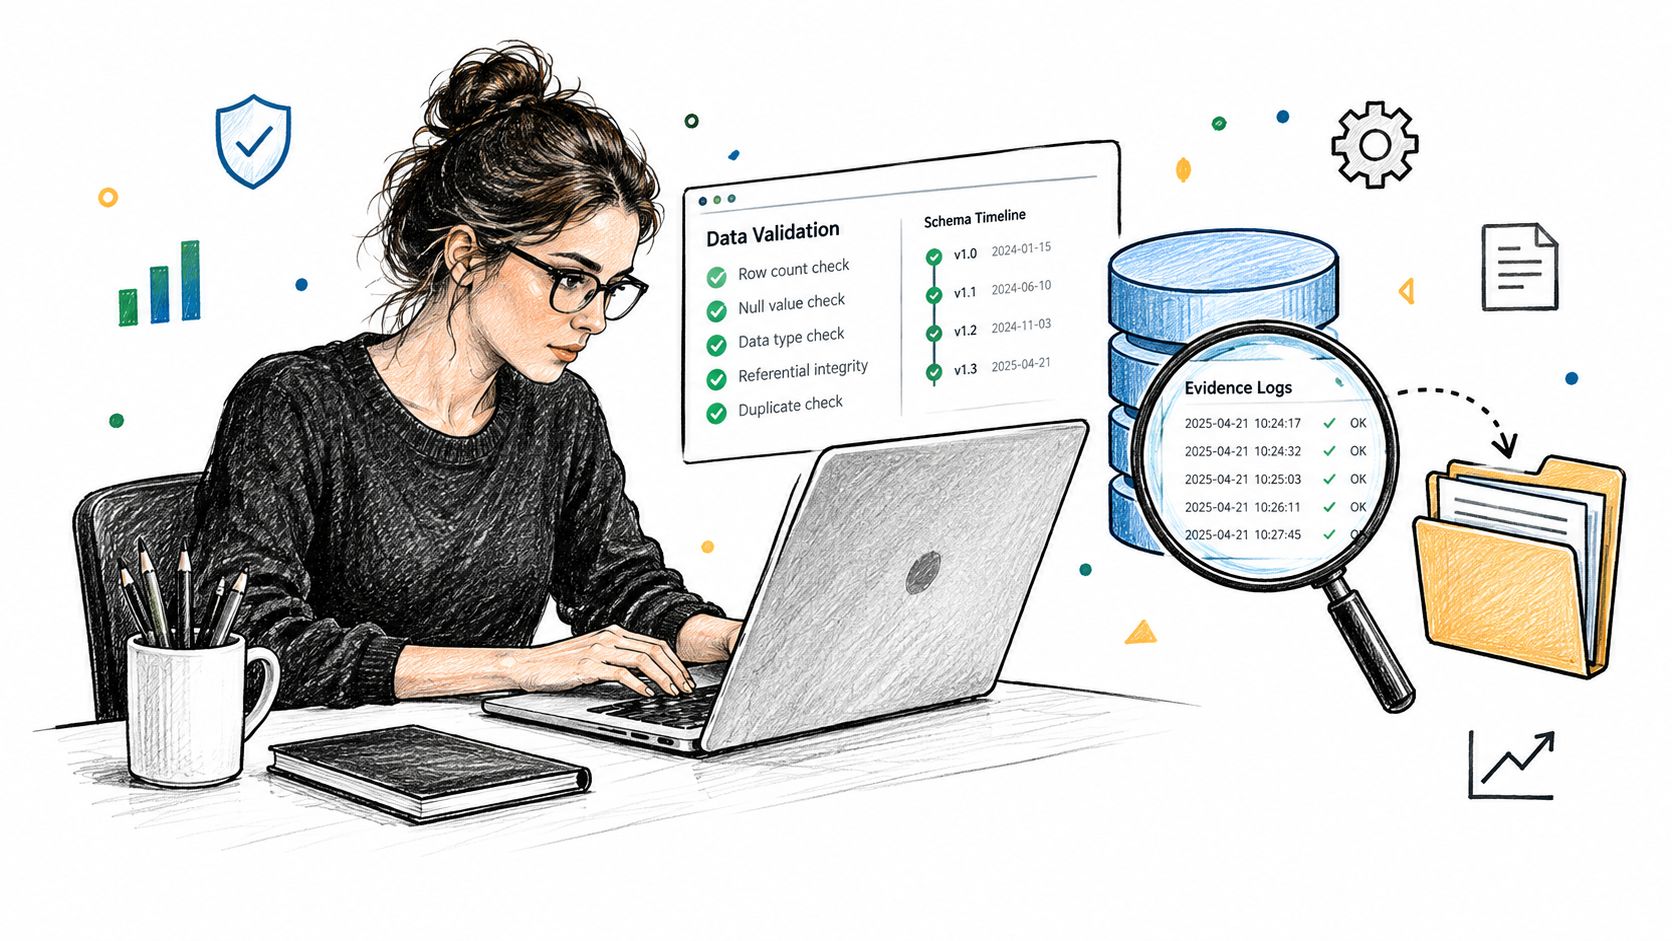
Pendant l'exécution, consignez plus qu'un réussi ou échoué :
Le contexte du jeu de données : environnement, schéma, table, partition ou fenêtre temporelle
Le contexte de la règle : version de la logique, seuil et statut d'approbation
Le contexte d'exécution : heure d'exécution, état de livraison de la source et éventuels avertissements de dépendance
Le contexte du résultat : volumes touchés, exemples et classement de sévérité
Si vous passez par une plateforme, une mention s'impose : digna s'exécute dans l'environnement du client, réalise surveillance et validation dans la base, et présente incidents, tendances, problèmes de Timeliness et changements de schéma dans une interface partagée. Ce modèle de déploiement convient aux audits car les preuves restent près des systèmes examinés au lieu d'être reconstituées à l'extérieur.
Traitez lignage et traçabilité comme des preuves, pas comme de la décoration
La littérature sur la pratique de la qualité des données en entreprise traite la traçabilité et le lignage comme des mécaniques d'audit centrales, et non comme des métadonnées facultatives. Les listes de dimensions issues de DAMA comptent la traçabilité parmi les dimensions de qualité couramment citées, et les sources de gouvernance décrivent le lignage comme essentiel pour comprendre comment les données sont transformées, d'où elles viennent et comment elles circulent, comme en discute ce document sur le choix des bonnes dimensions de qualité des données.
Sans lignage, un contrôle de champ en échec vous dit qu'il y a de la fumée. Il ne vous dit pas où le feu a pris.
Un bon dossier de preuves doit permettre à un relecteur de répondre vite à ces questions :
Question de revue | Preuve nécessaire |
|---|---|
D'où vient ce champ | Table source, champ source, chemin d'ingestion |
Qu'est-ce qui a changé avant l'apparition du problème | Historique de schéma, journal de déploiement, avis du processus source |
Comment le champ a-t-il été transformé | Logique de transformation, référence du traitement ou du modèle |
Qui est responsable de la correction | Responsable de la source, responsable du pipeline, approbateur métier |
Pour les équipes qui cherchent une discipline pratique autour de la qualité des preuves, l'article de Rivul AI sur la manière d'auditer des affirmations non étayées avant soumission mérite la lecture. Il parle d'affirmations plutôt que de pipelines, mais l'habitude de fond est identique : rattacher chaque conclusion à un appui vérifiable avant toute validation.
Consignez aussi les presque-incidents et les changements de source
Beaucoup d'incidents graves commencent en presque-incidents. Une source livre en retard mais arrive quand même avant l'échéance du rapport. Un champ nullable devient soudain peu rempli. Une table de correspondance change de sémantique sans casser le schéma. Si vous ne consignez que les échecs francs, vous manquez le motif qui aurait rendu prévisible la défaillance suivante.
Les meilleurs ensembles de preuves comprennent donc :
les échecs francs
les avertissements et presque-incidents
les avis de changement de processus source
les modifications de schéma
les manquements de fraîcheur
l'état de correction relié au constat d'origine
Pour des schémas de mise en œuvre autour des contrôles par règles et des pistes d'audit, un vérificateur d'intégrité des données dédié aide à ancrer les preuves dans les jeux de données réels et l'historique d'exécution, plutôt que dans des notes d'analystes éparpillées entre tickets et messageries.
Transformer les constats en corrections, avec propriété et suivi clairs
Un audit terminé sans modèle de responsabilité n'est que de la frustration bien rangée. Les équipes font souvent le plus dur : elles identifient de vrais défauts, prouvent l'impact et proposent même des corrections. Puis les constats s'enlisent parce que la responsabilité se répartit entre équipes de systèmes sources, ingénierie des données, analytique et métiers.
Ce déficit de contrôle est courant. 44 % des répondants déclarent que la responsabilité de la qualité des données est partagée entre plusieurs équipes, 61 % s'appuient encore sur des contrôles manuels ou une validation en SQL, et seuls 14 % appliquent des SLA à l'échelle de l'organisation, selon l'analyse de Thomson Reuters sur le déficit de validation dans la confiance accordée aux données d'audit. La responsabilité partagée n'est pas un problème ; la validation non attribuée, si.
Le rapport doit faire plus que résumer des défauts
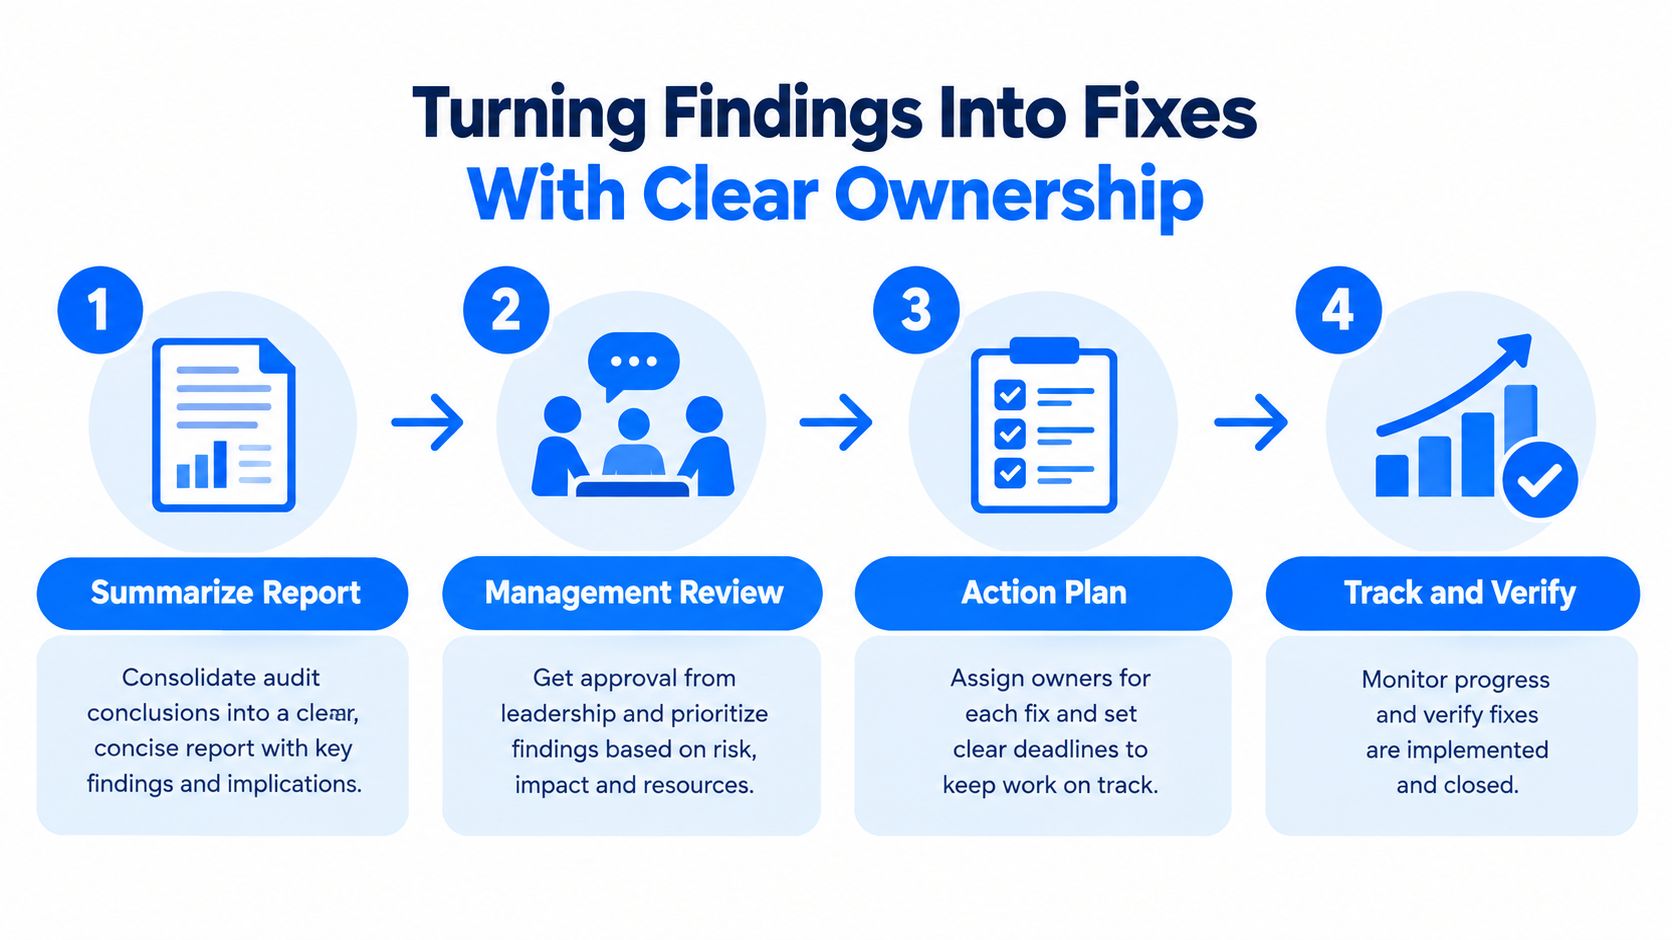
Le manuel d'audit de l'ONU et d'Eurostat fait un point opérationnel important : les conclusions doivent être résumées dans un rapport, revues par la direction et converties en plan d'action. Cette séquence compte, car elle transforme les constats en changement maîtrisé plutôt qu'en nettoyage informel.
Un rapport de constats exploitable doit répondre à :
ce qui a échoué
pourquoi cela importe pour la décision ou l'obligation
s'il s'agit d'une qualité intrinsèque des données ou d'un comportement du système
quelle atténuation temporaire existe
qui porte la correction définitive
comment la clôture sera vérifiée
Attribuez la responsabilité par point de contrôle, pas par faute
Le plus sûr moyen de perdre l'élan est de demander « à qui la faute ? ». Meilleure question : « quel point de contrôle peut empêcher la récidive ? ».
Utilisez le type de défaillance pour attribuer l'action :
Problème de saisie à la source. Le responsable est généralement celui du processus amont ou du formulaire.
Défaut de transformation. La correction revient au responsable du pipeline ou de l'ingénierie analytique.
Écart de définition. La gouvernance métier ou le responsable de l'indicateur doit trancher.
Défaillance de livraison ou de fraîcheur. Le contrôle opérationnel revient au responsable de la plateforme ou du traitement.
Correction manuelle répétée. C'est le contrôle lui-même qu'il faut repenser, pas une note d'exception de plus.
Conseil opérationnel : chaque constat a besoin d'un responsable de la correction et d'un responsable de la validation. Ce peut être deux personnes différentes. Ce ne doit pas être un comité.
Si les mêmes erreurs reviennent dans le même formulaire, la même extraction ou le même protocole, révisez le formulaire ou le processus. Ne vous contentez pas de renettoyer le résultat. C'est l'un des motifs les plus nets, aussi bien en audit clinique qu'opérationnel.
Suivez jusqu'à la clôture par vérification, pas par simple statut
Un ticket marqué « terminé » n'est pas une clôture d'audit. Clôturer signifie que le défaut a été corrigé, que le contrôle a été mis à jour si nécessaire, et que le contrôle passe désormais selon les mêmes critères que ceux qui ont produit le constat initial.
La clarté des rôles paie. Un cadre documenté des rôles et responsabilités en qualité des données aide à distinguer intendants, ingénieurs, responsables de domaine et approbateurs, pour que les constats ne disparaissent pas dans des boîtes partagées.
Le modèle de suivi le plus fiable est simple :
Élément de suivi | Ce qu'il doit montrer |
|---|---|
Identifiant du constat | Référence stable vers la preuve |
Responsable assigné | Personne nommée, comptable de la correction |
Responsable de la validation | Relecteur nommé qui accepte la clôture |
Échéance ou SLA | Délai attendu de correction |
Méthode de vérification | Quel nouveau test ou quelle preuve confirme la clôture |
C'est ainsi que les constats deviennent des corrections plutôt que des légendes.
Rendre les audits reproductibles et prêts pour la surveillance continue
L'épreuve de vérité de l'audit de qualité des données n'est pas de réussir une revue solide sous pression. C'est de savoir si les mêmes contrôles fonctionnent encore six mois plus tard, quand le schéma a bougé, qu'une équipe de système source a changé le comportement d'un champ et que personne n'a pensé à mettre à jour la documentation.
La reproductibilité vient de la transformation de la logique d'audit en rythme d'exploitation.
Gardez le cycle d'audit court et riche en preuves
Un schéma efficace consiste à garder un périmètre d'audit formel resserré et à faire tourner autour, en continu, des contrôles plus légers. La revue approfondie périodique garde son importance, surtout pour les résultats réglementés et les jeux à fort impact. Mais le travail quotidien de fiabilité doit guetter les changements qui rompent la confiance entre deux revues : arrivées tardives, enregistrements manquants, dérive structurelle et presque-incidents répétés.
Beaucoup d'équipes surdimensionnent. Elles conçoivent d'énormes exercices trimestriels qui produisent de beaux supports et peu d'apprentissage opérationnel. Des cycles plus courts et riches en preuves tiennent mieux parce que les équipes peuvent les maintenir.
Surveillez les modes de défaillance que les audits révèlent sans cesse
Les méthodes d'audit traditionnelles souffrent aussi des volumes et des rythmes de changement actuels. Des synthèses récentes notent que l'échantillonnage manuel et les méthodes sur tableur peinent à vérifier de grands volumes de données d'audit, et que l'adoption d'une observabilité dédiée et d'une application des SLA en est encore à ses débuts, comme le décrit ce panorama des lacunes de l'audit de qualité des données et des défis de la surveillance continue. Cela rejoint la pratique : les contrôles ne défaillent pas parce que l'idée était fausse, mais parce que la méthode ne suit pas.
Un rythme de surveillance reproductible comprend en général :
Des contrôles de fraîcheur pour les livraisons critiques et les dépendances en aval
Une surveillance du schéma pour que les changements structurels soient visibles avant que les consommateurs ne cassent
Un historique d'exécution des règles pour montrer si la qualité progresse ou se dégrade
Une revue des exceptions pour que les avertissements et presque-incidents ne soient pas ignorés
Une revalidation planifiée après les changements de processus amont
Les bons audits s'allègent avec le temps parce que les équipes réutilisent critères, motifs de preuve et chemins de responsabilité. Les mauvais s'alourdissent parce que chaque cycle repart de zéro.
Passez à l'échelle en normalisant le modèle de contrôle
Il n'est pas nécessaire que chaque domaine utilise des règles identiques. Il est nécessaire que chacun utilise le même modèle de contrôle : critères explicites, preuves documentées, responsabilité nommée, exceptions gérées et vérification après correction.
C'est cette normalisation qui permet à une organisation d'auditer des flux financiers, des dossiers cliniques, des données d'exploitation télécoms ou des jeux de données publics sans réinventer la méthode à chaque fois. Les contrôles diffèrent. Le système de contrôle, non.
Un programme d'audit reproductible est le moment où le travail sur la qualité cesse d'être un nettoyage réactif et se met à fonctionner comme une infrastructure.
Si ce système de contrôle doit fonctionner dans votre propre environnement, digna offre validation dans la base, surveillance de la Timeliness, suivi de schéma, détection d'anomalies et preuves prêtes pour l'audit sur entrepôts, lakes et pipelines. Elle est conçue pour les équipes qui veulent des audits de qualité des données reproductibles sans sortir les données de production de leur stack. Rendez-vous sur digna pour voir comment la plateforme soutient des contrôles d'audit continus et défendables.
Un audit est un instantané ; faire tourner les mêmes contrôles entre deux audits, c'est le pas vers la surveillance continue de la qualité des données.
Questions fréquentes
Qu'est-ce qui distingue un audit de qualité des données d'une inspection ?
Le produit. Si le résultat n'est qu'un tableur d'anomalies, c'est une inspection ; un audit produit preuves, conclusions, revue par la direction et action corrective. L'ISO présente l'audit comme un processus systématique, indépendant et documenté, évalué au regard de critères.
Qu'exigent respectivement systématique, indépendant et documenté ?
Systématique signifie que les contrôles ne sont pas improvisés. Indépendant, que les constats résistent à un examen hors de l'équipe qui livre. Documenté, qu'une autre personne pourra inspecter les preuves plus tard et aboutir à la même conclusion.
Comment fixer le périmètre d'audit ?
À partir de l'adéquation à l'usage, pas d'un score abstrait. Les travaux du NIST rattachent la qualité à l'usage prévu et aux exigences métier : notez donc la décision ou l'obligation que les données soutiennent, le résultat précis auquel on se fie, et la conséquence s'il est en retard, faux ou incomplet.
Que doit contenir l'inventaire d'audit ?
Construisez-le à rebours depuis le résultat : rapports, modèles, alertes ou déclarations critiques ; tables sources en amont, couches de staging, logique de transformation et tables de référence ; dépendances opérationnelles comme les calendriers et les consommateurs en aval ; et responsables nommés pour la source, la logique et l'acceptation métier.
Quelles limites évitent les frictions d'audit ?
Quatre. La limite métier nomme la décision ou la déclaration couverte, la limite de données les jeux, champs et périodes, la limite de processus les transformations et passations, et la limite de responsabilité qui approuve les règles, qui corrige et qui valide.



