Corriger les anomalies de la base de données : garantir une IA fiable
|
6
minute de lecture

Vous êtes probablement confronté à l'un de deux symptômes en ce moment. Une table transactionnelle ne cesse de produire des doublons, des clés étrangères nulles ou des enregistrements qui ne peuvent pas être insérés correctement. Ou alors, votre entrepôt de données semble structurellement correct, mais un tableau de bord a dérivé, la prédiction d'un modèle s'est dégradée, ou un chargement quotidien est arrivé trop tard, faussant ainsi le rapport de la veille.
Ces deux problèmes sont qualifiés d'« anomalies de base de données », mais ils ne relèvent pas du même problème. L'un rompt l'intégrité des données au sein de la conception relationnelle. L'autre rompt la confiance dans les données à travers les pipelines, les analyses et les systèmes d'IA. Les équipes qui les traitent comme une seule et même catégorie investissent généralement trop dans la conception des schémas et pas assez dans la surveillance, ou font l'inverse en essayant de résoudre par l'observabilité un modèle relationnel défaillant.
Cette distinction est cruciale si vous êtes responsable de la fiabilité des analyses. Les anomalies classiques de la conception de bases de données existent toujours, et la normalisation reste essentielle. Cependant, les architectures modernes ont également besoin d'Observability pour détecter les dérives, les retards de fraîcheur et les comportements de schéma qui n'apparaissent pas dans un diagramme entité-relation de manuel scolaire.
Table des matières
Opérationnaliser la surveillance des anomalies et les alertes
De la détection à la résolution : modèles d'analyse des causes profondes
Les deux visages des anomalies de bases de données
Lundi matin, un tableau de bord indique une baisse de 18 % du chiffre d'affaires. L'entrepôt de données fonctionne, les pipelines sont au vert et toutes les tables ont été chargées avec succès. À midi, l'équipe identifie deux problèmes distincts. Une table source présente toujours des attributs clients dupliqués issus d'une ancienne conception, ce qui a provoqué des mises à jour incohérentes. Parallèlement, un nouveau type de champ en amont a modifié la façon dont une transformation gérait les valeurs nulles, de sorte que les chiffres étaient faux alors même que les tâches s'étaient terminées avec succès. Il s'agit dans les deux cas d'anomalies de base de données. Elles appartiennent simplement à des époques différentes de l'architecture technique.
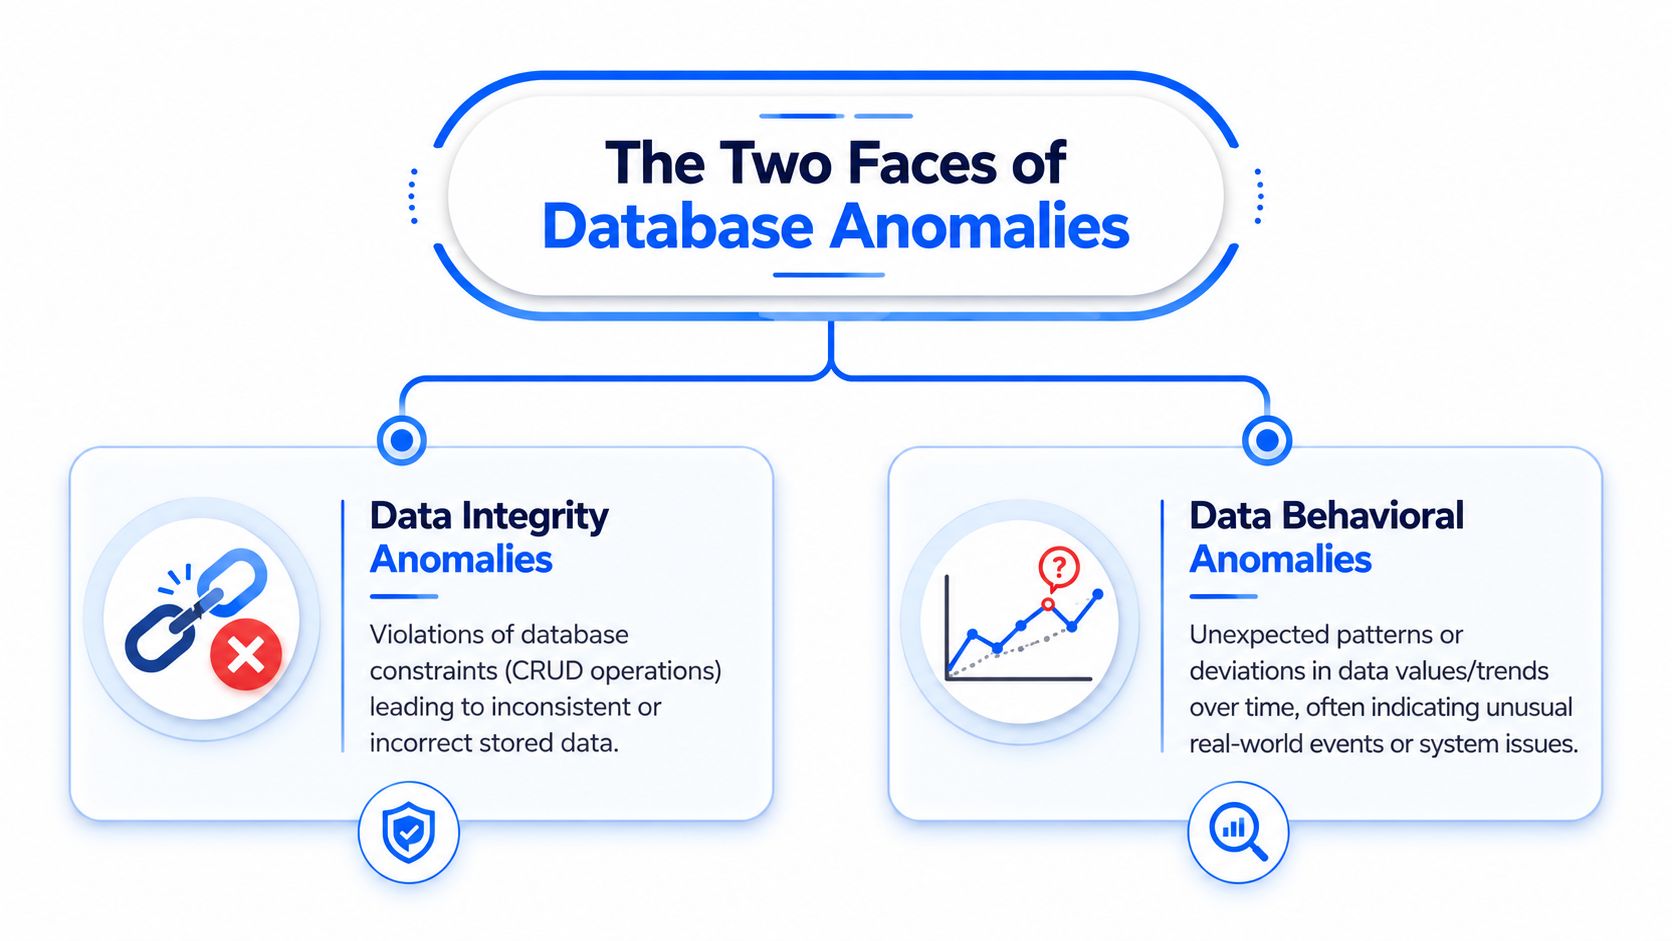
Les anomalies classiques dans la conception relationnelle
La définition classique reste le meilleur point de départ. Dans les systèmes relationnels, des anomalies surviennent lorsque la conception d'une table mélange plusieurs faits au même endroit, répète des données sur plusieurs lignes ou ne parvient pas à appliquer des relations de clés claires. Il en résulte une série prévisible de défauts d'intégrité lors des opérations d'insertion, de mise à jour et de suppression, comme le décrit cette explication de GeeksforGeeks sur les anomalies relationnelles.
Ces trois catégories restent utiles car elles correspondent directement aux erreurs de conception dont les ingénieurs héritent encore en production :
Anomalie d'insertion : une ligne ne peut pas être ajoutée sans fournir des données non liées.
Anomalie de mise à jour : un seul changement métier doit être répété sur plusieurs lignes, ce qui favorise les incohérences.
Anomalie de suppression : la suppression d'un enregistrement supprime également un fait dont l'entreprise a encore besoin.
Les équipes repèrent généralement ces problèmes dans des tables opérationnelles dénormalisées, des outils internes temporaires ou d'anciens schémas de rapport qui ont grandi sans propriété claire. Une adresse client copiée dans chaque ligne de commande fonctionne jusqu'à ce qu'une adresse change et que cinq enregistrements se contredisent. Une table produit intégrée dans une table des ventes fonctionne jusqu'à ce que la dernière vente soit supprimée et que l'historique du produit disparaisse avec elle.
La normalisation a été conçue pour éviter précisément cette catégorie de défaillance. Séparez les faits dans des tables distinctes, attribuez la propriété avec des clés primaires et étrangères, et laissez les contraintes rejeter les états invalides avant que les données erronées ne se propagent. Pour un rappel pratique, consultez ce guide sur la compréhension des causes et solutions des anomalies de base de données.
Une règle s'est particulièrement bien vérifiée dans les systèmes réels : si un même fait métier peut être modifié dans plus d'une ligne, le schéma crée déjà un risque.
Les anomalies modernes dans les produits de données
Le même mot, anomalie, couvre désormais une deuxième catégorie de problèmes. Le schéma peut être valide. Les clés peuvent être correctes. Les contraintes peuvent être respectées. La défaillance se manifeste dans le comportement plutôt que dans l'intégrité relationnelle.
Les exemples sont familiers à toute équipe exécutant des analyses ou du ML en production. Un indicateur quotidien s'écarte de sa plage attendue. Une source arrive avec six heures de retard. Une colonne existe toujours, mais son type ou sa structure de valeurs nulles change suffisamment pour casser les hypothèses en aval. La distribution des entrées d'un modèle dérive alors que le pipeline continue de générer des scores. Ces problèmes ne ressemblent pas à des anomalies d'insertion, de mise à jour ou de suppression, mais ils n'en compromettent pas moins la confiance accordée à la base de données en tant que système d'aide à la décision.
Cette distinction a une importance pratique importante.
Famille d'anomalies | Ce qui casse | Cause typique | Meilleure première réponse |
|---|---|---|---|
Anomalies relationnelles | Intégrité des données stockées | Mauvaise normalisation, redondance, conception de clés faible | Repenser les tables, les clés et les contraintes |
Anomalies comportementales | Fiabilité des résultats d'analyses et d'IA | Dérive, modifications de schéma, écarts de fraîcheur, défaillances de dépendances | Surveiller les modèles de comportement, le lignage, les contrats et les délais de livraison |
Les anomalies classiques nuisent à l'exactitude des faits stockés. Les anomalies modernes nuisent à la fiabilité des conclusions construites à partir de ces faits.
Les équipes d'ingénierie ont besoin d'une couverture pour ces deux aspects. La conception des schémas et la normalisation réduisent les défauts structurels au moment de l'écriture. L'Observability permet de détecter les pannes silencieuses qui apparaissent après l'intégration, la transformation et la consommation. C'est la passerelle qui manque à beaucoup d'équipes, en particulier lorsque la surveillance de l'entrepôt est déconnectée de la conception de la plateforme. Les équipes qui construisent des systèmes fortement axés sur le ML rencontrent souvent ce problème en premier, ce qui explique pourquoi les perspectives plus larges sur l'intelligence artificielle recoupent de plus en plus l'architecture de plateforme de données.
Pourquoi l'analyse moderne et l'IA sont si vulnérables
Une insertion défectueuse échoue de manière flagrante. Un problème de fraîcheur, en revanche, passe souvent inaperçu. C'est pourquoi les architectures modernes se font souvent surprendre.
Les pannes silencieuses font plus de dégâts que les pannes critiques
Les anomalies les plus redoutables ne sont pas celles qui font planter une tâche. Ce sont celles qui produisent un résultat plausible mais faux. Un modèle continue de scorer des enregistrements alors que la distribution de ses entrées a dérivé. Un tableau de bord financier s'affiche correctement, mais les flux sont arrivés en retard et tout le monde consulte des chiffres obsolètes. Une table en aval présente toujours les colonnes attendues, mais un changement de type en amont a modifié l'interprétation des valeurs nulles ou des catégories.
C'est pourquoi le fossé entre l'ancienne et la nouvelle approche des anomalies est devenu coûteux. L'écart critique entre les anomalies traditionnelles de SGBD et les « anomalies de données » modernes (dérive statistique, modifications de schéma, défauts de fraîcheur) laisse les ingénieurs de données démunis face aux dérives silencieuses des modèles de ML et des pipelines en temps réel, où 85 % des problèmes de données proviennent de l'amont mais restent non détectés par les systèmes basés sur des règles.
Pour l'analytique, cela signifie que les décideurs s'appuient sur des rapports déjà dégradés. Pour l'IA, cela signifie que le système peut rester techniquement disponible tout en devenant inutilisable sur le plan opérationnel.
Un pipeline sain peut tout de même acheminer des données erronées.
Pourquoi les seuls contrôles de règles passent à côté du vrai problème
Les équipes commencent souvent par des comptages de lignes, des vérifications de valeurs nulles, des listes de valeurs autorisées et quelques assertions métier. Ces mesures sont indispensables, mais elles s'avèrent insuffisantes.
Les contrôles basés sur des règles sont efficaces lorsque vous connaissez déjà le mode de défaillance. Ils s'avèrent inefficaces face à une dérive progressive, à une saisonnalité changeante, à des retards d'arrivée ou à des interactions complexes entre plusieurs sources. C'est là que les ingénieurs ont besoin de profils de référence appris et d'une détection prenant en compte la dimension temporelle. En pratique, il s'agit de la même évolution que connaissent les équipes dans les systèmes d'IA de manière globale. Pour appréhender comment les systèmes adaptatifs diffèrent des logiques statiques, ces analyses sur l'intelligence artificielle méritent d'être lues parallèlement aux méthodes modernes de surveillance des données.
Quelques scénarios de défaillance moderne illustrent clairement ce risque :
Dérive des entrées du modèle : la table de caractéristiques (features) continue de se charger, mais les distributions de valeurs ne ressemblent plus au jeu d'entraînement.
Défaut de fraîcheur : le lot de traitement nocturne arrive en retard, et tous les tableaux de bord dépendants semblent complets alors qu'ils présentent la situation de la veille.
Changement de comportement du schéma : une colonne renommée ou un changement de type ne bloque pas complètement les transformations, mais altère la sémantique en aval.
Incohérence entre systèmes : une dépendance en amont échoue et les systèmes en aval produisent des données incomplètes mais syntaxiquement valides.
L'ancienne règle était : « normalisez pour éviter les anomalies ». La nouvelle règle est : « surveillez le comportement en continu car une structure propre ne garantit pas des résultats fiables ».
Une boîte à outils moderne pour la détection d'anomalies
Le choix du bon détecteur dépend du profil de défaillance et du contexte opérationnel. Une table financière en traitement par lots, un pipeline de parcours utilisateur (clickstream) et un magasin de caractéristiques peuvent tous faillir de manières différentes tout en paraissant au premier abord opérationnels.
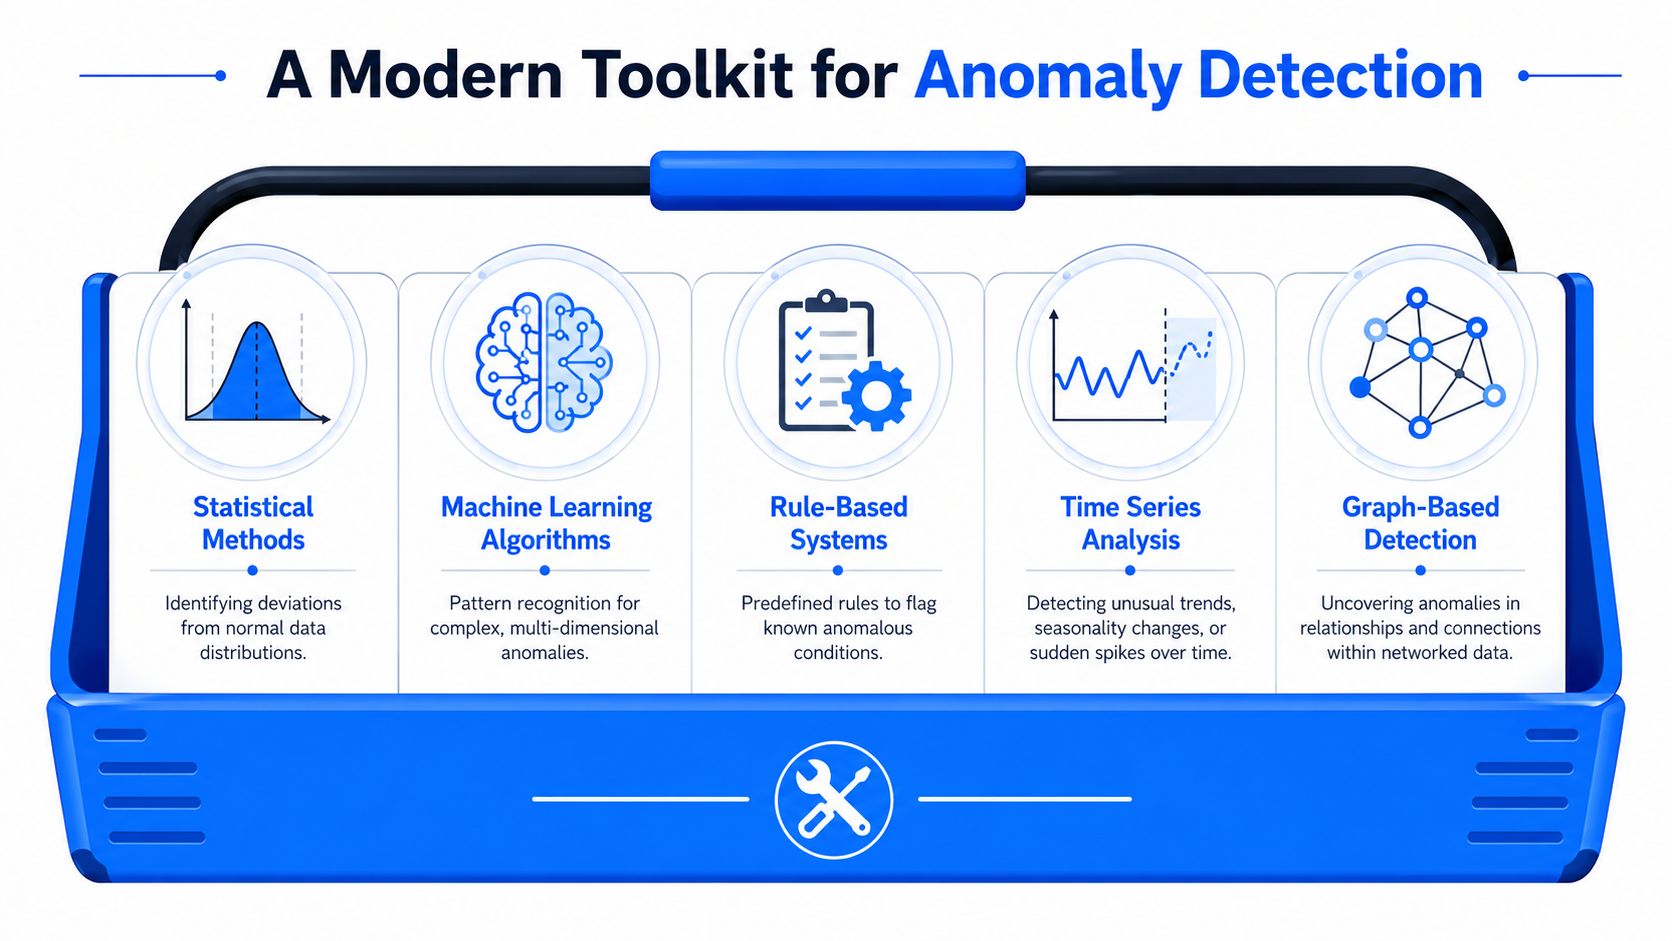
Les anomalies classiques de bases de données ont appris aux équipes à prévenir les états non valides par la conception des schémas et les contraintes. Les architectures de données modernes ajoutent une exigence : détecter les comportements anormaux au fil du temps, même si les tables continuent de se charger et si les requêtes SQL s'exécutent normalement. Une boîte à outils pratique doit couvrir ces deux aspects.
Quand de simples contrôles statistiques suffisent
Commencez par des statistiques pour les signaux qui doivent rester dans une plage opérationnelle étroite. Pour de nombreuses vérifications d'entrepôt, elles représentent toujours le moyen le plus rapide d'établir une référence et le plus simple à expliquer lors de l'analyse d'un incident.
Les options courantes sont directes :
Scores Z : utiles pour les indicateurs globalement stables où les écarts importants par rapport à la moyenne signalent généralement un problème réel.
Écarts interquartiles (IQR) : utiles pour les distributions asymétriques et pour repérer les valeurs très éloignées de la dispersion normale.
Comparaison de tendances : efficace lorsque la journée en cours doit ressembler à l'historique récent dans une marge raisonnable.
Ces vérifications sont peu coûteuses à exécuter et faciles à mettre en œuvre en SQL. Elles fonctionnent bien pour le volume de lignes, les pics de valeurs nulles, la recrudescence de doublons et les variations soudaines des valeurs agrégées.
Elles montrent leurs limites de manière prévisible : la saisonnalité, les retards de livraison en amont, les promotions, les lancements de produits et les interactions multi-tables peuvent faire paraître suspect un jeu de données sain, ou masquer un problème réel au sein d'un pic attendu.
Où se situe la surveillance basée sur des règles
Les règles s'appliquent partout où l'entreprise peut formuler clairement un invariant. L'unicité des clés primaires, les champs requis, les énumérations autorisées, l'intégrité référentielle et les attentes de schéma définies par contrat constituent toujours le socle.
Cela compte car les anomalies classiques d'insertion, de mise à jour et de suppression n'ont jamais vraiment disparu. Elles se manifestent simplement sous de nouvelles formes. Une fusion (merge) défectueuse peut dupliquer les fiches clients. Une synchronisation partielle peut mettre à jour un système mais pas un autre. Une suppression logique (soft delete) peut masquer des faits dans les rapports en aval tout en laissant suffisamment de structure pour que le traitement s'exécute avec succès.
Méthode | Idéal pour | Point fort | Limite |
|---|---|---|---|
Contrôles statistiques | Valeurs aberrantes et variations soudaines | Rapide et interprétable | Peu efficace face aux comportements complexes liés au contexte |
Contrôles basés sur des règles | Contraintes métier connues | Précis et auditable | Passe à côté des modes de défaillance inconnus |
Détection basée sur le ML | Profils complexes et subtils | S'adapte aux comportements multidimensionnels | Plus difficile à calibrer et à expliquer |
Utilisez des règles pour protéger les vérités établies. Appliquez-les rigoureusement sur les tables à haut risque. Ne vous attendez pas pour autant à ce qu'elles détectent les dérives de fraîcheur, les changements sémantiques ou les lentes dérives de distribution au niveau des entrées des modèles.
Quand l'apprentissage automatique fait ses preuves
L'apprentissage automatique devient pertinent lorsque le comportement normal comporte trop de dimensions pour un seuil configuré manuellement. C'est le cas pour les flux d'événements, les magasins de caractéristiques (feature stores), la télémétrie d'usage et tout indicateur sujet à une saisonnalité changeante ou à des dépendances multi-systèmes.
Certaines méthodes s'avèrent systématiquement utiles en pratique :
Forêts d'isolement (Isolation Forests) : adaptées pour identifier les enregistrements ou les périodes inhabituelles dans de grands jeux de données sans ingénierie de caractéristiques complexe.
Modèles LSTM : utiles pour le suivi des séries temporelles lorsque les schémas chronologiques importent et que les moyennes mobiles simples génèrent trop de fausses alertes.
Méthodes k-NN et naïves bayésiennes : choix courants lorsque la détection d'anomalies s'appuie sur le comportement de voisinage ou sur les relations probabilistes entre les champs.
Détection non supervisée : utile lorsque les données d'anomalies étiquetées sont rares, ce qui est fréquent dans les systèmes de production réels.
Le compromis est d'ordre opérationnel, non académique. Les détecteurs basés sur le ML peuvent révéler les défaillances silencieuses que les règles ignorent, mais ils requièrent un étalonnage, des décisions de réentraînement et une surveillance accrue. Si personne ne sait expliquer pourquoi une alerte s'est déclenchée, les équipes finissent par ignorer le système.
Une approche plus robuste consiste à combiner les méthodes au sein d'une même couche de surveillance. Utilisez des contraintes pour les pannes franches, des statistiques pour le filtrage rapide et des profils de référence appris pour les comportements qui évoluent dans le temps. Les équipes qui évaluent cette approche peuvent étudier les techniques de détection d'anomalies par IA intégrées aux entrepôts, qui se concentrent sur une surveillance apprise directement au sein de la plateforme de données plutôt que sur des tests statiques.
Utilisez différents outils pour des tâches distinctes. Les contraintes bloquent les états invalides. Les contrôles statistiques identifient les dérives visibles. Le ML aide à intercepter les anomalies silencieuses qui passent à travers toutes les règles tout en faussant les décisions en aval.
Opérationnaliser la surveillance des anomalies et les alertes
Une détection sans organisation opérationnelle se résume à du bruit. Les équipes n'échouent pas par manque d'alertes, mais parce que personne ne fait assez confiance à ces alertes pour agir rapidement.
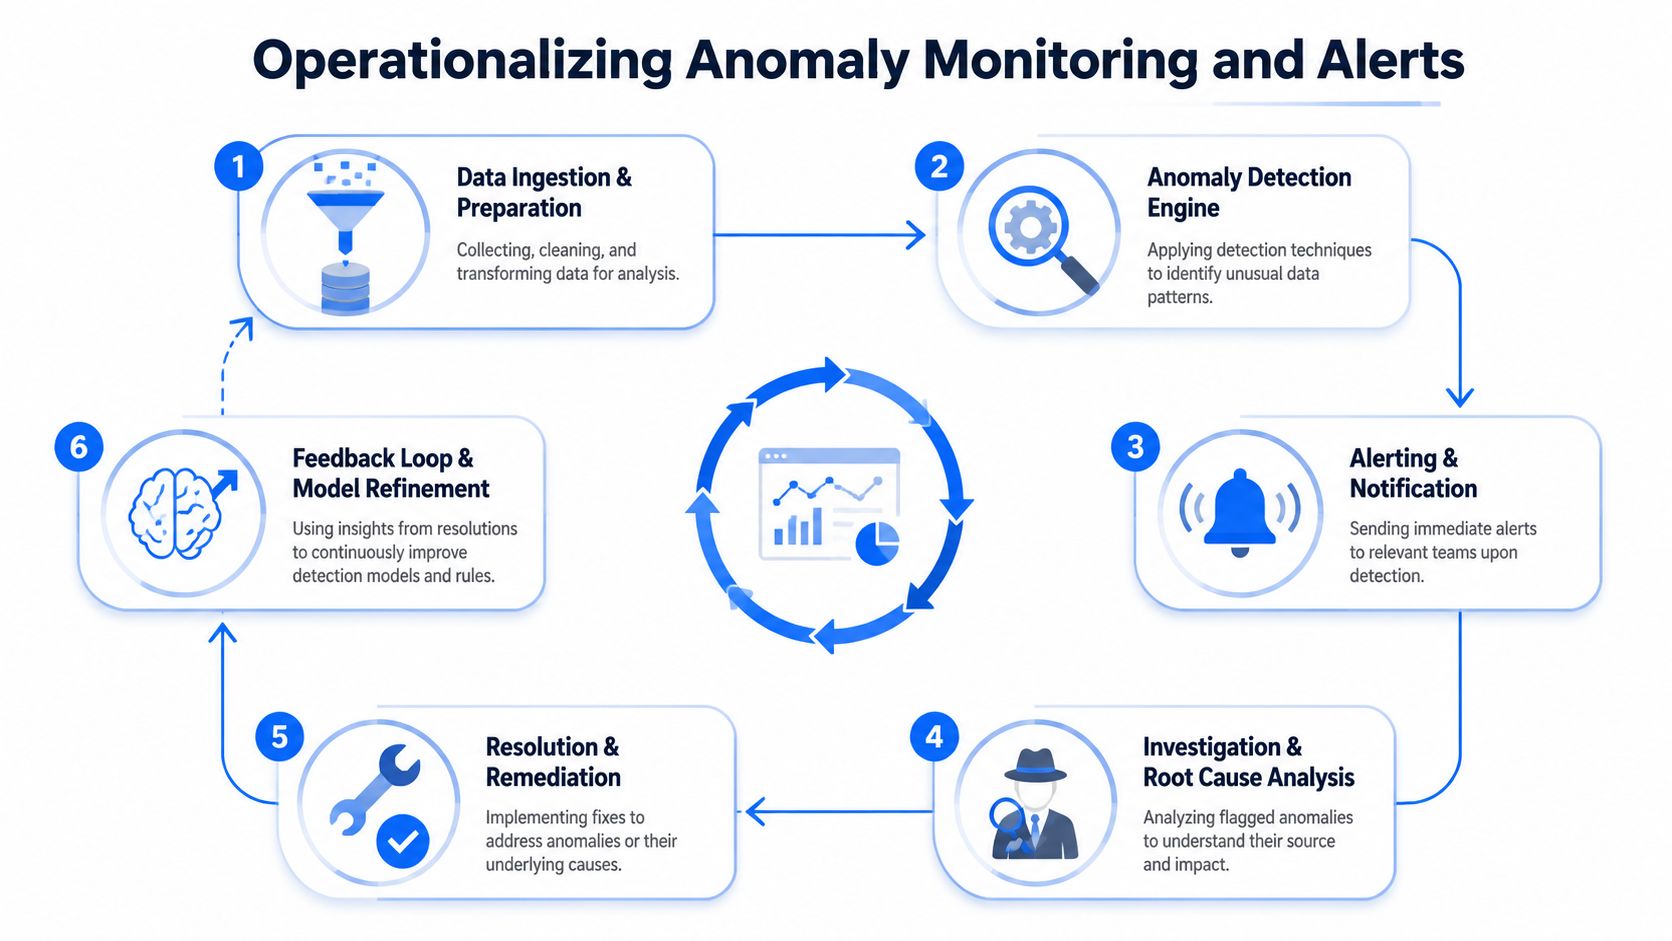
Construire un parcours d'alerte auquel les collaborateurs feront vraiment confiance
Une configuration de surveillance viable commence par la définition des responsabilités, et non par le choix des outils. Chaque jeu de données critique, table de caractéristiques et flux de tableau de bord doit avoir un propriétaire désigné au sein des équipes et une définition claire de ce qui constitue un état défaillant.
L'organisation technique qui fonctionne s'avère plus ciblée que ce que la plupart des organisations imaginent :
Donnez la priorité aux tables critiques pour le métier. Commencez par les jeux de données qui alimentent les tableaux de bord de direction, la facturation, les rapports réglementaires ou les modèles opérationnels.
Surveillez plusieurs dimensions. Les anomalies de valeurs, la ponctualité, le comportement du schéma et les défauts de validation doivent être traités comme des signaux distincts.
Utilisez des références dynamiques là où le comportement évolue. Les seuils statiques conviennent pour les limites absolues. Ils s'avèrent inefficaces pour les métriques cycliques.
Acheminez les alertes par domaine. L'équipe propriétaire du système source doit voir les anomalies de la source en premier. Les utilisateurs finaux doivent recevoir les alertes d'impact.
Supprimez les doublons. Un problème racine unique ne devrait pas générer dix incidents distincts.
Une liste de contrôle rapide aide à maintenir des alertes de qualité élevée :
Rendez les alertes explicables : mentionnez le jeu de données affecté, la fenêtre temporelle, l'indicateur et l'écart constaté.
Séparez le symptôme de la source : indiquez si le problème apparaît lors de l'intégration, de la transformation, au niveau du schéma ou dans le résultat final.
Ajoutez du contexte : présentez l'historique récent afin qu'un ingénieur puisse déterminer s'il s'agit d'un pic, d'une baisse, d'un retard ou d'une rupture de tendance.
Privilégiez la capacité d'action : si l'alerte n'indique pas un propriétaire évident ou une étape suivante claire, affinez-la avant de la déployer largement.
Utiliser un flux de résolution plutôt qu'un débogage ad hoc
Le processus de résolution doit être standardisé. Le processus de traitement des anomalies suit un parcours normalisé : consignation de l'anomalie avec ses métadonnées, consultation des parties prenantes pour confirmer les règles métier, validation du problème dans des environnements de préproduction, déploiement de correctifs rétrocompatibles accompagnés de plans de retour arrière, et documentation des résolutions pour prévenir toute réapparition (Présentation de Gable sur les flux de résolution d'anomalies).
Cette séquence est essentielle car elle évite un écueil classique. Un ingénieur constate une anomalie, modifie une transformation en aval et ferme l'incident sans vérifier si la source en amont a été modifiée de manière intentionnelle. L'indicateur se rétablit momentanément, mais la cause profonde persiste.
J'ai vu des équipes améliorer la qualité de leurs alertes en traitant la gestion des anomalies comme un traitement d'incidents plutôt que comme de la maintenance de tableaux de bord. Lorsque les alertes intègrent des métadonnées, une attribution claire, une validation en environnement de test et un plan de retour arrière, les discussions pour savoir si l'anomalie est « réelle » s'estompent au profit d'une investigation méthodique.
Note de terrain : si votre premier réflexe face à une anomalie consiste à ouvrir l'éditeur SQL pour modifier la logique, vous agissez probablement de manière précipitée. Confirmez d'abord l'exigence métier.
De la détection à la résolution : modèles d'analyse des causes profondes
Une fois l'anomalie détectée, le travail change de nature. La détection répond à la question : « Est-ce inhabituel ? ». L'analyse des causes profondes cherche à savoir : « Qu'est-ce qui a changé, à quel endroit, et ce changement était-il prévu ? ».
Les équipes les plus rapides ne mènent pas leurs investigations au hasard. Elles s'appuient sur des schémas récurrents basés sur la manière dont les anomalies se propagent habituellement.
Modèle un : tracer le lignage avant de toucher au code
Pour les anomalies contextuelles, le lignage s'avère souvent le chemin le plus court vers la cause réelle. La tendance actuelle s'oriente vers l'intégration d'une détection d'anomalies sensible aux métadonnées, capable de remonter le lignage vers l'amont pour identifier la source réelle, réduisant ainsi le temps d'analyse des causes profondes de 60 %, une capacité essentielle pour les anomalies contextuelles face auxquelles les méthodes statistiques classiques échouent.
Cet aspect est important car la table où se manifeste l'anomalie n'est souvent pas celle qui en est à l'origine. Un datamart de restitution peut mettre en évidence une chute de revenus, alors que l'anomalie réelle provient d'un travail d'intégration tardif en amont ou d'une clé de jointure modifiée dans une couche intermédiaire.
Un diagnostic s'appuyant sur le lignage se déroule généralement ainsi :
Démarrez depuis l'élément impacté : composant graphique de tableau de bord, table d'exposition ou jeu de données pour modèle d'apprentissage.
Remontez l'amont, dépendance par dépendance : contrôlez la fraîcheur, l'historique du schéma et les exécutions de transformation.
Arrêtez-vous à la première frontière anormale : le premier emplacement où une entrée saine se transforme en sortie altérée abrite généralement la cause première.
Modèle deux : séparer les événements métier des anomalies de données
Toute variation soudaine n'est pas synonyme de données corrompues. Parfois, l'anomalie réside dans l'activité réelle de l'entreprise.
Les ingénieurs commettent parfois l'erreur de limiter leurs recherches au seul entrepôt de données. Face à une variation brusque d'indicateur, posez-vous simultanément deux questions. Le code ou le schéma ont-ils changé ? L'entreprise a-t-elle lancé une promotion, sorti un produit, migré des clients ou modifié un parcours ? Ces deux types de causes peuvent générer un graphique identique.
Une grille de lecture utile consiste à classer les indices en trois catégories :
Type d'indice | Ce que cela suggère |
|---|---|
Changement de déploiement, de schéma ou de pipeline | Une anomalie technique est probable |
Événement externe ou action commerciale | Le signal du monde réel peut être fondé |
Aucun changement évident constaté | Recherchez une dépendance cachée ou un problème de ponctualité |
Cette répartition évite aux équipes de « corriger » un signal métier légitime ou d'ignorer une régression technique qui présente une apparence commerciale plausible.
Considérez chaque anomalie à la fois comme une question de données et une question métier, jusqu'à ce que l'une des hypothèses soit écartée.
Modèle trois : vérifier conjointement la structure et la temporalité
Les anomalies de schéma et de fraîcheur sont souvent liées. Un flux qui arrive en retard peut déclencher des valeurs par défaut, des chargements fragmentaires ou l'omission de transformations en aval. Un changement de type peut préserver des indicateurs de fraîcheur normaux tout en dégradant insidieusement les valeurs.
Lors de l'analyse, associez ces vérifications plutôt que de les mener séparément :
Contrôle de schéma : colonnes ajoutées ou supprimées, modifications de types, changements de gérabilité du nul, modification des clés.
Contrôle temporel : heure de livraison attendue par rapport à l'arrivée effective, exécution partielle d'un lot, comportement lors des tentatives d'exécution.
Contrôle des valeurs : dérives de distribution, hausses soudaines de valeurs nulles, déséquilibre des catégories, jointures défaillantes.
Les ingénieurs confirmés progressent plus rapidement lorsqu'ils cessent d'analyser les anomalies comme de simples fluctuations sur une courbe pour les appréhender comme les manifestations d'un comportement système. L'anomalie observée sur l'indicateur n'est que l'indice visible. La cause profonde réside généralement dans l'interface entre les systèmes, et non sur le graphique lui-même.
L'avantage in-database : architecture et governance
Sur le plan architectural, la gestion des anomalies est simplifiée lorsque la détection s'effectue au plus près des données. Il ne s'agit pas d'un simple choix de performance. Cela influe sur la confidentialité, la governance et la charge d'exploitation.

Pourquoi l'Observability in-database transforme le modèle opérationnel
Lorsque la surveillance nécessite d'exporter de grands volumes de données vers un service externe, les équipes introduisent des processus de transfert, de duplication et des validations de governance sur un problème qui requiert déjà une analyse rapide. L'exécution in-database élimine une grande partie de ces contraintes.
Les principaux avantages architecturaux sont évidents :
Contrôle de la confidentialité : les données sensibles de production demeurent dans l'environnement maîtrisé par le client, évitant ainsi toute exportation externe pour analyse.
Réduction des coûts de transfert : vous calculez les indicateurs là où résident les tables, sans transférer de données brutes.
Simplicité opérationnelle : les ingénieurs de données s'appuient sur les ressources, privilèges et architectures d'ordonnancement natifs de l'entrepôt.
Gouvernance renforcée : il est plus aisé de faire converger l'Observability avec les politiques de gestion des accès, les exigences d'audit et les obligations de localisation des données.
Ce modèle se révèle particulièrement précieux dans les secteurs de la finance, de la santé, des télécommunications et des administrations publiques, où l'identité des personnes pouvant inspecter les données est aussi déterminante que la détection même des anomalies.
How a unified platform maps to real anomaly classes
Une architecture d'Observability robuste doit couvrir les deux aspects des anomalies présentés précédemment. Les protections structurelles relèvent toujours de la conception de schéma et des règles de validation. Le suivi comportemental repose sur une analyse continue mariant valeurs, temporalité et structure.
C'est pourquoi une approche intégrée se révèle plus fructueuse qu'un ensemble de contrôles disparates. Nous pouvons citer l'exemple de digna, qui exécute ses analyses directement au sein des bases de données clientes et réunit plusieurs capacités répondant aux catégories d'anomalies courantes :
Data Anomalies : profils de référence appris pour détecter les variations de comportement inattendues dans les tables configurées.
Timeliness : détection des arrivées tardives ou manquantes vis-à-vis des modèles appris et des calendriers prévus.
Schema Tracker : identification des colonnes ajoutées ou retirées, ainsi que des altérations de types de données.
Data Validation : application de règles au niveau de l'enregistrement pour répondre aux exigences fonctionnelles et d'audit.
Data Analytics : indicateurs d'Observability historiques facilitant l'évaluation des tendances et la hiérarchisation des actions.
Cette approche est majeure pour la governance car elle permet aux équipes d'analyser les dérives de tendances, la ponctualité et les changements de structure au sein d'une interface d'exploitation unique, sans confier les données opérationnelles à un tiers. Sur le plan de l'architecture, la même plateforme est en mesure de prendre en charge des tables d'entrepôt, des espaces de datalake ou différents pipelines, tout en maintenant l'essentiel du traitement analytique là où les données résident.
Le bénéfice concret ne réside pas dans l'élimination magique de toute anomalie par un outil unique. Il tient à la cohérence du modèle opérationnel ainsi établi. Les ingénieurs préservent l'hygiène relationnelle classique lors de la modélisation, appliquent des validations là où les règles business sont formalisées, et adjoignent une surveillance des comportements pour les types de défaillances que la normalisation n'a jamais eu vocation à intercepter.
Une IA de confiance repose sur un comportement de données fiable, pas seulement sur des schémas cohérents. Si votre équipe requiert une détection d'anomalies, un suivi des délais de livraison, une surveillance des schémas et des validations au sein d'un environnement maîtrisé, digna constitue une solution in-database pertinente à étudier.


