Significado de los datos obsoletos: Cómo prevenir desastres en analítica e IA
|
7
minuto de lectura

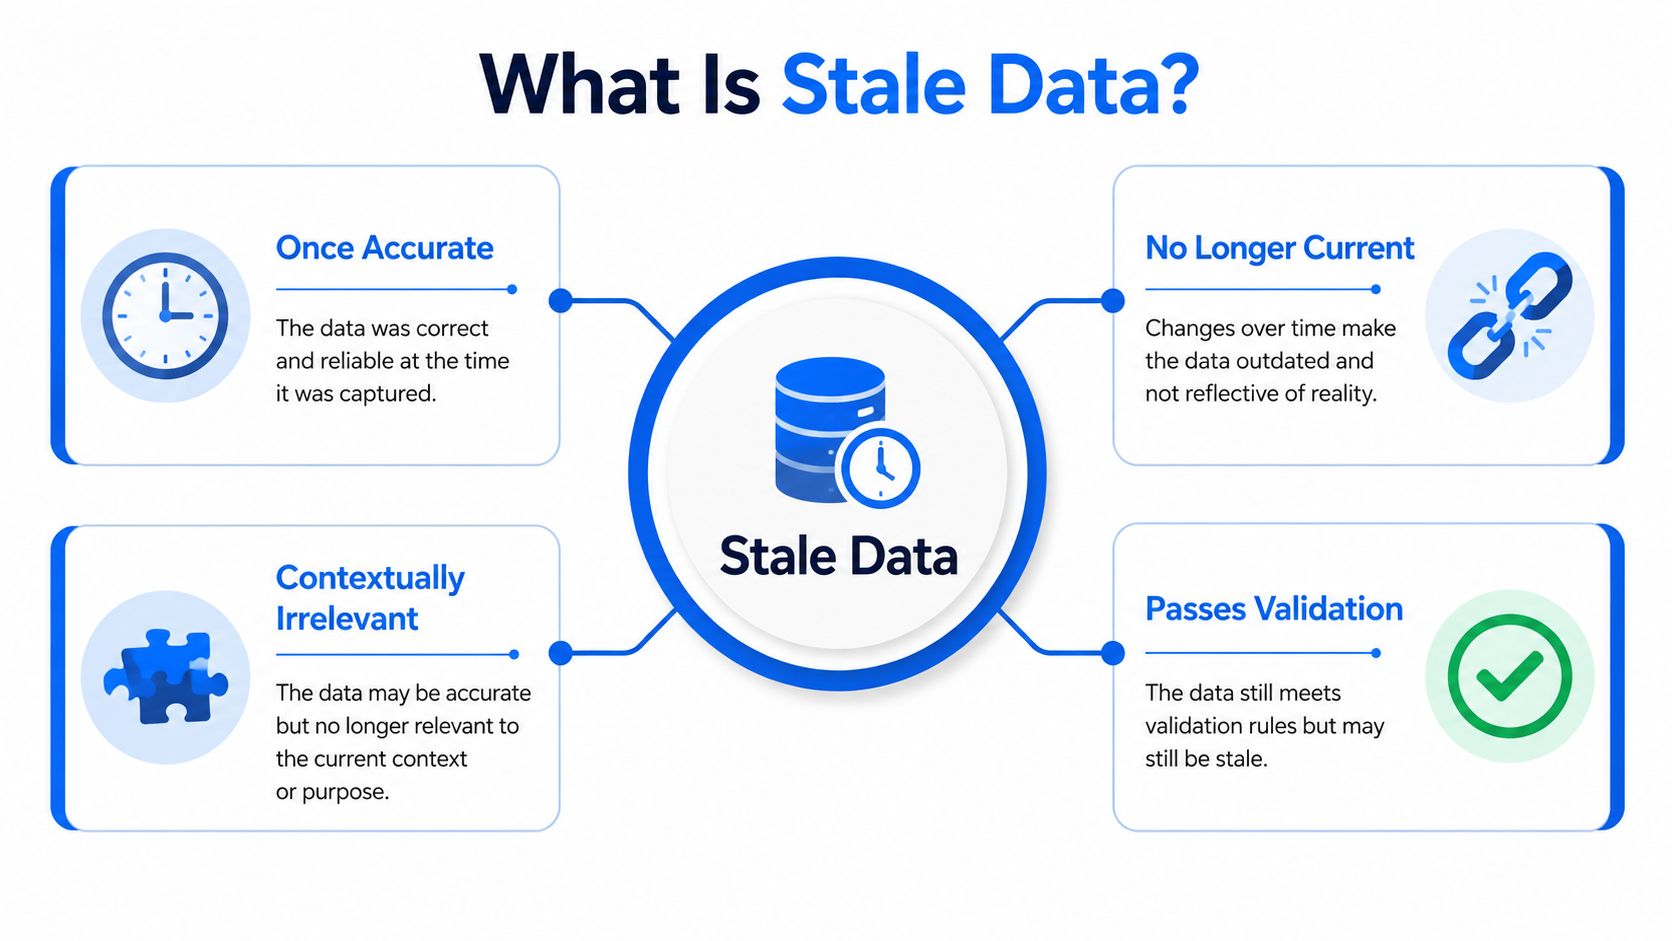
Los datos obsoletos (stale data) significan que los datos siguen siendo técnicamente válidos, pero son demasiado antiguos para la tarea que se les pide realizar. No reflejan la realidad actual porque el proceso de ingesta se ha detenido, ralentizado o retrasado, y ese tipo de envejecimiento silencioso puede corromper las decisiones sin generar errores evidentes.
Por lo general, uno se da cuenta del problema después de que el daño ya está hecho. Un panel de control parece normal. Un modelo sigue mostrando predicciones. Un informe sigue llegando a los líderes a tiempo. Luego alguien pregunta por qué la campaña se dirigió al público equivocado, por qué el inventario parecía disponible cuando no lo estaba, o por qué un flujo de trabajo automatizado actuó sobre información que ya había cambiado anteriormente.
Por eso el significado de los datos obsoletos importa mucho más allá de una definición de diccionario. Los datos obsoletos no son datos rotos. Son datos antiguos que todavía parecen sanos. En la práctica, esto los hace más peligrosos que muchos fallos evidentes de calidad de datos. Los equipos suelen detectar rápidamente picos de nulos, rupturas de esquemas o trabajos fallidos. Pasan por alto la obsolescencia porque la tabla todavía existe, la consulta se sigue ejecutando y los valores siguen superando las comprobaciones básicas.
La solución también depende de diagnosticar correctamente el problema. No todos los incidentes de datos incorrectos son un problema de frescura. Algunos registros están corrompidos. Algunos conjuntos de datos no se utilizan. Algunas canalizaciones llegan tarde. Si trata todo eso como "datos desactualizados", perderá tiempo aplicando la solución equivocada y dejará el riesgo real donde está.
Índice de contenidos
El riesgo oculto en su último informe
Un vicepresidente abre un panel de segmentación el lunes por la mañana y aprueba una campaña. La lógica de la audiencia parece correcta. El gráfico se carga. Nadie ve ningún error. Más tarde, el equipo se entera de que los datos de los clientes que respaldaban ese panel no se habían actualizado durante días.
Ese es un fallo estándar por datos obsoletos. Los datos no estaban mal formados. No faltaban. Simplemente, ya no coincidían con el estado del negocio.
Por este motivo, los datos obsoletos deben tratarse primero como un riesgo empresarial y, en segundo lugar, como un problema de canalización. Cuando un conjunto de datos deja de actualizarse, cada artefacto derivado hereda el mismo problema. Los paneles de control se convierten en instantáneas históricas que fingen estar actualizadas. Los trabajos de ETL inverso introducen las suposiciones de ayer en los sistemas operativos. Las características de ML envejecen hasta que las predicciones se vuelven menos relevantes.
Los datos obsoletos son peligrosos precisamente porque todavía parecen utilizables.
Los equipos más nuevos suelen esperar que las canalizaciones rotas fallen de forma ruidosa. En realidad, muchas no lo hacen. Un trabajo programado puede seguir teniendo éxito mientras que la extracción previa se ha estancado. Una tabla de almacén de datos puede seguir admitiendo consultas mientras que el retraso de replicación la mantiene por detrás de la realidad. Una capa almacenada en caché puede devolver registros estructuralmente correctos que ya no son oportunos.
Pronto aparecen algunas consecuencias prácticas:
Los líderes toman decisiones urgentes basándose en un contexto antiguo. El marketing, la fijación de precios, el soporte y las operaciones dependen del tiempo, no solo de la exactitud.
La confianza se erosiona de manera desigual. Puede que los usuarios no abandonen todo el conjunto de datos, pero empiezan a dudar de aquellos informes que ya les han fallado anteriormente.
Los equipos crean soluciones manuales. Una vez que disminuye la confianza, la gente exporta archivos CSV, mantiene hojas de cálculo paralelas o pide a ingeniería validaciones puntuales.
Ese último paso es donde crece el coste. Los ingenieros dejan de mejorar los sistemas y empiezan a demostrar si la última cifra está lo suficientemente actualizada como para usarse. Una vez que esto sucede, los datos obsoletos ya no son un incidente aislado. Es un problema del modelo operativo.
Qué son realmente los datos obsoletos
A nivel técnico, los datos obsoletos son información cuya antigüedad supera el retraso máximo que su uso previsto puede tolerar. Tacnode los define como datos cuya antigüedad ha superado el umbral aceptable para su uso operativo, a menudo causado por la latencia de la canalización por lotes, el retraso de sincronización de la caché o los retrasos de replicación, y señala que en los sistemas de IA puede causar una deriva silenciosa de datos sin las alertas de error estándar (Explicación de Tacnode sobre los datos obsoletos).
Esa definición importa porque separa la validez de la Timeliness. Una fila puede superar las comprobaciones de tipo, de unicidad y la validación de reglas de negocio y, aun así, ser incorrecta para la decisión que tiene ante sí porque el mundo cambió después de la ingesta.
Por qué los datos obsoletos son difíciles de detectar
Las organizaciones suelen aprender por primera vez el significado de los datos obsoletos a través del fracaso. Un informe "funciona" hasta que alguien lo coteja con un sistema de origen y ve la diferencia en la marca de tiempo. Esto se debe a que los datos obsoletos no suelen infringir las reglas que usted ya supervisa.
Una tabla con estados de clientes antiguos sigue teniendo ID válidos. Los saldos antiguos siguen pareciendo saldos. Los eventos históricos de los dispositivos se siguen deserializando correctamente. Si sus comprobaciones se centran únicamente en el esquema, los nulos, los rangos o el recuento de filas, los datos obsoletos pueden colarse sin ser detectados.
Un mejor modelo mental es este:
El registro fue preciso en su momento
El registro sigue pareciendo estructuralmente correcto
El registro ya no refleja el estado actual necesario para la acción
Si desea un marco más amplio sobre cómo encaja la frescura en la fiabilidad de los datos, esta guía sobre la frescura de los datos y las decisiones de negocio es un complemento útil.
Datos obsoletos (stale) frente a podridos (rotten) frente a oscuros (dark)
Esta distinción es donde muchos equipos se equivocan. Proofpoint separa explícitamente los datos obsoletos de los datos podridos y los datos oscuros, definiendo los datos obsoletos como desactualizados, no utilizados o irrelevantes; los datos podridos como inexactos o corrompidos; y los datos oscuros como información no analizada que reside en los sistemas sin ser utilizada (Definiciones de Proofpoint sobre datos obsoletos, podridos y oscuros).
Esas categorías requieren respuestas diferentes.
Estado de los datos | Qué significa | Síntoma típico | Respuesta correcta |
|---|---|---|---|
Datos obsoletos (Stale data) | Desactualizados pero aún válidos | Los valores parecen correctos, pero la sincronización es incorrecta | Actualizar la canalización, aplicar comprobaciones de frescura |
Datos podridos (Rotten data) | Inexactos o corrompidos | Valores no válidos, lógica rota, errores a nivel de registro | Validar registros, corregir transformaciones, reparar la calidad del origen |
Datos oscuros (Dark data) | Almacenados pero no analizados | Los datos se acumulan sin propietario ni uso | Gobernar el acceso, clasificarlos, archivarlos o activarlos |
Regla práctica: Si una actualización de la marca de tiempo solucionara el problema, probablemente se trate de datos obsoletos. Si los valores en sí son incorrectos, no lo es.
Esto importa aún más en los sistemas de IA y ML. Un almacén de características obsoleto puede alimentar un modelo con entradas que alguna vez fueron correctas pero que ya no están actualizadas. Un conjunto de características podrido crea un modo de fallo diferente porque los valores no son válidos en el momento de la inferencia. Un conjunto de datos oscuro crea otro problema completamente distinto porque la organización almacena información sin utilizarla ni gobernarla bien.
Tratar las tres como una sola categoría lleva a soluciones genéricas como "supervisar las marcas de tiempo en todas partes". Eso ayuda con la obsolescencia. No repara los registros corrompidos. No le dice si los datos no utilizados deben conservarse, analizarse o eliminarse. La precisión en el diagnóstico es lo que hace que la remediación sea efectiva.
Datos obsoletos vs Latencia vs Deriva de datos (Data Drift)
Estos términos se mezclan en las revisiones de incidentes, pero describen diferentes modos de fallo. Si los confunde, el análisis de la causa raíz se vuelve complicado y los equipos comienzan a solucionar los síntomas en lugar de los sistemas.
Una comparación práctica
Atributo | Datos obsoletos (Stale Data) | Latencia de datos | Deriva de datos (Data Drift) |
|---|---|---|---|
Problema central | Los datos son demasiado antiguos para el caso de uso | Los datos llegan más tarde de lo esperado | Los patrones de datos cambian con el tiempo |
Pregunta principal | ¿Sigue este conjunto de datos lo suficientemente actualizado como para usarse? | ¿Cuánto tarda un evento en aparecer downstream? | ¿Ha cambiado el comportamiento subyacente? |
Causa típica | Actualizaciones rotas, actualización retrasada, canalizaciones descuidadas | Ingesta lenta, procesamiento en cola, retraso de red o del sistema | Cambios de comportamiento en el mundo real, poblaciones cambiantes, entradas en evolución |
Lo que ven los usuarios | Los informes parecen normales pero reflejan la realidad pasada | Los paneles de control se retrasan con respecto a los eventos en vivo | Los resultados del modelo se debilitan o pierden relevancia |
Mejor primera comprobación | Marca de tiempo de la última actualización | Tiempo transcurrido desde el evento hasta la disponibilidad | Distribución y comportamiento de las características a lo largo del tiempo |
La latencia tiene que ver con el retraso en el transporte. La obsolescencia tiene que ver con la usabilidad en relación con un umbral. La deriva tiene que ver con el cambio en el proceso de generación de datos.
Un buen ejemplo es el inventario. Si se produce una venta y la actualización aparece en el almacén de datos más tarde de lo esperado, eso es latencia. Si la tabla del almacén de datos no se ha actualizado durante tanto tiempo que los números de stock ya no son útiles, se trata de datos obsoletos. Si los patrones de demanda de los clientes cambian y su previsión de demanda ya no coincide con la realidad, eso es deriva de datos (data drift).
Por qué los equipos los confunden
La confusión ocurre porque estos problemas pueden encadenarse.
El procesamiento por lotes introduce latencia por diseño. Una latencia excesiva puede producir datos obsoletos para un flujo de trabajo urgente. Luego, las entradas obsoletas del modelo pueden contribuir a una degradación silenciosa del rendimiento que parece una deriva desde la perspectiva del negocio.
Esa secuencia es especialmente común en los sistemas de ML. Los equipos suelen supervisar si el modelo está "activo" y si las solicitudes de inferencia se devuelven correctamente. No siempre supervisan si los valores de las características reflejan el último estado que necesita el modelo. El sistema sigue funcionando, pero no con el contexto actual.
Una forma sencilla de separarlos durante el triaje es hacer tres preguntas en orden:
¿Cuándo ocurrió el evento de origen?
¿Cuándo lo recibió o expuso el sistema downstream?
Incluso si llegó correctamente, ¿sigue estando lo suficientemente fresco para la decisión?
Esas preguntas dividen el problema claramente. Primero, el momento del movimiento. Luego, la antigüedad en el momento de uso. Por último, el cambio de comportamiento a lo largo del tiempo.
El impacto empresarial de los datos obsoletos
Un informe puede ser técnicamente correcto y, aun así, ser incorrecto para la decisión que tiene ante sí.
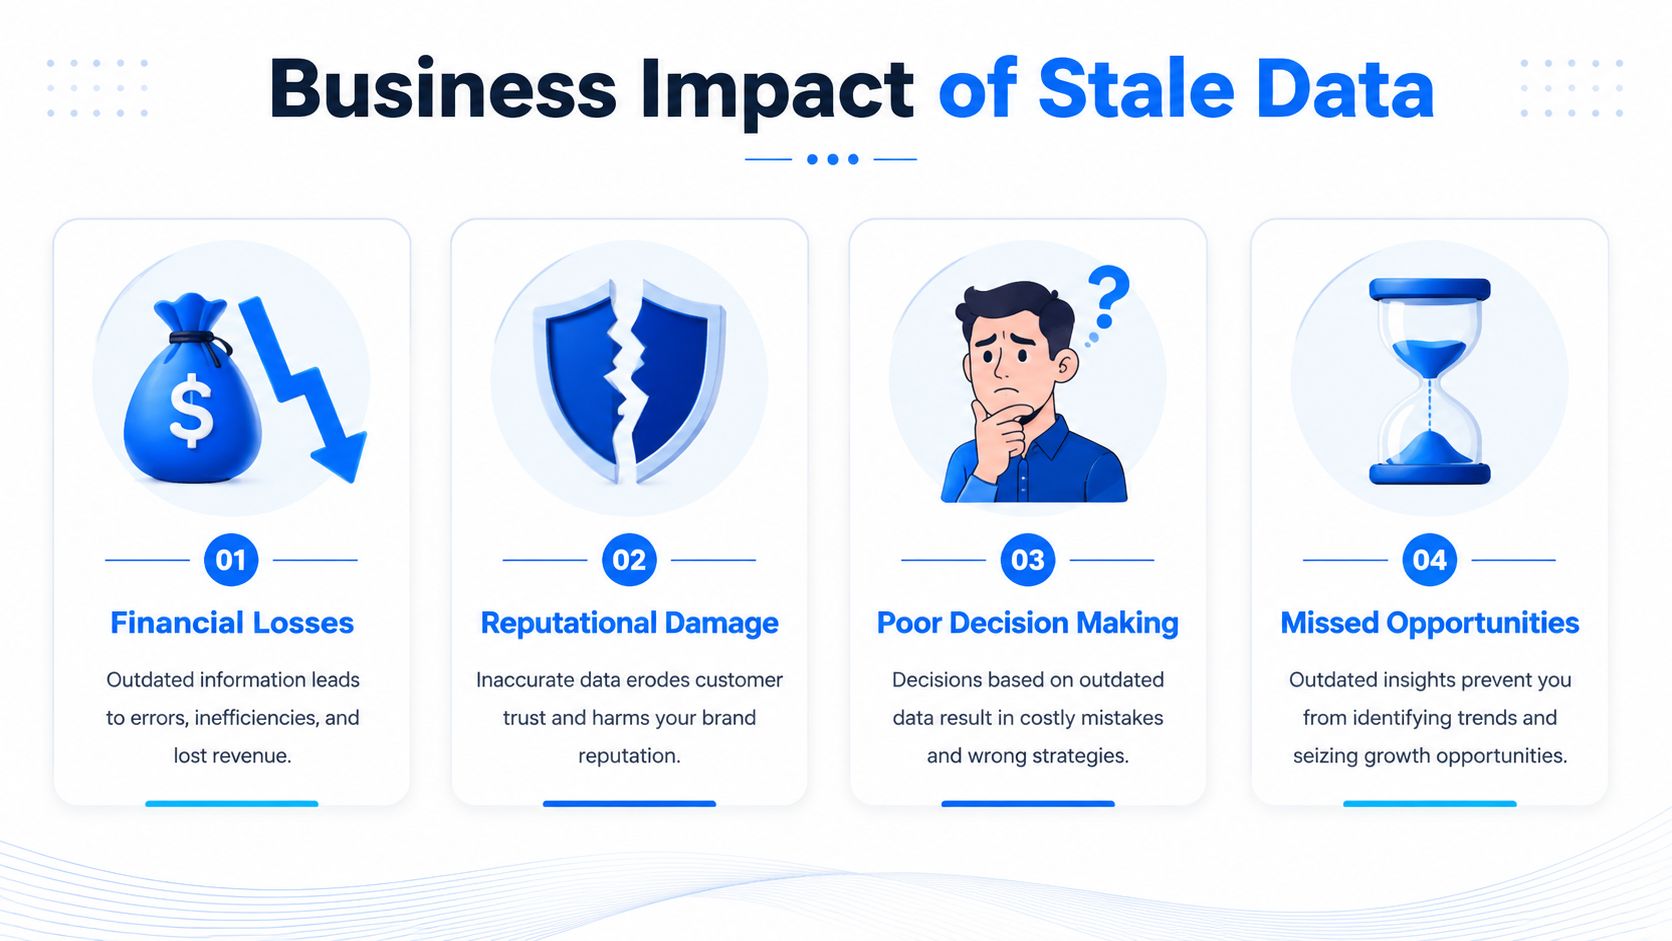
Así es como los datos obsoletos causan daños al negocio. Las cifras coinciden. El panel se carga. El modelo devuelve una predicción. Pero el estado subyacente ya ha cambiado, por lo que los equipos actúan sobre una versión de la empresa que ya no existe.
Dónde aparece primero el daño
El primer impacto suele ser operativo. El equipo de ventas trabaja con cuentas equivocadas porque el estado de la cuenta cambió después de la última sincronización. Los agentes de soporte responden sin el contexto más reciente de facturación o uso del producto. Finanzas cierra la semana utilizando informes que reflejan un estado anterior de pedidos, reembolsos o movimientos de caja. Cada equipo toma una decisión razonable desde su perspectiva local, pero la imagen compartida está desactualizada.
El coste no es solo una mala decisión. Es el tener que rehacer el trabajo.
Los equipos pierden tiempo conciliando sistemas, volviendo a ejecutar análisis y explicando por qué hubo que revertir acciones basadas en datos "actuales". Una vez que esto sucede un par de veces, la confianza cae rápidamente. Los usuarios de negocio dejan de tratar los paneles como sistemas de acción y empiezan a tratarlos como una guía aproximada. Los analistas se ven arrastrados a validaciones manuales, vuelven las hojas de cálculo paralelas y los ciclos de decisión se ralentizan.
El efecto varía según el sector. En el comercio minorista y el marketing, los datos obsoletos de segmentación o inventario provocan campañas mal dirigidas, promociones deficientes y problemas de stock evitables. En el sector sanitario, un contexto clínico u operativo obsoleto puede llevar al personal a una priorización insegura. En finanzas, los motores de reglas y las automatizaciones downstream siguen avanzando a menos que alguien los detenga explícitamente, por lo que las entradas antiguas pueden activar una retención, aprobación o escalada equivocada.
Aquí es también donde importa la distinción entre datos obsoletos, podridos y oscuros. Los datos obsoletos pueden seguir siendo estructuralmente válidos y relevantes, pero son demasiado antiguos para la decisión. Los datos podridos son datos de baja calidad que son incorrectos, están corrompidos, duplicados o incompletos. Los datos oscuros son datos que la organización almacena pero no utiliza ni gobierna activamente. Esas categorías necesitan respuestas diferentes. Los datos obsoletos necesitan controles de frescura y SLA. Los datos podridos necesitan una remediación de calidad. Los datos oscuros necesitan decisiones de inventario, propiedad y retención. Si un equipo trata los tres como el mismo problema, normalmente elige la solución equivocada y mantiene el riesgo empresarial en su lugar.
Una forma útil de enmarcar el problema es la Timeliness de los datos. La antigüedad aceptable de un conjunto de datos depende de la decisión que respalda, no de si la canalización finalizó con éxito. Esta guía práctica sobre la Timeliness de los datos en los sistemas operativos es una buena referencia si su equipo necesita definir esos umbrales con mayor claridad.
Vale la pena ver una breve explicación si desea un marco visual sencillo antes de crear los controles:
Por qué la IA eleva las apuestas
IBM señala que los SLA de frescura son particularmente importantes en los sistemas de decisión automatizados y en los entornos de datos en tiempo real donde incluso un ligero retraso puede degradar los resultados, y también destaca que los sistemas de IA de agentes crean nuevos modos de fallo porque pueden desencadenar acciones automatizadas basadas en datos obsoletos, lo que significa que los SLA deben vincularse a la latencia de la acción, no solo a la antigüedad de los datos (IBM sobre datos obsoletos y SLA de frescura).
En la práctica, los sistemas de IA son menos tolerantes que los flujos de trabajo humanos. El usuario de un panel de control puede notar que las cifras de ayer parecen incorrectas y hacer preguntas antes de actuar. Un servicio de recomendación, un consumidor de almacén de características o un flujo de trabajo de agentes no suele detenerse para realizar esa comprobación. Consume lo que está disponible y procede como si el contexto estuviera actualizado.
Eso cambia el modo de fallo de una mala percepción a una mala acción. Un modelo de precios puede utilizar señales de demanda caducadas. Un flujo de trabajo de fraude puede calificar una transacción frente al estado de una cuenta antigua. Un copiloto de atención al cliente puede generar asesoramiento a partir de telemetría de productos o suscripciones obsoleta. El sistema parece sano porque las solicitudes se realizan correctamente, pero la calidad de los resultados cae de formas que son costosas y difíciles de rastrear.
La política de frescura debe coincidir con la consecuencia comercial. Un conjunto de datos de planificación semanal puede tolerar más antigüedad que una tabla de características utilizada para decisiones en tiempo real. Tratarlos de la misma manera es la forma en que los datos obsoletos pasan de ser una molestia en los informes a un riesgo operativo.
Cómo detectar y supervisar los datos obsoletos
La detección comienza con una idea básica. Necesita saber qué antigüedad tienen los datos en este momento, no cuándo se creyó por última vez que la canalización estaba sana.
DQOps describe claramente el método de detección principal: supervisar la frescura calculando el tiempo transcurrido desde la última actualización, normalmente utilizando una columna de fecha o marca de tiempo, y mostrar esas métricas de frescura en paneles de control para que los equipos puedan ver qué tablas tienen los datos más antiguos (DQOps sobre la detección de datos obsoletos con marcas de tiempo y paneles de control).
Comience con comprobaciones de frescura
Si está creando esto desde cero, comience con una lista corta de conjuntos de datos críticos y hágase una pregunta sencilla para cada uno: ¿qué marca de tiempo representa mejor la última actualización confiable?
Para algunas tablas es una marca de tiempo de ingesta. Para otras es una marca de tiempo de evento o una fecha de vigencia comercial. Elija el campo que refleje la actualidad real para el caso de uso, no solo la mecánica de carga.
A continuación, implemente algunas comprobaciones concretas:
Realice un seguimiento de la antigüedad máxima de la marca de tiempo. Compare la hora del último registro con la hora actual.
Separe la frescura del origen de la frescura del almacén de datos. Una carga exitosa no significa que los datos ascendentes estuvieran actualizados.
Visualice primero las tablas más antiguas. Los equipos necesitan una vista única que haga evidentes los conjuntos de datos descuidados.
Si está pensando en la frescura como parte de una práctica de fiabilidad más amplia, esta página sobre la supervisión de la Timeliness de los datos muestra cómo los equipos estructuran operacionalmente la Timeliness.
Añada una supervisión que refleje las operaciones reales
Las comprobaciones de marca de tiempo detectan paradas obvias. Una buena supervisión va más allá y refleja cómo se comporta normalmente la canalización.
Una configuración práctica suele incluir:
Ventanas de llegada esperadas
Si una tabla se suele actualizar según una programación, supervise si la actualización llegó dentro de su ventana normal. Esto detecta trabajos retrasados pero que aún no han fallado por completo.Comprobaciones de volumen y patrón
Una tabla puede seguir actualizándose pero con un volumen sospechosamente bajo, particiones parciales o fragmentos faltantes. Eso a menudo indica el inicio de un problema de frescura.Conciencia de los cambios de esquema
Los cambios de columna ascendentes, los campos renombrados o los cambios de tipo a menudo rompen la lógica de actualización antes de que nadie note que aumenta la antigüedad de los datos derivados.Alertas con detección de impacto
El enrutamiento de alertas debe reflejar quién es el propietario del problema y qué consumidores downstream se ven afectados. Una alerta de frescura sin una ruta de propiedad definida solo genera ruido.
No supervise la frescura únicamente como una propiedad de las tablas. Supervise la frescura como una propiedad de las decisiones que dependen de esas tablas.
Ese enfoque cambia el significado de lo que es "suficientemente bueno". Una tabla de dimensiones utilizada para informes de lento movimiento puede tolerar un umbral flexible. Una tabla de características que alimenta acciones automatizadas probablemente no pueda hacerlo.
Prevención de datos obsoletos con la Observability moderna
Un incidente de datos obsoletos suele comenzar mucho antes de que alguien lo llame incidente. El panel de control sigue cargándose. La canalización sigue mostrándose en verde. El modelo sigue puntuando. Pero un flujo ascendente se detuvo hace seis horas, un trabajo de replicación se está retrasando o un cambio de esquema provocó que fallara parte de la actualización. Para cuando un usuario de negocio se da cuenta, el equipo ya está trabajando con datos que parecen válidos pero no lo están.
Prevención significa diseñar para esos modos de fallo en lugar de tratar la frescura como una comprobación puntual y aislada.
Cómo es la prevención en la práctica
Los mejores controles son operativos. Definen quién responde, qué significa "suficientemente fresco" y cómo detecta el equipo los problemas antes de que los datos obsoletos lleguen a un punto de decisión.
Asigne una propiedad explícita. Cada conjunto de datos crítico para el negocio necesita un propietario asignado para la frescura. Sin eso, los datos obsoletos se quedan en la brecha entre los equipos de plataforma, análisis y aplicaciones.
Establezca los requisitos de frescura por decisión, no por tabla. Una instantánea financiera utilizada para el cierre mensual tiene una tolerancia diferente a la de una tabla de características que alimenta recomendaciones automatizadas. Aquí es también donde importa la distinción entre datos obsoletos, podridos y oscuros. Los datos obsoletos pueden seguir siendo utilizables para algunos informes de bajo riesgo. Los datos podridos son incorrectos o están dañados y necesitan una respuesta diferente. Los datos oscuros pueden estar sin usar y deben ser gobernados o retirados en lugar de actualizados.
Utilice marcas de tiempo y control de versiones. Cada carga debe dejar evidencia de cuándo se ejecutó, qué instantánea de origen utilizó y si las tablas descendentes se reconstruyeron a partir de las entradas correctas. Eso hace que la reversión, la revisión de incidentes y el análisis de la causa raíz sean mucho más rápidos.
Reduzca la verificación manual. Las comprobaciones puntuales ayudan durante la depuración, pero no son escalables en docenas de canalizaciones, almacenes replicados y entradas de modelos.
Los equipos también deben elegir dónde dedicar sus esfuerzos. Transmitir en tiempo real cada fuente de datos no siempre está justificado. Las actualizaciones más frecuentes aumentan el coste de la infraestructura, la carga en los sistemas de origen y el volumen de alertas. El objetivo correcto es la configuración más económica que mantenga los datos dentro de la tolerancia del proceso de negocio que respaldan.
En qué ayudan las plataformas de Observability
La Observability funciona mejor cuando sigue todo el camino desde el origen hasta el consumidor. Un programador de trabajos puede decirle que una tarea se ha completado. No puede decirle si los datos de origen ya eran obsoletos, si solo llegó una parte de una partición o si una tabla de características downstream está ahora fuera de su nivel de servicio.
Una útil guía de Data Observability para la gestión de datos moderna explica por qué los equipos necesitan visibilidad a nivel de canalización en lugar de comprobaciones aisladas. En la práctica, eso significa supervisar en un solo lugar las ventanas de llegada esperadas, las anomalías en el recuento de filas y particiones, los cambios de esquema, el linaje y las dependencias downstream.
Eso importa aún más para los sistemas de IA y ML. Un panel de informes con datos obsoletos puede dar lugar a una mala reunión. Un modelo entrenado o puntuado con características obsoletas puede seguir tomando malas decisiones hasta que alguien intervenga. La solución rara vez es "actualizar todo más rápido". Consiste en establecer expectativas de frescura para cada conjunto de características, vigilar los cambios ascendentes que rompan esas expectativas y detener las acciones automatizadas cuando los datos estén fuera de la tolerancia.
Para los equipos que evalúan plataformas, digna es un ejemplo que combina la supervisión de la Timeliness, la detección de anomalías, la validación a nivel de registro y el seguimiento de esquemas mientras ejecuta análisis dentro del entorno del cliente. Esa combinación es útil porque los problemas de datos obsoletos a menudo aparecen junto con otras señales, como una carga retrasada, un cambio de tipo y una caída inesperada del volumen debido al mismo problema ascendente.
La misma disciplina se aplica fuera de la analítica interna. En los entornos de comercio, los datos de productos, inventario y clientes a menudo se mueven a través de aplicaciones, cachés y exportaciones antes de que alguien los use. Estas perspectivas sobre la precisión de los datos de comercio electrónico son un buen recordatorio de que la prevención depende de mantener los datos operativos lo suficientemente actualizados para la acción que impulsan, no solo de mantener las canalizaciones en verde.
Los umbrales de frescura universales fallan porque los procesos de negocio no comparten la misma tolerancia al retraso. La prevención eficaz proviene de una Observability vinculada al uso, una propiedad vinculada a la respuesta y controles que distingan los datos obsoletos de los otros problemas de calidad de datos que necesitan un remedio diferente.
Construir una confianza duradera en sus datos
El verdadero significado de los datos obsoletos no es "datos antiguos". Son datos que se han vuelto inadecuados para una decisión específica mientras siguen pareciendo utilizables. Por eso causan más daños que muchos fallos evidentes.
Los equipos que gestionan esto bien hacen tres cosas de forma constante. Distinguen los datos obsoletos de los datos podridos y oscuros. Supervisan la frescura como un requisito operativo, no como una auditoría ocasional. Y vinculan la remediación al impacto empresarial, especialmente donde los modelos y los flujos de trabajo automatizados actúan más rápido de lo que los humanos pueden inspeccionar.
Esa disciplina también importa fuera de la analítica. Si trabaja con registros de comercio o de clientes, estas perspectivas sobre la precisión de los datos de comercio electrónico ofrecen una perspectiva útil de por qué la información limpia y actualizada afecta tanto a la ejecución diaria como a los informes ejecutivos.
La confianza en los datos no se crea con un panel de control o con una ejecución exitosa de una canalización. Proviene de pruebas repetibles de que los datos están lo suficientemente actualizados, son lo suficientemente precisos y están lo suficientemente bien gobernados para la acción que impulsan.
Si los informes obsoletos, las cargas retrasadas o los cambios silenciosos de esquema siguen obligando a su equipo a apagar fuegos de forma reactiva, vale la pena evaluar digna. Se centra en la Timeliness, las anomalías, la validación y el seguimiento de esquemas para que los equipos de datos puedan detectar problemas de frescura antes de que lleguen a los paneles de control, los modelos y las decisiones operativas.
Preguntas frecuentes
¿Qué significan los datos obsoletos?
Los datos obsoletos siguen siendo técnicamente válidos pero son demasiado antiguos para la tarea que les pide. Ya no reflejan la realidad actual porque la ingesta se detuvo, se ralentizó o se retrasó, aunque cada valor superaría una comprobación de formato o rango.
¿Por qué cuesta detectarlos?
Porque nada parece roto. Las filas están bien formadas, el esquema intacto y el informe se dibuja con normalidad. Sin una expectativa explícita de frescura, una tabla que sirve las cifras de ayer es indistinguible de una que sirve las de hoy.
¿Qué diferencia hay entre obsolescencia, latencia y deriva?
La latencia es el retardo normal y esperado entre el evento y su disponibilidad. La obsolescencia es latencia que ha superado lo que tolera el caso de uso. La deriva es un cambio en el carácter estadístico de los datos, que puede ocurrir incluso con datos perfectamente frescos.
¿Cómo se detectan los datos obsoletos?
Empiece con comprobaciones de frescura que contrasten la marca de tiempo más reciente con un umbral derivado de las necesidades del consumidor. Añada monitorización del patrón real de llegada: un feed horario que pasa a diario está obsoleto mucho antes de saltar un umbral absoluto.
¿Por qué importan más en IA?
Porque los modelos actúan sobre las entradas de forma automática y a gran volumen, sin que nadie note que una cifra parece antigua. Una variable obsoleta degrada en silencio las predicciones en cada decisión que toca el modelo, y el daño se acumula antes de que alguien concilie un informe.



