Qué es un esquema en una base de datos: guía completa para 2026
|
8
minuto de lectura

Probablemente no esté buscando qué es un esquema por curiosidad sobre la teoría de bases de datos. Lo busca porque algo aguas abajo parece frágil. Un dashboard dejó de funcionar tras una release rutinaria. Un pipeline empezó a fallar en una tabla que «no había cambiado». Un modelo siguió puntuando, pero los resultados ya no tenían sentido.
Esa es la razón práctica para prestar atención a los esquemas. A menudo, los valores de los datos acaparan la atención, mientras la estructura que los rodea cambia sin que nadie lo observe en segundo plano. Ahí empiezan muchos fallos costosos.
Si quiere primero la respuesta de manual, aquí la tiene: un esquema de base de datos es el plano estructural que define cómo se organizan los datos, incluidas tablas, columnas, tipos de datos, restricciones y relaciones como las claves foráneas, según describe la definición de Oracle de la estructura de un esquema de base de datos. Pero esa definición es solo el punto de partida. En los sistemas reales, el esquema también es un contrato. Cuando ese contrato cambia sin control, los pipelines, los dashboards y los sistemas de ML suelen ser los primeros en absorber el daño.
Índice
El fallo silencioso detrás de un dashboard roto
Un fallo habitual empieza con una mañana perfectamente normal. Un desarrollador de BI abre un dashboard de ingresos y ve huecos donde ayer había tendencias. Un ingeniero de datos revisa la capa de orquestación y descubre que una transformación aguas abajo ha fallado. El sistema de origen está operativo. La capacidad de cómputo está bien. Nada parece sobrecargado.
La causa raíz resulta ser más pequeña de lo que nadie esperaba. Un equipo aguas arriba renombró una columna, eliminó un campo o cambió un tipo de valores de tipo entero a cadenas de texto. Nadie lo anunció. Ninguna migración llegó al equipo de analítica. El pipeline no estaba sobrecargado ni mal ajustado. Esperaba una estructura y recibió otra.
Por eso las explicaciones introductorias sobre los esquemas a menudo parecen incompletas. Describen un esquema como estructura, lo cual es cierto, pero no llegan a la consecuencia operativa. Análisis recientes del sector indican que entre el 60 y el 70 por ciento de los fallos de los pipelines de datos se deben a cambios de esquema inesperados y no a problemas de volumen de datos, un punto destacado en el análisis de Cockroach Labs sobre el riesgo de los esquemas.
Por qué estos fallos son difíciles de diagnosticar
Los incidentes relacionados con el esquema son complicados porque no siempre fallan de forma ruidosa. A veces el job se bloquea al analizar los datos. A veces una transformación omite un campo sin que nadie lo note. A veces el dashboard sigue cargando, pero una métrica ahora es incorrecta porque un join ya no coincide o una conversión de tipo empezó a devolver nulos.
La mayoría de los equipos monitorizan el número de filas y la frescura antes que la estructura. Es al revés de lo que debería ser, ya que la estructura es aquello de lo que dependen todas las suposiciones aguas abajo.
Un dashboard roto suele ser solo el síntoma visible. El problema de fondo está un nivel más abajo, en el contrato que define cómo deberían ser los datos.
La verdadera lección
Si solo monitoriza valores, se le escapará una gran categoría de fallos. Los esquemas merecen la misma atención operativa que el código, los jobs y la infraestructura. Para los equipos de datos modernos, «qué es un esquema en una base de datos» no es una pregunta académica. Es una cuestión de fiabilidad.
El plano de su base de datos
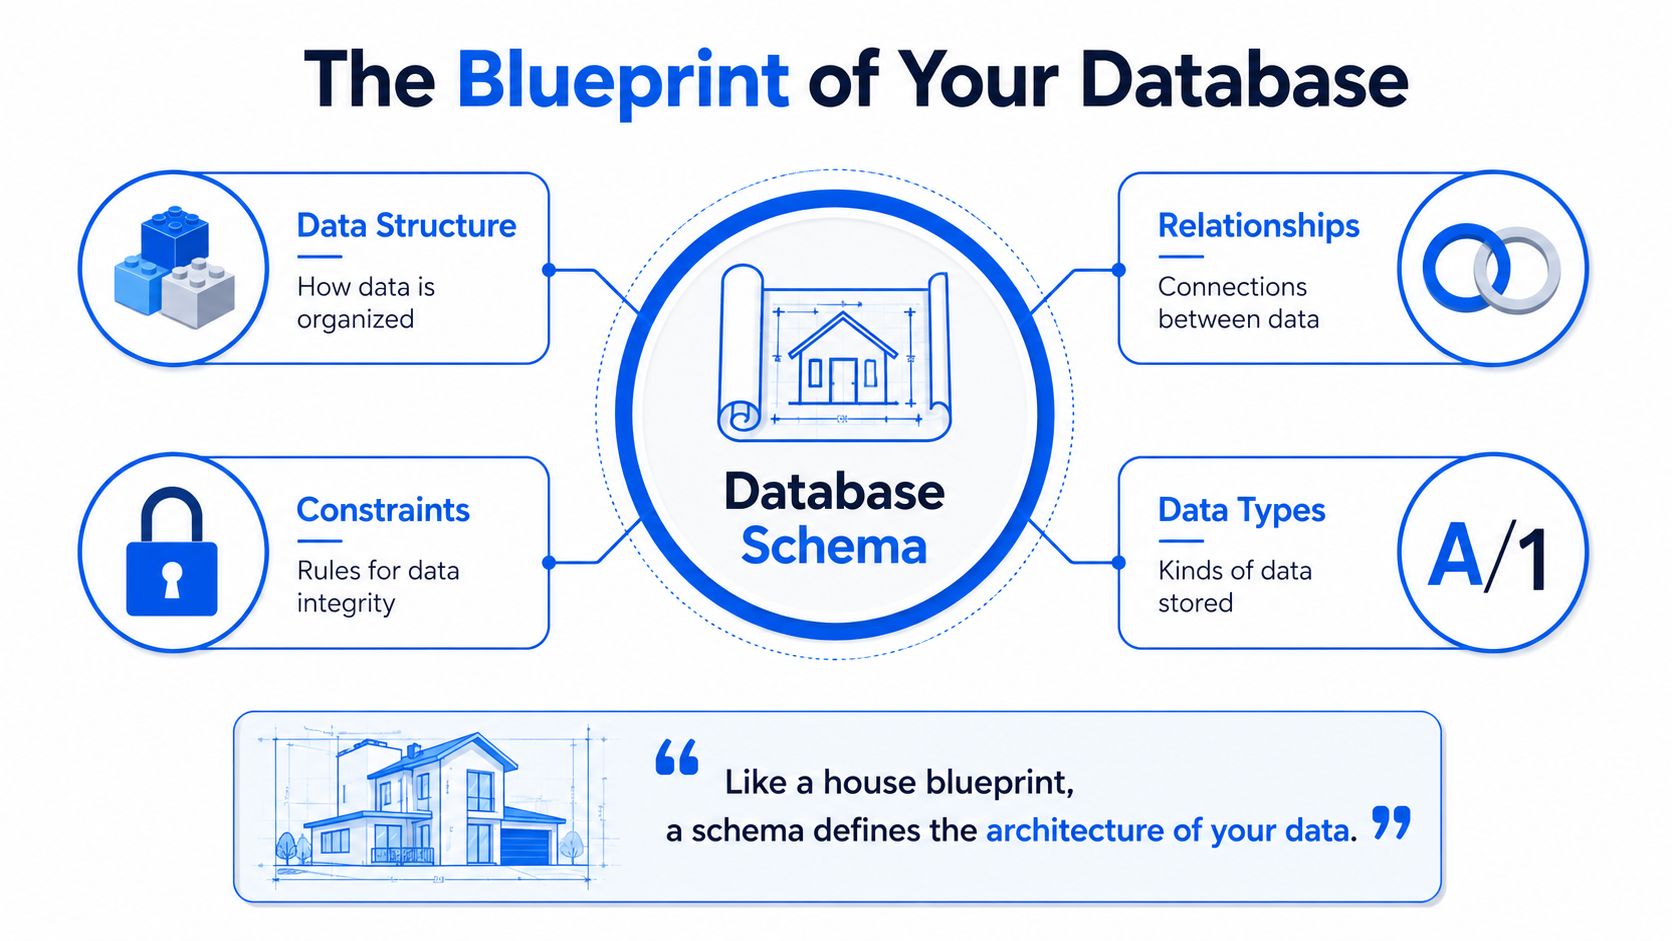
La forma más sencilla de entender un esquema es pensar en él como el plano de un edificio. El plano no contiene los muebles ni las personas que hay dentro de la casa. Define las habitaciones, las puertas, los muros de carga y las reglas que debe seguir la construcción.
En una base de datos relacional, la versión formal es más estricta. En los sistemas de gestión de bases de datos relacionales, un esquema se define formalmente como un conjunto de restricciones de integridad, fórmulas lógicas que impiden insertar datos que violen las reglas estructurales, y actúa como un plano sin datos de tablas, campos, tipos de datos y relaciones, como explica la introducción de IBM al esquema de base de datos.
Qué incluye realmente el plano
Un esquema práctico suele definir varios elementos principales:
Las tablas representan las entidades principales que se almacenan, como
customers,ordersopayments.Las columnas definen los atributos de cada tabla, como
customer_id,emailocreated_at.Los tipos de datos especifican qué tipo de valor puede contener cada columna, como entero, texto o marca de tiempo.
Las restricciones imponen reglas como
PRIMARY KEY,NOT NULLo la unicidad.Las relaciones conectan tablas mediante claves, normalmente con referencias de clave foránea.
Si se traslada esto a la analogía del plano, las tablas son habitaciones, las columnas son instalaciones, los tipos de datos son especificaciones de materiales y las restricciones son requisitos normativos que impiden una mala construcción.
Por qué importan las restricciones en producción
La expresión «conjunto de restricciones de integridad» suena abstracta hasta que se ha vivido la experiencia de los datos erróneos. Las restricciones detienen algunos tipos de fallo antes de que entren en la base de datos. Una clave primaria impide identidades duplicadas. Una clave foránea evita registros huérfanos. Una restricción de tipo impide que una columna de marca de tiempo acepte texto libre.
Esto importa porque prevenir es más barato que limpiar. Cuando la base de datos aplica las reglas estructurales en el momento de la escritura, los jobs aguas abajo no tienen que adivinar si las suposiciones fundamentales siguen siendo válidas.
Elemento del esquema | Qué hace | Fallo típico si no se gestiona |
|---|---|---|
Definición de tabla | Organiza los datos de las entidades | Conceptos de dominio ausentes o duplicados |
Definición de columna | Describe cada atributo | Transformaciones rotas cuando cambian los nombres |
Tipo de datos | Controla el formato de valor permitido | Errores de conversión, aumento de nulos, agregaciones incorrectas |
Restricción | Impone la integridad | Duplicados, referencias no válidas, registros incoherentes |
Relación | Conecta entidades entre tablas | Joins incorrectos e informes engañosos |
Regla práctica: si un campo es lo bastante importante como para usarlo en un join, en un filtro o como entrada de un modelo, su definición de esquema debe tratarse como parte de su contrato de producción.
Qué funciona y qué no
Lo que funciona es una estructura explícita. Una titularidad clara de las tablas. Cambios de DDL revisados. Restricciones que reflejen la realidad del negocio.
Lo que no funciona es tratar el esquema como documentación que se crea una vez y se olvida. El plano solo le protege si los equipos lo mantienen alineado con el edificio que están modificando.
Esquemas conceptuales, lógicos y físicos
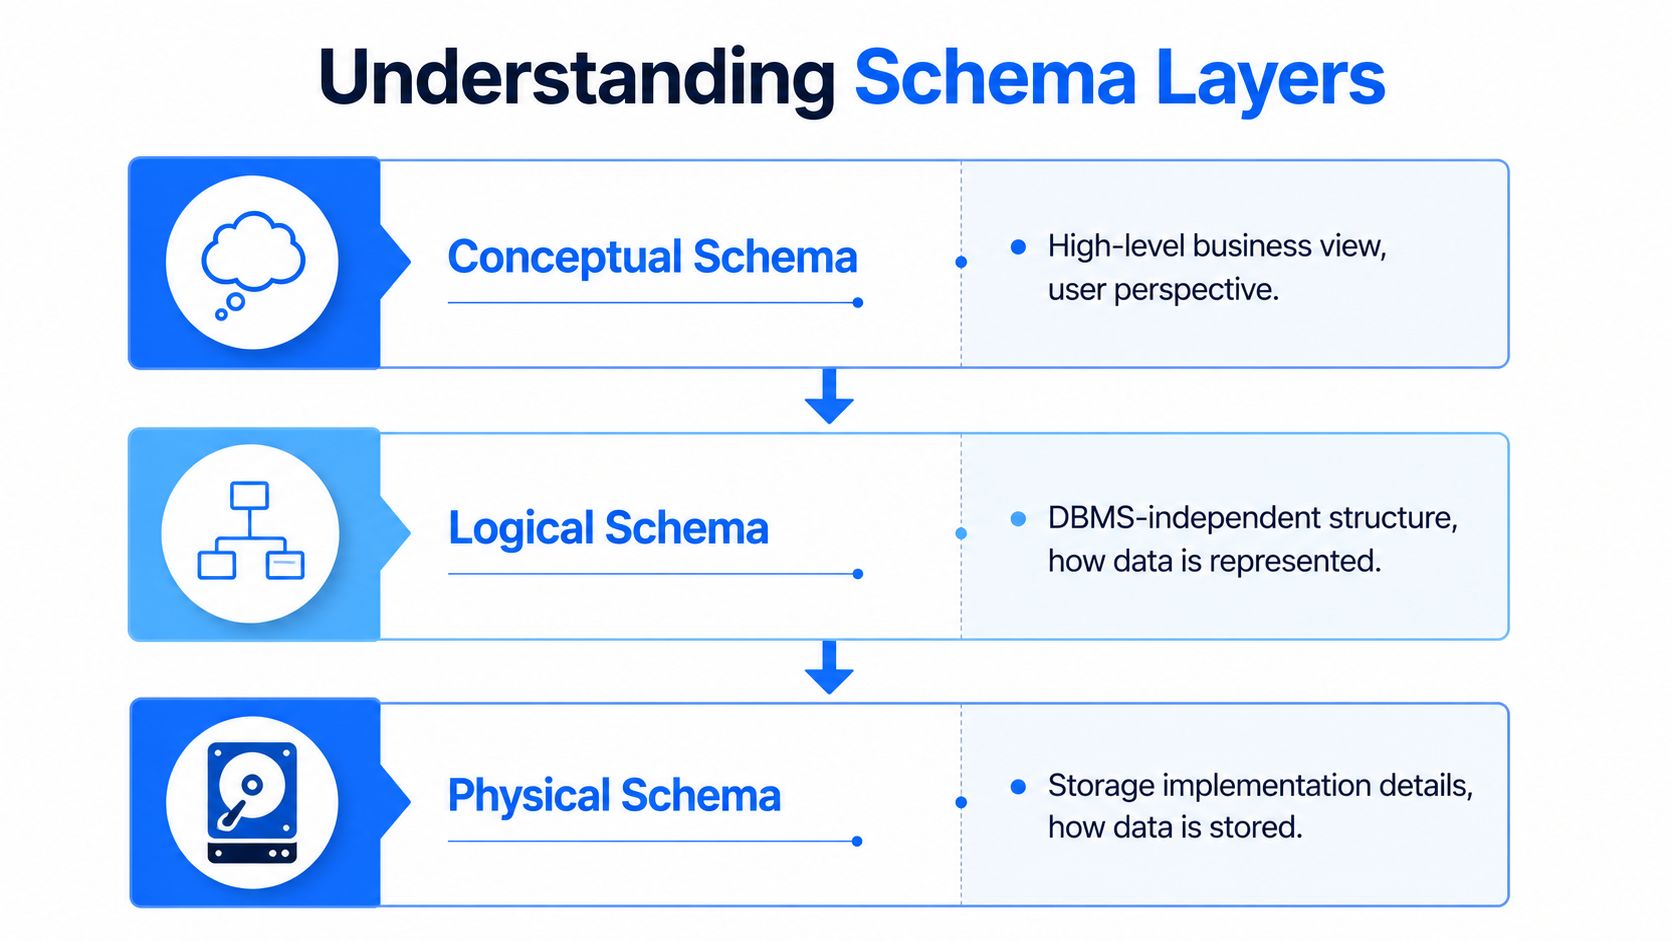
Un esquema de base de datos suele enseñarse como una definición de cómo se organizan los datos. En la práctica, esa definición existe en varios niveles, y cada nivel afecta a un tipo de decisión distinto. Si un equipo los mezcla, los cambios de esquema se vuelven más difíciles de revisar, la titularidad se difumina y el riesgo en producción aumenta.
La visión estándar de tres capas procede de la arquitectura ANSI/SPARC: conceptual, lógica y física. La introducción de IBM a la arquitectura de tres esquemas es un ejemplo de ese modelo en la práctica.
Un ejemplo de e-commerce en tres capas
Tomemos un sistema de comercio como ejemplo concreto.
En el nivel conceptual, el negocio define los objetos principales: clientes, productos, pedidos y pagos. Esta capa recoge el significado y las reglas del dominio de negocio. Responde a preguntas como qué es un pedido, quién es un cliente y si un reembolso pertenece a los pagos o a los pedidos.
En el nivel lógico, esa visión de negocio se convierte en un modelo de datos. Los ingenieros definen entidades, atributos, claves y relaciones, como customers con orders, orders con order_items y payments con orders. El foco está en la estructura y la coherencia, no en los detalles de almacenamiento.
En el nivel físico, el diseño se vuelve ejecutable en un motor de base de datos concreto. Aquí aparecen los tipos de datos, los índices, el clustering, el particionamiento, la disposición de archivos y las opciones específicas del motor. Aquí es donde el rendimiento, el coste de almacenamiento y el comportamiento operativo empiezan a divergir entre sistemas que parecen similares en una pizarra.
Por qué importan las distinciones en producción
Cada capa falla de forma distinta.
Un error conceptual le da un objeto de negocio equivocado. Un error lógico produce joins rotos, entidades duplicadas o modelos que los analistas sortean con SQL personalizado. Un error físico ralentiza las consultas, infla el almacenamiento y convierte cambios de esquema rutinarios en migraciones arriesgadas.
Esa separación también ayuda durante la respuesta a incidentes. Si un dashboard se rompe porque customer_tier se trasladó de una tabla a otra, el problema es lógico. Si el dashboard sigue funcionando, pero el tiempo de consulta se dispara tras un cambio de particionamiento, el problema es físico. Si dos equipos discrepan sobre si los usuarios de prueba cuentan como clientes, el problema es conceptual. Identificar la capa correcta acorta la corrección.
El esquema como espacio de nombres
Los sistemas relacionales también usan la palabra esquema en un segundo sentido: un espacio de nombres de objetos como finance, sales o analytics. En plataformas como SQL Server y PostgreSQL, ese espacio de nombres agrupa tablas, vistas y otros objetos bajo un límite con nombre y sus propias reglas de acceso.
Esto importa a nivel operativo. El diseño de los espacios de nombres afecta a la gestión de permisos, al aislamiento de los despliegues y a la titularidad de los objetos. Un equipo podría almacenar tablas sanitarias restringidas en un esquema y publicar vistas de informes depuradas en otro. Bien hecho, esto reduce la exposición accidental y facilita hacer cumplir la titularidad.
El problema es que los ingenieros suelen usar la misma palabra para ambos conceptos. A veces «cambio de esquema» significa que cambió el tipo de una columna. A veces significa que un objeto se movió de staging a analytics. Son eventos distintos con radios de impacto distintos. Tratarlos como lo mismo es la forma en que las revisiones pasan por alto el impacto aguas abajo y en que la deriva del esquema acaba convirtiéndose en pipelines rotos.
Schema-on-write frente a schema-on-read
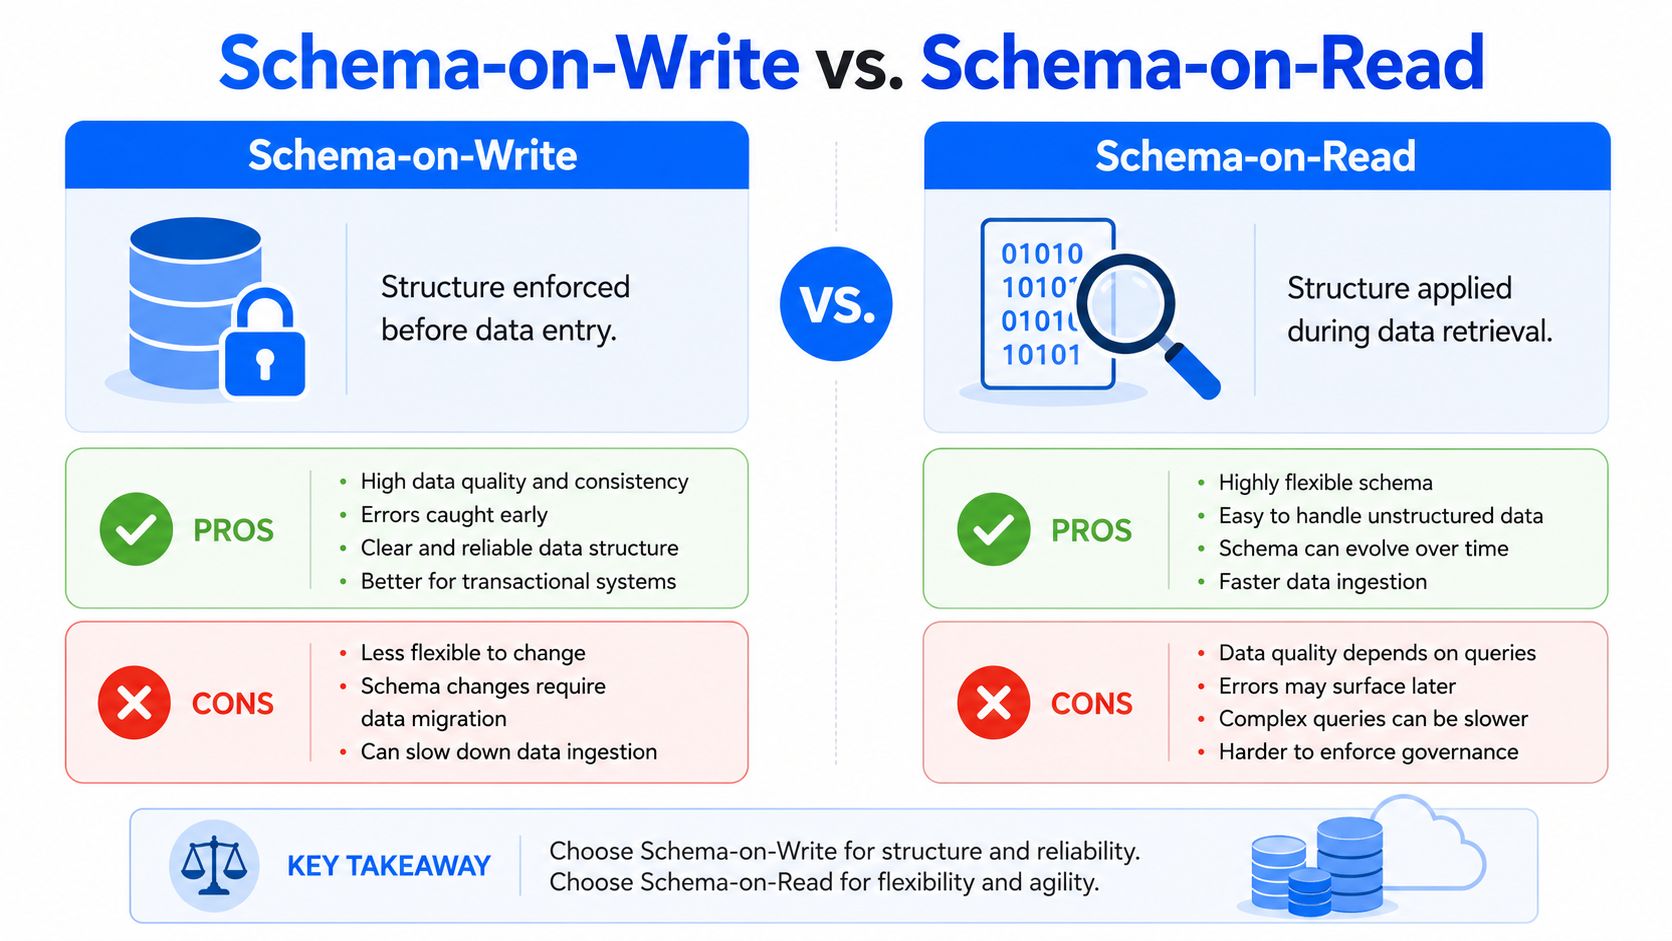
No todos los sistemas aplican la estructura en la misma fase. Ahí es donde muchas discusiones sobre «qué es un esquema en una base de datos» se vuelven más actuales. La respuesta cambia según el momento en que se hace cumplir el contrato.
Schema-on-write
Los sistemas relacionales tradicionales suelen seguir el enfoque schema-on-write. Los datos deben ajustarse a la estructura esperada antes de que la base de datos los acepte. Si la tabla espera una marca de tiempo y recibe texto mal formado, la escritura debe fallar o rechazarse mediante una transformación controlada.
Esa rigidez es útil en los sistemas transaccionales. Los pagos, los pedidos, los saldos de cuentas y los registros de identidad se benefician de una estructura estricta porque los consumidores necesitan coherencia más que flexibilidad.
Ventajas
Alta integridad en la ingesta: los registros no válidos se bloquean pronto.
Uso más limpio aguas abajo: los analistas y las aplicaciones trabajan con estructuras predecibles.
Contratos claros: productores y consumidores saben qué forma se espera.
Inconvenientes
Adaptación más lenta: cambiar el modelo suele requerir planificar una migración.
Más coordinación: los equipos aguas arriba y aguas abajo deben alinearse antes de la release.
Menos tolerante con la ingesta en bruto: las entradas semiestructuradas necesitan preprocesamiento.
Schema-on-read
Los data lakes y las zonas de aterrizaje de datos en bruto suelen usar schema-on-read. Los equipos primero ingieren y aplican la estructura después, al consultar o transformar los datos. Esto funciona bien cuando las entradas son diversas, semiestructuradas o evolucionan con rapidez.
La flexibilidad es real. También lo es el riesgo operativo. Si cada consumidor infiere la estructura de forma distinta, el mismo conjunto de datos en bruto puede dar lugar a múltiples interpretaciones.
Enfoque | Mejor encaje | Principal fortaleza | Principal riesgo |
|---|---|---|---|
Schema-on-write | Sistemas transaccionales, almacenes de datos depurados | Coherencia antes del almacenamiento | Rigidez ante los cambios |
Schema-on-read | Data lakes en bruto, analítica exploratoria, ingesta variada | Flexibilidad en la ingesta | Interpretación incoherente aguas abajo |
Qué funciona en la práctica
El error no es elegir uno u otro. El error es suponer que la gestión del esquema desaparece con schema-on-read. No desaparece. Siguen siendo necesarios los contratos, la catalogación, la validación y la monitorización de cambios. De lo contrario, el lake se convierte en un lugar donde los consumidores redescubren una y otra vez las mismas sorpresas estructurales.
Un patrón práctico es aceptar flexibilidad en la ingesta y, después, imponer una estructura más sólida a medida que los datos pasan a capas depuradas. Así los equipos tienen margen para ingerir rápido sin que la analítica y los modelos aguas abajo funcionen a base de conjeturas.
Cuando los planos cambian: evolución y deriva del esquema
Ningún esquema de producción permanece congelado. Los productos añaden funcionalidades. Las API cambian. Las aplicaciones de origen versionan sus payloads. Las normativas obligan a añadir campos nuevos. Los equipos dividen una tabla en tres o consolidan diez en una. El cambio en sí no es el problema.
El problema es si el cambio es deliberado y visible.
Evolución del esquema frente a deriva del esquema
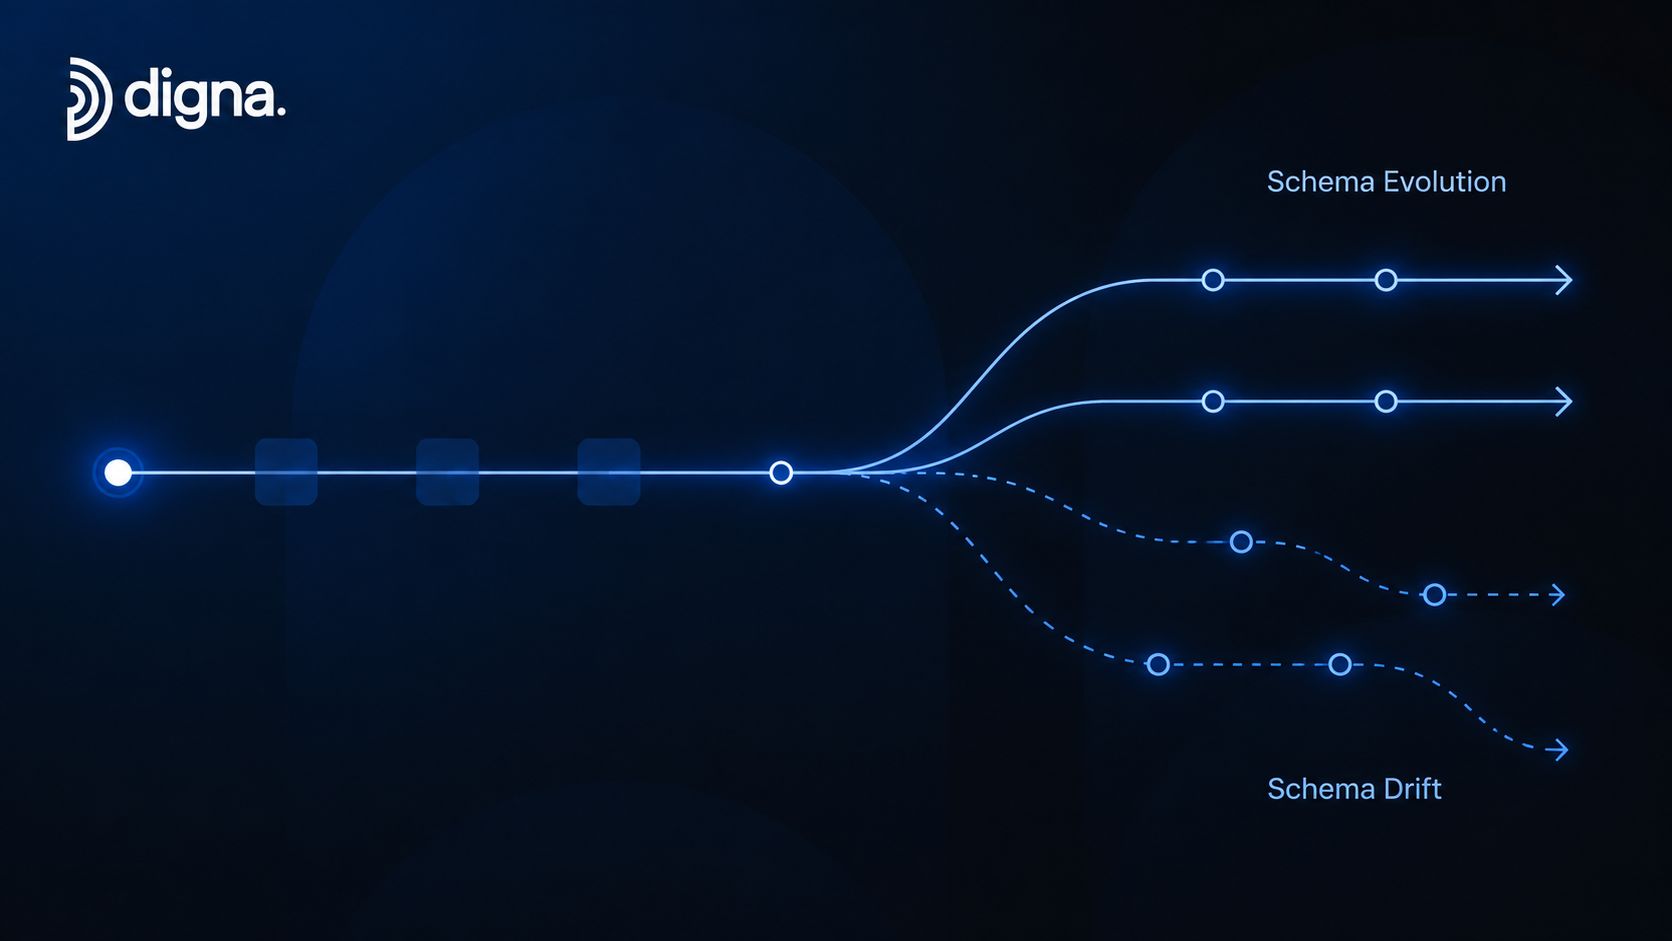
La evolución del esquema es un cambio planificado. Un equipo introduce una nueva columna que admite nulos, publica la migración, actualiza el contrato y coordina a los consumidores. Puede que aún quede trabajo por hacer, pero al menos el cambio es intencionado.
La deriva del esquema es lo que ocurre cuando se añaden, eliminan o modifican columnas sin los controles de migración adecuados. Según esta explicación de la deriva del esquema y de las roturas aguas abajo, esos cambios pueden romper de forma inesperada las aplicaciones aguas abajo.
Si quiere un análisis más profundo de este modo de fallo, esta guía sobre cómo los cambios estructurales rompen los pipelines de datos resulta útil porque plantea la deriva como un problema de fiabilidad operativa, no solo de modelado.
Cinco causas habituales en sistemas reales
Estas son las causas que veo con más frecuencia:
Desarrollo de funcionalidades en aplicaciones de origen
Los equipos de producto añaden campos para dar soporte a nuevos flujos de trabajo, pero los consumidores de analítica nunca se enteran de la release.Cambios de tipo durante refactorizaciones de servicios
Un servicio empieza a emitir los ID como cadenas en lugar de valores numéricos, o un campo de fecha cambia de formato.Revisiones de API de terceros
Los proveedores añaden atributos anidados, declaran obsoletos algunos campos o renombran claves del payload.Cambios manuales en la base de datos sin revisar
Alguien ejecuta DDL directamente en producción o en un entorno compartido sin una ruta de migración.Deriva de entorno entre etapas
Desarrollo, staging y producción dejan de coincidir, por lo que el comportamiento del pipeline cambia tras el despliegue.
Cómo es una evolución saludable
Una buena evolución deja rastro documental. El DDL está versionado. Los consumidores saben qué cambió. Existen ventanas de compatibilidad para las tablas de alto impacto. Las comprobaciones de validación se ejecutan después del despliegue.
Un cambio de esquema planificado es ingeniería normal. Un cambio de esquema sin seguimiento es combustible para incidentes.
Esa distinción importa porque ambos eventos pueden parecer idénticos a nivel de tabla. La diferencia está en la gobernanza, la visibilidad y si alguien aguas abajo tuvo la oportunidad de prepararse.
El alto coste de los cambios de esquema silenciosos
Un cambio de esquema se vuelve caro en el momento en que los sistemas aguas abajo dan por hecho que la estructura antigua sigue vigente. La definición de manual de un esquema es sencilla. Define tablas, columnas, tipos y relaciones. En producción, también determina si su dashboard es fiable, si su pipeline de features sigue coincidiendo con las suposiciones del entrenamiento y si los ingenieros pasan la tarde entregando trabajo o depurando las consecuencias.

Escenario uno: el pipeline falla rápido
Este es el modo de fallo visible. Se elimina o renombra una columna de origen. Una transformación hace referencia al campo antiguo. El job falla, saltan las alertas y el ingeniero de guardia tiene un error concreto que rastrear.
Ese tipo de rotura es costoso, pero al menos está acotado. El equipo compara versiones, corrige la transformación, vuelve a ejecutar el job y explica el retraso a los usuarios aguas abajo. Se pierde tiempo de ingeniería y frescura de los datos, pero normalmente no se pierde la confianza durante mucho tiempo, porque el fallo es evidente.
Escenario dos: el dashboard sigue funcionando, pero miente
Este es el incidente que los equipos subestiman.
Un cambio de tipo, una discrepancia de claves o un cambio en el comportamiento de los nulos pueden dejar el pipeline en verde mientras la métrica pasa a ser incorrecta. El join se sigue ejecutando, pero coinciden menos filas. La conversión de tipo se sigue ejecutando, pero los valores no válidos se convierten en nulos. Los ingresos acaban en la categoría equivocada, o un KPI cae por motivos que no tienen nada que ver con el negocio.
Cuando eso ocurre, el problema sale de la plataforma de datos y entra en la toma de decisiones. Los analistas empiezan a rastrear la lógica de los modelos, las tablas del almacén de datos y los feeds de origen. Los responsables cuestionan la cifra antes de que nadie cuestione el esquema. El coste ya no es solo de cómputo o de horas de ingeniería. Son decisiones más lentas, trabajo de validación repetido y menos confianza en cada informe construido sobre ese conjunto de datos.
Los problemas de esquema silenciosos son peligrosos porque el resultado sigue pareciendo utilizable.
Por eso la gestión del esquema forma parte del trabajo de fiabilidad, no solo de la documentación.
Escenario tres: el sistema de ML se degrada sin un error evidente
Los pipelines de ML son menos tolerantes que muchos flujos de reporting. Un modelo puede seguir puntuando mientras el conjunto de features se aleja de lo que esperaba el entrenamiento.
Un campo numérico llega como texto. Un valor categórico recibe una nueva codificación. Una columna dispersa empieza a rellenarse de otra manera tras una release de la aplicación. Ninguno de esos cambios necesita lanzar una excepción para causar daño. Pueden desplazar las distribuciones de las features, romper suposiciones integradas en el preprocesamiento y generar un desfase entre entrenamiento e inferencia que tarda días en diagnosticarse.
En la práctica, la deriva del esquema se convierte en un problema de operaciones de IA. Los equipos necesitan comprobaciones sobre la estructura de las features antes de considerar fiable el resultado del modelo. Un flujo de seguimiento de cambios de esquema para activos de datos en producción ayuda a detectar esos cambios antes de que lleguen a los jobs de scoring o de reentrenamiento aguas abajo.
Costes que se notan incluso sin un incidente declarado
Incluso cuando nadie abre un incidente, la factura llega igualmente:
Interrupciones en ingeniería: los ingenieros de datos y de analítica detienen el trabajo planificado para rastrear discrepancias estructurales entre sistemas.
Erosión de la confianza: los usuarios de negocio empiezan a pedir validaciones manuales antes de actuar sobre las cifras de los dashboards.
Fricción en las releases: cada cambio aguas arriba parece arriesgado porque el impacto aguas abajo es difícil de predecir.
Desperdicio de almacenamiento y de consultas: una disciplina de esquema débil suele llevar a campos duplicados, tipos incoherentes, tablas más anchas de lo necesario y patrones de procesamiento más caros.
Qué funciona frente a qué falla
Los equipos obtienen mejores resultados cuando tratan los cambios de esquema como cambios de producción con impacto en los consumidores. Revise el DDL. Compare la estructura actual con una línea base. Compruebe si los modelos, dashboards y pipelines de features compartidos siguen coincidiendo con el contrato con el que se construyeron.
Lo que falla es la coordinación informal. Un mensaje en el chat, una nota de la release que nadie lee o la suposición de que un pipeline en verde significa que los datos siguen siendo correctos. A nivel operativo, el esquema forma parte de la superficie contractual de la plataforma. Si no se monitoriza esa superficie, las roturas silenciosas se convierten en un centro de costes recurrente.
Buenas prácticas para la gestión y la monitorización de esquemas
La gestión manual de esquemas suele romperse en las fronteras entre equipos. Se fusiona un pull request en el repositorio de la aplicación, pero el equipo de analítica no sigue ese repositorio. Alguien actualiza un conector de terceros, pero el responsable del modelo nunca ve la nota de la release. La documentación existe, pero va por detrás de la realidad.
Un enfoque mejor es tratar el esquema como un activo de producción observable.
Cree un proceso de cambios que la gente realmente use
Un modelo de gobernanza pesado suena bien sobre el papel y a menudo se elude en la práctica. Mantenga el proceso lo bastante ligero como para que los ingenieros de producto lo sigan.
Aplique unas pocas reglas sencillas:
Versione los cambios de DDL: mantenga las definiciones de tablas y las migraciones en el control de versiones.
Asigne la titularidad de las tablas: cada conjunto de datos importante debe tener un equipo que apruebe los cambios estructurales.
Clasifique el impacto en los consumidores: indique si un cambio es aditivo, disruptivo o si modifica el comportamiento.
Exija notas de despliegue para las tablas compartidas: especialmente para hechos y dimensiones del almacén de datos y para las fuentes de features de ML.
Monitorice la estructura, no solo la frescura
La monitorización de la frescura le indica si los datos llegaron. No le indica si la forma sigue siendo utilizable. El número de filas le indica el volumen. No le indica si se renombró una columna clave.
Por eso la monitorización de esquemas debe comparar la estructura actual con una línea base conocida y señalar cambios de DDL como columnas añadidas, columnas eliminadas y modificaciones de tipo. Una opción es digna Schema Tracker, que monitoriza esquemas de tablas, columnas y tipos de datos para detectar cambios estructurales. El patrón general importa más que la elección del proveedor. Use una plataforma, herramientas internas o comprobaciones nativas del almacén de datos, pero asegúrese de que la estructura forme parte de su monitorización operativa.
Integre las alertas de esquema en la respuesta a incidentes
Una alerta de esquema que acaba en una bandeja de entrada olvidada no sirve de mucho. La señal tiene que llegar a las personas responsables de los pipelines, los dashboards y las entradas de los modelos.
Un patrón operativo práctico es el siguiente:
Envíe las alertas a los mismos canales que los incidentes de pipelines: sistemas de guardia, notificaciones de chat o herramientas de gestión de incidentes.
Adjunte las definiciones de antes y después: los ingenieros necesitan el diff estructural exacto, no un aviso vago.
Vincule los activos afectados cuando sea posible: dashboards, jobs, tablas de features y consumidores aguas abajo.
Ejecute validaciones tras el cambio: verifique los joins críticos, las reglas a nivel de fila y las métricas clave después de las actualizaciones estructurales.
Idea clave: si su equipo puede detectar un job fallido en minutos, pero no puede detectar una columna modificada hasta que se queja una parte interesada, su stack de monitorización está incompleto.
Mantenga el esquema útil
Los buenos esquemas no solo son correctos. Son mantenibles. Normalice donde mejore la integridad y reduzca la duplicación. Use convenciones de nomenclatura que sobrevivan a la rotación de los equipos. Evite enterrar semántica crítica para el negocio en campos con tipado laxo cuando un modelo adecuado haría explícito el contrato.
No trate la gestión del esquema como un ejercicio de diseño puntual. En los sistemas en producción, es un trabajo operativo continuo.
Si los cambios de esquema son una de las formas más rápidas de romper pipelines, dashboards y entradas de modelos, necesitan una monitorización de primer nivel. digna ayuda a los equipos a seguir los cambios estructurales junto con la calidad de los datos, la puntualidad, la validación y la detección de anomalías, para que los problemas de esquema salgan a la luz antes de convertirse en incidentes aguas abajo.
Detectar un cambio de esquema es solo la mitad del trabajo; para confirmar que los joins críticos y las reglas a nivel de fila se siguen cumpliendo tras una actualización estructural, consulte digna Data Validation.
Preguntas frecuentes
¿Qué es un esquema en una base de datos?
Un esquema es el plano estructural de una base de datos: define tablas, columnas, tipos de datos, restricciones y relaciones como las claves foráneas, sin contener los datos en sí. En los sistemas relacionales es formalmente un conjunto de restricciones de integridad y, en producción, también actúa como un contrato del que dependen pipelines, dashboards y modelos.
¿Cuál es la diferencia entre los esquemas conceptuales, lógicos y físicos?
Estas tres capas ANSI/SPARC fallan de forma distinta. La capa conceptual define objetos de negocio como clientes y pedidos, la capa lógica los convierte en entidades, claves y relaciones, y la capa física añade tipos de datos, índices y particionamiento para un motor concreto. Una columna customer_tier trasladada es un problema lógico; una partición lenta es un problema físico.
¿Qué diferencia hay entre schema-on-write y schema-on-read?
Con schema-on-write, los datos deben ajustarse a la estructura esperada antes de que la base de datos los acepte, lo que encaja con pagos, pedidos y almacenes de datos depurados. Schema-on-read primero ingiere y aplica la estructura en el momento de la consulta, algo habitual en los data lakes. Un patrón práctico acepta flexibilidad en la ingesta e impone una estructura más sólida a medida que los datos pasan a capas depuradas.
¿Cuál es la diferencia entre la evolución y la deriva del esquema?
La evolución del esquema es planificada: un equipo añade una columna que admite nulos, publica la migración, actualiza el contrato y coordina a los consumidores. La deriva del esquema consiste en añadir, eliminar o modificar columnas sin controles de migración. Ambas pueden parecer idénticas a nivel de tabla; la diferencia está en la gobernanza, la visibilidad y si los equipos aguas abajo tuvieron ocasión de prepararse.
¿Por qué los cambios de esquema rompen los pipelines de datos?
Los jobs aguas abajo dan por hecho que la estructura antigua sigue vigente, por lo que una columna renombrada, un campo eliminado o un cambio de tipo de entero a cadena pueden bloquear un job o, peor aún, mantenerlo en verde mientras los joins hacen coincidir menos filas. Cockroach Labs, citado en el artículo, atribuye entre el 60 y el 70 por ciento de los fallos de pipelines a cambios de esquema inesperados.



