Las 10 mejores herramientas de calidad de datos para 2026: una guía de expertos
|
7
minuto de lectura

Un dossier para la junta directiva debe entregarse a las 8:00 a.m. A las 7:15, el panel de ingresos cambia. Un trabajo de pipeline todavía se muestra en verde, pero un cambio de esquema previo eliminó un campo del que depende el departamento de finanzas. Para cuando alguien rastrea el problema, los ejecutivos ya tienen números contradictorios en sus bandejas de entrada.
Ese patrón es común. Un modelo de IA se desvía tras un cambio de origen que pasó desapercibido. Un informe de salud del cliente extrae cuentas duplicadas. Los analistas dejan de confiar en el almacén de datos y comienzan a validar los resultados a mano. Estos no son errores de reporte aislados. Son fallos operativos causados por datos que llegaron tarde, se rompieron sin que nadie se diera cuenta o ya no coincidían con la lógica de negocio posterior.
El tiempo de inactividad de los datos es costoso porque se propaga por los sistemas más rápido de lo que los equipos pueden inspeccionarlo manualmente. Las perspectivas de planificación para 2025 de Precisely, tal como se resumen en la revisión de los hallazgos de Alation, muestran la alta posición que ocupa la calidad de los datos entre las preocupaciones de integridad de datos para las organizaciones que planifican el año por venir.
El mercado de herramientas ha respondido, pero las listas de funciones por sí solas no ayudan mucho durante la evaluación. El ajuste es la consideración primordial. Algunas plataformas son más fuertes en el monitoreo nativo del almacén de datos y en las verificaciones dentro de la base de datos. Otras son mejores para el governance empresarial, entornos con uso intensivo de MDM u observability amplia en pipelines, inteligencia empresarial (BI) y sistemas de aprendizaje automático. Las compensaciones aparecen rápidamente en la implementación. La calidad de las alertas, la profundidad del linaje, el mantenimiento de reglas, las restricciones de privacidad y la cantidad de metadatos que un proveedor necesita ingerir importan más que una demostración pulida.
Las mejores herramientas de calidad de datos ahora se sitúan más cerca de las operaciones de producción que el tradicional control de calidad a posteriori. Vigilan la frescura, el esquema, el volumen, las distribuciones, el linaje y las reglas de negocio lo suficientemente temprano como para que los equipos actúen antes de que un ejecutivo, analista o cliente encuentre el problema primero.
Esta guía está diseñada para ese proceso de decisión. Va más allá de los resúmenes de proveedores para ofrecerle un marco de evaluación práctico, una matriz de comparación, recomendaciones específicas para cada caso de uso (como opciones que priorizan la privacidad frente a opciones ideales para empresas emergentes) y una lista de verificación de integración que puede usar con las partes interesadas de ingeniería, análisis y governance. Para obtener una visión más amplia de cómo están evolucionando las plataformas, consulte esta comparación de plataformas de herramientas de automatización y calidad de datos.
Tabla de Contenidos
1. digna
Por qué destaca digna
Dónde encaja mejor
2. Monte Carlo
Qué hace bien Monte Carlo
3. Anomalo
Dónde se gana su lugar Anomalo
4. Soda
Por qué Soda funciona bien en entornos liderados por ingeniería
5. Metaplane
6. Acceldata
Dónde tiene sentido Acceldata
7. IBM Data Observability by Databand
Dónde encaja Databand
8. Ataccama ONE
Por qué Ataccama es diferente
9. Informatica Data Quality
Cuándo Informatica es la decisión correcta
10. Qlik Talend Data Quality
Dónde encaja mejor Qlik Talend
Las 10 mejores herramientas de calidad de datos, comparación de características
Tomar la decisión correcta: de la evaluación a la acción
1. digna

digna es una de las pocas herramientas en esta categoría que se toma en serio la arquitectura que prioriza la privacidad sin renunciar a una Observability moderna. Combina la detección de anomalías, el monitoreo de puntualidad, el seguimiento de esquemas, la validación a nivel de registro y el análisis de métricas históricas en una sola plataforma, mientras se ejecuta dentro del entorno del cliente en lugar de depender de un movimiento masivo de datos hacia un conjunto de tecnologías SaaS controlado por el proveedor.
Eso importa más de lo que la mayoría de las páginas de comparación admiten. Una de las mayores brechas en el mercado es el soporte para la ejecución dentro de la base de datos en entornos regulados, especialmente donde los equipos necesitan Observability y controles de calidad sin exponer los datos de producción a un proveedor externo, como lo destaca lakeFS sobre la brecha de privacidad en las herramientas de calidad de datos. Si trabaja en finanzas, atención médica, telecomunicaciones o el sector público, esto no es algo opcional; a menudo determina si una herramienta es siquiera utilizable.
Por qué destaca digna
La parte más sólida del diseño de digna es que no obliga a elegir erróneamente entre Observability y la calidad de datos clásica. Muchos equipos terminan uniendo un producto para la detección de anomalías, otro para las reglas y un tercero para los reportes. digna mantiene esos flujos de trabajo en una sola interfaz, lo que reduce la fricción de traspaso cuando una métrica sale mal y alguien necesita responder tres preguntas rápidamente: qué cambió, cuándo comenzó y qué registros están afectados.
Su cálculo de métricas dentro de la base de datos y el aprendizaje de líneas base también se alinean con las plataformas de datos empresariales de manera más efectiva que los enfoques puramente SaaS. Mantiene los datos en su lugar. Reduce el movimiento. Puede admitir implementaciones en la nube privada o locales (on-premise). Para los equipos bajo estrictos mandatos de residencia o Compliance, esa elección arquitectónica suele ser más importante que las llamativas promesas de IA.
Una comparación detallada de proveedores está disponible en la propia guía de digna sobre herramientas y plataformas de calidad de datos de automatización en 2026.
Regla práctica: Si es probable que la revisión de seguridad domine su ciclo de compra, preseleccionar plataformas con ejecución dentro de la base de datos desde el principio ahorra meses de tiempo de evaluación perdido.
Dónde encaja mejor
digna se adapta muy bien a los equipos que necesitan una capa operativa única para fallos silenciosos como cargas tardías, cambios de esquema, métricas volátiles y violaciones de reglas de negocio a nivel de registro. También es una excelente opción cuando el equipo de la plataforma de datos quiere paneles utilizables tanto para ingenieros como para las partes interesadas del negocio, en lugar de otra consola especializada más.
Los pros y los contras se ven así en la práctica:
Ideal para entornos privados: Se ejecuta en infraestructura controlada por el cliente, lo que ayuda a los equipos que no pueden aceptar el acceso del proveedor a sus datos.
Amplia cobertura funcional: La puntualidad, la validación, la detección de anomalías, el seguimiento de esquemas y las analíticas residen en un solo producto.
Excelente para operaciones reguladas: Se adapta a organizaciones que necesitan controles estrictos de privacidad sin perder profundidad en la Observability.
Sin precios públicos: Necesitará una conversación con el equipo de ventas para comprender los paquetes disponibles.
Menos ideal para compradores exclusivos de SaaS: Los equipos que desean una herramienta completamente administrada y puramente pública pueden preferir un modelo diferente.
2. Monte Carlo
Monte Carlo sigue siendo uno de los nombres más reconocidos en la Observability de datos, y con buena razón. Está diseñado para equipos que desean un monitoreo automatizado y amplio en almacenes de datos, ETL, BI y, cada vez más, flujos de trabajo de IA, con el linaje y el triaje de incidentes como ejes centrales de la experiencia del producto.
Su mayor fortaleza es la amplitud operativa. Monte Carlo funciona bien cuando el problema no es una sola tabla en mal estado, sino un conjunto enredado de pipelines, paneles y dependencias posteriores donde el análisis del radio de impacto importa tanto como la detección inicial.
Qué hace bien Monte Carlo
Monte Carlo suele dar su mejor versión en organizaciones de datos grandes que ya tienen la complejidad suficiente para justificar flujos de trabajo de incidentes centralizados. Los monitores de frescura, esquema, volumen y distribución son requisitos básicos hoy en día, pero el valor práctico de Monte Carlo proviene de la depuración asistida por linaje y la respuesta coordinada entre equipos.
La contrapartida es el peso. Los equipos más pequeños suelen encontrar que los paquetes empresariales, la coordinación de la implementación y las compras lideradas por ventas son más pesados de lo que desean. Si solo necesita verificaciones ligeras en una sección estrecha de su almacén de datos, Monte Carlo puede parecer como comprar un centro de comando cuando en realidad solo necesitaba un detector de humo.
Utilice Monte Carlo cuando el costo de no conocer el impacto posterior sea mayor que el costo de operar una plataforma empresarial.
Algunas consideraciones prácticas:
Excelente opción para la gestión de incidentes empresariales: Ayuda a los equipos a estandarizar el monitoreo y el escalamiento.
El linaje es un diferenciador real: Mejora el análisis de causa raíz cuando los paneles y modelos dependen de muchos activos previos.
Menos amigable para equipos reducidos: Las empresas emergentes y los grupos de análisis compactos pueden encontrar que el alcance es demasiado amplio.
Espere un ciclo de ventas formal: Los precios no son públicos.
3. Anomalo
Anomalo se basa en una promesa simple que resulta muy atractiva para los saturados equipos de datos: detectar datos erróneos sin necesidad de que las personas definan un sinfín de reglas manualmente. Por eso suele destacar en entornos donde el conteo de tablas es alto, el cambio es constante y el tiempo de ingeniería ya está comprometido en otras tareas.
Esta es la categoría de herramienta que yo preseleccionaría cuando un equipo dice: "Sabemos que necesitamos un mejor monitoreo, pero no tenemos el ancho de banda para definir umbrales para todo".
Where Anomalo earns its place
Anomalo hace hincapié en el monitoreo no supervisado, el soporte automatizado de causa raíz y las integraciones con componentes modernos de tecnología de datos. En la práctica, esto significa que puede reducir la carga de mantenimiento que conllevan los programas basados en muchas reglas, especialmente cuando los conjuntos de datos evolucionan más rápido que la documentación o el Data Governance.
Dicho esto, el monitoreo autónomo no es mágico. Los equipos aún necesitan asumir la propiedad, disciplina de triaje y claridad sobre qué anomalías importan al negocio. Una herramienta puede sacar a la luz los problemas; pero no puede decidir si una carga de datos de ventas que llega tarde es urgente, aceptable o esperada en la semana de cierre de trimestre. Aún se necesita contexto operativo.
Qué funciona bien con Anomalo:
Poca carga en la definición de reglas: Útil cuando los equipos no quieren mantener verificaciones tabla por tabla.
Integraciones preparadas para empresas: Está orientado a entornos modernos de datos de gran tamaño.
Buena opción para datos que cambian rápidamente: La detección automatizada ayuda allí donde los umbrales estáticos fallan.
El precio requiere contactar al proveedor: La claridad del presupuesto llega más adelante en el proceso.
No es la opción más ligera: Los equipos pequeños pueden preferir opciones más simples o de código abierto.
4. Soda

Soda se adapta a los equipos que desean que la calidad de los datos se comporte como parte del sistema de ingeniería, no como una capa de supervisión independiente. Es una opción sólida cuando los criterios de evaluación favorecen las verificaciones dentro de la base de datos, las reglas con control de versiones y una propiedad clara dentro de la ingeniería de datos o la ingeniería analítica.
Esa distinción importa durante la selección de herramientas. Algunas plataformas se optimizan para una detección de anomalías amplia con menos configuración. Soda toma la ruta opuesta: los equipos definen las verificaciones, deciden dónde se ejecutan y las gestionan de la misma manera que gestionan los modelos de dbt, las pruebas y los cambios de implementación.
Por qué Soda funciona bien en entornos liderados por ingeniería
El atractivo principal de Soda es el control.
Soda Core y SodaCL brindan a los equipos un modelo de "verificaciones como código" que encaja de forma natural en las solicitudes de extracción (pull requests), los pipelines de CI/CD y los flujos de trabajo de lanzamiento. Para las organizaciones que ya revisan las transformaciones a través de Git y promueven los cambios a través de diferentes entornos, esa adaptabilidad arquitectónica suele importar más que una larga lista de características. El beneficio es la reproducibilidad. La contrapartida es el mantenimiento.
Esa contrapartida se vuelve más clara a medida que se amplía el alcance. Cubrir un conjunto pequeño de datos críticos para el negocio suele ser sencillo. Sin embargo, cientos de tablas en múltiples dominios pueden generar una gran dispersión de reglas, vacíos de propiedad y fallos ruidosos a menos que los equipos estandaricen plantillas, niveles de gravedad y procesos de revisión desde el principio.
Soda suele ser una buena opción cuando el equipo busca:
Verificaciones definidas en código: Excelente ajuste para flujos de trabajo centrados en dbt y la aplicación de CI/CD.
Opciones de ejecución dentro de la base de datos: Útil para equipos que desean mantener la validación cerca del almacén de datos.
Una ruta de adopción gradual: Primero código abierto, y luego colaboración administrada si el programa madura.
Propiedad operativa clara: Ideal cuando los ingenieros están preparados para mantener las reglas a lo largo del tiempo.
Precios administrados basados en cotización: La evaluación del presupuesto requiere más trabajo una vez que el equipo va más allá del software de código abierto.
Los equipos con una disciplina de ingeniería madura suelen obtener valor de Soda rápidamente. Los equipos que buscan un monitoreo de bajo contacto generalmente prefieren una herramienta con más automatizaciones y menos definición manual de reglas.
En una matriz de comparación, Soda tiende a puntuar bien en transparencia, adaptabilidad al flujo de trabajo y control de la implementación. Puntuará más bajo en cobertura desatendida. No se trata de un defecto; es una elección de diseño, y para el equipo adecuado, es la correcta.
5. Metaplane
Un escenario común se ve así: el almacén de datos está lo suficientemente saludable como para dar soporte a los informes, pero la confianza se está perdiendo porque las tablas se rompen sin que nadie lo note, la frescura de los datos se desvía de la noche a la mañana y nadie ve el problema hasta que un panel se muestra en rojo frente a los directivos del negocio. Los equipos en esa posición generalmente no están buscando un programa completo de gobierno de datos como primer paso. Quieren una advertencia temprana, una configuración rápida y suficiente contexto para dirigir los incidentes al propietario adecuado.
Metaplane se adapta bien a esa necesidad. Es un producto enfocado principalmente en la Observability, dirigido a equipos modernos de datos que desean cobertura rápidamente, especialmente en entornos con gran uso de almacenes de datos y dbt. Ese enfoque importa. Metaplane intenta reducir el tiempo hasta recibir la señal de alerta, no reemplazar cada función circundante en las tecnologías de gestión de datos.
Esa distinción da forma a la evaluación. Si el objetivo es una administración amplia, gestión de políticas y un Data Governance para toda la organización, Metaplane se sentirá limitado. Si el objetivo es detectar problemas de frescura, esquema, volumen o distribución antes de que las partes interesadas se den cuenta, el alcance más acotado puede ser una ventaja porque la implementación suele ser más rápida y la propiedad queda más clara.
Los equipos a menudo eligen Metaplane por algunas razones prácticas:
Incorporación rápida: Una buena opción para equipos que necesitan monitoreo activo sin tener que desplegar una gran plataforma.
Observability antes que gobernanza: Excelente para detectar problemas en datos de producción, pero menos adecuado para catálogos, gobernanza de linaje o programas con gran carga de administración de datos.
Alineación con arquitecturas modernas: Funciona bien en entornos analíticos desarrollados en torno a almacenes de datos en la nube y flujos de trabajo sobre dbt.
Despliegue incremental: Admite una ruta de adopción sensata donde los equipos comienzan con activos críticos para los ingresos o orientados a los ejecutivos.
Compensación en profundidad: Se obtiene velocidad y enfoque, pero las empresas más grandes aún pueden necesitar herramientas independientes para funciones más amplias de gestión de datos.
En una matriz de comparación, Metaplane suele puntuar bien en velocidad de implementación, facilidad de uso y cobertura de Observability moderna. Puntuará más bajo cuando los criterios de evaluación favorezcan la amplitud de una gobernanza todo en uno o un control profundo basado en reglas escritas. Para muchos equipos del mercado medio, esa es una compensación aceptable. La pregunta correcta no es si Metaplane lo hace todo, sino si su equipo necesita una detección rápida de incidentes dentro del almacén de datos, o un sistema más amplio que abarque calidad, gobernanza y administración desde el principio.
6. Acceldata
Acceldata es lo que yo llamaría una plataforma amplia de operaciones en lugar de una solución puntual y limitada para la calidad de datos. Abarca la confiabilidad de los datos, la Observability de pipelines, la visibilidad de la infraestructura y la supervisión de costos o rendimiento. Eso representa una gran superficie, lo cual puede ser exactamente lo correcto en entornos grandes y completamente inadecuado en los más pequeños.
La pregunta clave no es si Acceldata tiene suficientes características; es si su organización necesita un solo producto para conectar la calidad, la eficiencia del cómputo y las expectativas del acuerdo de nivel de servicio (SLA).
Dónde tiene sentido Acceldata
Acceldata funciona mejor en entornos grandes híbridos o en la nube donde los incidentes a menudo involucran tanto síntomas de los datos como causas en la infraestructura. En esos contextos, dividir las herramientas entre calidad de la información, Observability de la plataforma y gobernanza de costos puede crear puntos ciegos y confusión sobre la propiedad. La presencia más amplia de Acceldata ayuda a cerrar esa brecha.
La desventaja es la complejidad. Es posible que los equipos con tecnologías de almacén modernos y relativamente limpios no necesiten tanta superficie de plataforma. Podrían estar mejor con una herramienta de validación u Observability más enfocada.
Compensaciones prácticas:
Útil para la complejidad de entornos híbridos: Se adapta a organizaciones con preocupaciones de infraestructura estructurada por capas.
Ideal para operaciones enfocadas en SLA: La confiabilidad y el rendimiento se sitúan muy cerca en el producto.
Puede reducir la dispersión de proveedores: Si necesita tener de manera conjunta la Observability de datos y de la infraestructura.
Normalmente es demasiado pesado para equipos pequeños: El alcance y el proceso de adquisición están muy orientados a la gran empresa.
Proceso de compra dirigido por ventas: Espere una evaluación formal y la participación de múltiples áreas interesadas.
7. IBM Data Observability by Databand
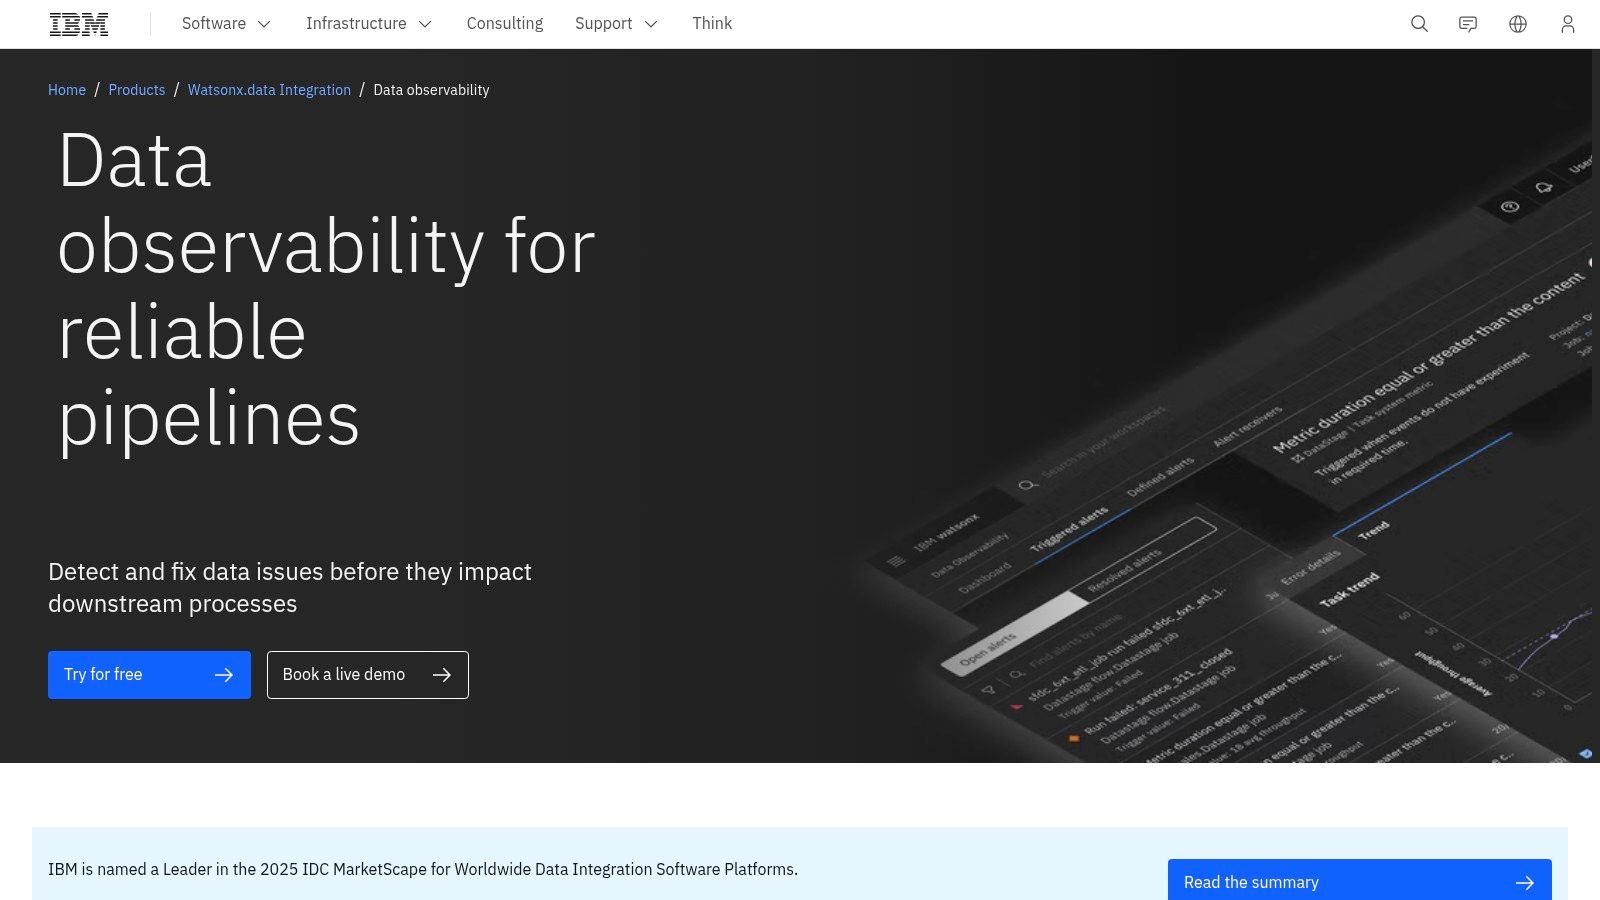
IBM Data Observability by Databand es una opción sólida para las organizaciones que desean la gestión de incidentes de datos bajo el respaldo de una gran empresa. Se enfoca en la confiabilidad de las pipelines, la detección de anomalías, las alertas y la definición de líneas base mediante metadatos, con la tranquilidad añadida de la documentación, la estructura de incorporación y los canales de soporte de IBM.
Esa última parte importa más de lo que los mercadólogos de productos suelen admitir. Algunos equipos no compran la herramienta técnicamente más novedosa; compran la que los departamentos de compras, seguridad y operaciones pueden respaldar.
Dónde encaja Databand
Databand tiende a tener más sentido en entornos empresariales ya alineados con IBM o que prefieren sólidamente a proveedores establecidos. Es especialmente relevante cuando la salud de las pipelines, la orquestación de tareas y las alertas operativas importan tanto como las verificaciones de calidad a nivel de tabla.
Resulta menos atractivo para los equipos que buscan un producto ágil, enfocado en el desarrollador, que puedan probar y escalar con procesos mínimos. Las fortalezas de IBM son la gobernanza, el soporte y la preparación para grandes empresas. Son aspectos valiosos, pero conllevan una dinámica más pesada.
Una valoración realista:
Buena opción para el control operativo empresarial: Fuerte para la prevención de incidentes y el soporte gestionado.
Funciona bien en entornos formales de TI: De gran ayuda donde el proceso y la documentación son importantes.
Se integra con flujos de trabajo basados en código: Útil para equipos de ingeniería dentro de grandes empresas.
Puede parecer pesado para grupos pequeños: Más adecuado para despliegues organizacionales amplios.
Los detalles comerciales no son completamente públicos: Planifique un proceso de ventas guiado por el proveedor.
8. Ataccama ONE
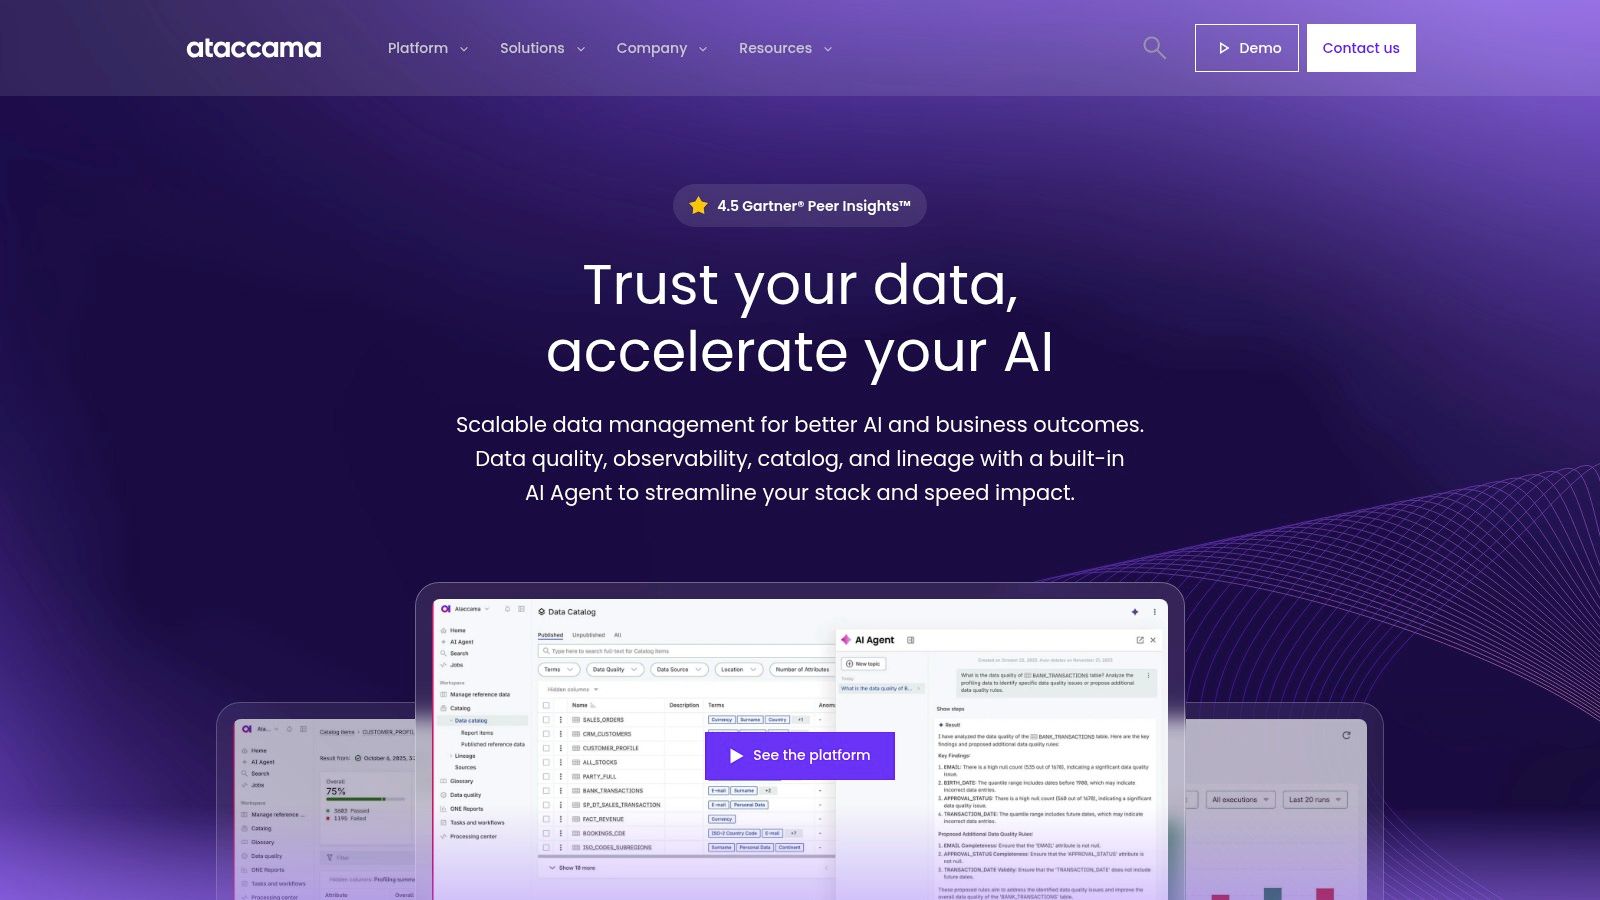
Ataccama ONE no es sólo una herramienta de calidad de datos. Es una plataforma más amplia de confianza en los datos que reúne perfilado, reglas, cuadros de mando, Observability, capacidades de catálogo, linaje y aspectos similares a MDM. Este posicionamiento la hace atractiva para las empresas que están cansadas de ejecutar iniciativas separadas para la gobernanza y la calidad.
Este es un proceso de compra diferente al de herramientas como Metaplane o Soda. No solo está resolviendo el monitoreo; está eligiendo un modelo operativo más amplio.
Por qué Ataccama es diferente
Ataccama es más fuerte cuando la organización desea que la calidad esté fuertemente vinculada al catálogo, la administración de datos y la gestión de datos de referencia. Si tanto su equipo de gobernanza como su equipo de ingeniería son partes interesadas, una suite unificada puede reducir la duplicación y evitar el problema en el traspaso donde un equipo detecta los problemas y otro posee las definiciones.
La contrapartida es el peso en la implementación. Las suites amplias suelen tardar más en implementarse y requieren una mayor alineación sobre la propiedad, los metadatos y el diseño del flujo de trabajo. A menudo dan grandes resultados en empresas reguladas o de múltiples dominios, pero suelen decepcionar a los equipos que solo buscaban una detección rápida de anomalías.
Qué esperar de Ataccama:
Cobertura de plataforma amplia: La calidad, la gobernanza, el linaje y las disciplinas relacionadas encajan armoniosamente.
Ideal para sectores regulados: Especialmente allí donde la propiedad de los datos y la auditabilidad son fundamentales.
Opciones de despliegue flexibles: Útil para patrones en la nube, híbridos y locales.
Curva de implementación más larga: La amplitud aumenta el trabajo de configuración y de gestión del cambio.
Modelo de precios empresarial: Los aspectos comerciales se basan en cotizaciones personalizadas.
9. Informatica Data Quality
Informatica Data Quality sigue siendo uno de los nombres más establecidos en la calidad de datos empresarial. Ofrece perfilado de datos, creación de reglas, cuadros de mando, manejo de excepciones y ejecución en la nube dentro del ecosistema más amplio de Informatica.
Para muchas empresas, el atractivo no pasa por la novedad. Se trata de la familiaridad, la profundidad y la capacidad de alinearse con las inversiones de Informatica ya existentes en integración, gobernanza o datos maestros.
Cuándo Informatica es la decisión correcta
Informatica suele ser la elección segura cuando una organización necesita una cobertura profunda de características, un amplio soporte empresarial e integración con tecnologías de gestión de datos maduras. Es especialmente relevante cuando el esfuerzo de calidad está vinculado al Compliance, la administración de datos y la gestión de excepciones, en lugar de limitarse a meras alertas de anomalías.
La advertencia es sencilla: Informatica puede ser un trabajo más pesado que las herramientas enfocadas selectivamente, tanto operativa como comercialmente. El empaquetado basado en el consumo y las licencias corporativas también pueden hacer que el modelado de costos sea menos intuitivo para los equipos acostumbrados a precios sencillos por asiento o por tabla.
Si su organización ya confía en Informatica para flujos de trabajo adyacentes, adquirir Informatica Data Quality suele ser más fácil que introducir una categoría de plataforma completamente nueva.
Esta es la perspectiva práctica:
Profunda funcionalidad empresarial: Fuerte en perfilado, gestión de reglas y flujos de trabajo de excepciones.
Excelente adaptación al ecosistema: Ideal cuando Informatica ya forma parte de las tecnologías de la empresa.
Opciones de escalado útiles en la nube: La ejecución sin servidores (serverless) puede ayudar con cargas de trabajo elásticas.
Empaquetado complejo: Los modelos de precios y de consumo requieren una revisión minuciosa.
No es ideal para equipos pequeños: Hay herramientas más fáciles de montar si sus necesidades son muy específicas.
10. Qlik Talend Data Quality
Qlik Talend Cloud integra la calidad de los datos en una plataforma más amplia de integración y análisis. Esa es la lente clave para evaluarla. Si busca una herramienta especializada independiente, probablemente esta no sea su primera parada. Si ya ejecuta Qlik o Talend, se vuelve mucho más interesante.
Este tipo de adaptación a la plataforma importa porque muchas organizaciones no desean otro proveedor más para la calidad si pueden ampliar razonablemente las tecnologías de integración ya existentes.
Dónde encaja mejor Qlik Talend
Qlik Talend Data Quality es más atractivo cuando el perfilado, las reglas, la administración y los flujos de trabajo de integración necesitan coexistir. Los equipos que ya confían en Talend para sus pipelines a menudo pueden moverse más rápido extendiendo lo que tienen en lugar de desplegar una capa de Observability separada con administración y compras independientes.
El inconveniente es la independencia modular. Debido a que la calidad reside dentro de una plataforma más amplia, puede no sentirse tan especializada o ligera como los productos dedicados de Observability de datos. Para algunos compradores, eso está perfectamente bien. Para otros, significa que están pagando por una estructura que no tenían intención de adquirir.
Un resumen realista:
Ideal para clientes existentes de Qlik o Talend: La armonía con la plataforma es la razón principal para preseleccionarlo.
Sólida combinación de DI y DQ: Útil cuando la integración y la calidad deben ir juntas en el plano operativo.
Buena habilitación empresarial: La documentación y el soporte general del proveedor están consolidados.
No es una herramienta pura de calidad independiente: Los compradores deben desear la plataforma ampliada.
El precio es empaquetado y orientado a empresas: Considere la participación en un proceso de ventas.
Las 10 mejores herramientas de calidad de datos, comparación de características
Producto | ✨ Diferenciador Clave | 🏆 Fortalezas | ★ Calidad / UX | 💰 Precios / Valor | 👥 Ideal Para |
|---|---|---|---|---|---|
digna | Detección de anomalías con IA dentro de la base de datos + nube privada/local | Prioriza la privacidad, DQ + Observability unificada, instalación rápida | ★★★★☆ | 💰Cotización; alto valor para entornos seguros | 👥 Empresas conscientes de la seguridad, ingenieros y analistas de datos |
Monte Carlo | Linaje de extremo a extremo + Observability de IA (incl. agentes/LLMs) | Líder de la categoría; sólido triaje de incidentes y análisis del radio de impacto | ★★★★★ | 💰Cotización; enfoque corporativo | 👥 Grandes empresas que estandarizan operaciones de incidentes |
Anomalo | Detección de anomalías no supervisada / "autónoma" | Reduce el mantenimiento de reglas; probado a escala (finanzas/comercio minorista) | ★★★★☆ | 💰Cotización; ventas corporativas | 👥 Empresas que necesitan cobertura automatizada ante anomalías |
Soda | Núcleo de código abierto (SodaCL) + nube administrada | Verificaciones como código, amigable con CI/CD, compatible con gobernanza | ★★★★ | 💰Núcleo gratuito; nube por cotización | 👥 Ingenieros de datos, equipos de DevOps y gobernanza |
Metaplane | Nativo de dbt, precios por tabla e incorporación veloz | Configuración fácil; precios transparentes; monitoreo por tabla | ★★★★ | 💰Basado en el uso; plan gratuito disponible | 👥 Equipos pequeños/medianos y entornos que usan dbt |
Acceldata | Observability + optimización de cómputo/costo/rendimiento | Amplia cobertura de pipelines e infraestructura; controles de SLA y de gasto | ★★★★ | 💰Cotización empresarial; valor enfocado a grandes infraestructuras | 👥 Entornos de datos híbridos grandes y complejos |
IBM Data Observability (Databand) | SaaS respaldado por IBM para la confiabilidad de las pipelines | Soporte corporativo, documentación, integraciones con pipelines | ★★★★ | 💰SaaS/cotización; dinámica comercial corporativa de IBM | 👥 Clientes de IBM y equipos de operaciones empresariales |
Ataccama ONE | "Confianza en los datos" unificada (DQ + catálogo + MDM) | Gobernanza integral, catálogo e integración de MDM | ★★★★ | 💰Cotización; TCO más alto para la suite completa | 👥 Industrias reguladas que necesitan una gobernanza integrada |
Informatica Data Quality | Calidad de datos madura con perfilado y opciones serverless | Profundas características empresariales; modelos de ejecución escalables | ★★★★ | 💰Basado en el consumo; empaquetado complejo | 👥 Grandes organizaciones reguladas, con altas necesidades de calidad de datos |
Qlik Talend Data Quality | Calidad de datos integrada con la integración de datos (Talend) | DI + DQ integrados; características de administración y remediación | ★★★★ | 💰Paquete/cotización a través de Qlik Talend Cloud | 👥 Equipos con inversiones en tecnología de integración de Qlik/Talend |
Tomar la decisión correcta: de la evaluación a la acción
Una evaluación real usualmente comienza de la misma manera: un panel de control se rompe, el negocio pregunta si el número está mal o si el pipeline viene retrasado, y el equipo se da cuenta de que tres herramientas diferentes pueden capturar cada una parte del problema, pero ninguna se adapta limpiamente al modelo operativo.
Por eso, la selección de herramientas debe comenzar con las restricciones, no con las tablas de características. La primera pregunta es dónde se ejecutan las verificaciones y quién puede acceder a los datos de producción. Para los equipos en sectores regulados, esa decisión elimina inmediatamente una gran parte del mercado. Si los datos no pueden salir de su entorno, la ejecución dentro de la base de datos y la implementación controlada por el cliente son requisitos basales. digna se adapta a ese modelo con detección de anomalías, validación, monitoreo de puntualidad y seguimiento de esquemas que pueden ejecutarse sin enviar los datos de producción a un entorno controlado por un proveedor.
La siguiente pregunta es la propiedad intelectual y de mantenimiento. Los equipos con prácticas sólidas de ingeniería analítica a menudo prefieren verificaciones como código, control de versiones y alineación con CI/CD. Los equipos enfocados en la Observability suelen preocuparse más por la detección automatizada, el contexto del linaje, el ajuste de alertas y la respuesta ante incidentes. Ningún modelo es intrínsecamente mejor que el otro. El modelo equivocado crea monitores inactivos, alertas ignoradas y reglas que nadie mantiene después del proyecto piloto.
La tolerancia de implementación importa exactamente lo mismo. Las suites grandes como Ataccama ONE, Informatica e IBM Data Observability by Databand pueden adaptarse a organizaciones donde la calidad de los datos está vinculada a la administración de datos, el Compliance y los procesos operativos formales. También conllevan ciclos de implementación más largos, una mayor coordinación de las áreas interesadas y un costo total más alto. Los equipos más pequeños a menudo obtienen más valor de productos que resuelven bien un problema más acotado, especialmente cuando el dolor inmediato son los fallos de frescura, los cambios de esquema o los paneles rotos en etapas posteriores.
Los casos de uso deben orientar la preselección.
Si la revisión de seguridad es el principal obstáculo, priorice las herramientas que se ejecutan dentro de su almacén de datos o de su propia infraestructura. Si la velocidad de inicio de una startup importa más que la amplitud de la gobernanza, favorezca productos con instalación rápida, precios claros y poca carga de administración de reglas. Si el entorno ya está estandarizado en dbt, Airflow, Databricks, Snowflake o un integrador empresarial líder, pondere con fuerza las integraciones nativas. La fricción en la integración es una de las formas más rápidas de convertir una prueba de concepto prometedora en software guardado en un cajón.
Los puntos de referencia aún pueden ayudar. El resumen de 6Sigma sobre los puntos de referencia de calidad de datos es útil como recordatorio de que la calidad necesita objetivos medibles en precisión, integridad, consistencia y control de duplicados. Los umbrales exactos variarán según el dominio. Una pipeline de finanzas y un flujo de eventos de análisis de producto no deben medirse con el mismo nivel de tolerancia. Lo que importa es que la herramienta sea compatible con el monitoreo, el envío de alertas, la corrección y los informes de tendencias en base a los estándares que su negocio acepta.
La detección moderna también está cambiando el proceso de evaluación. La detección automatizada de anomalías ahora captura clases de problemas que las reglas estáticas omiten, sobre todo el desvío gradual y los cambios inesperados en la distribución o el tiempo. Eso no reemplaza las verificaciones deterministas. La lógica de negocio aún necesita una validación explícita. En la práctica, las configuraciones más robustas combinan ambas: reglas duras para modos de falla conocidos y monitoreo adaptativo para los problemas que a nadie se le ocurrió codificar.
Ejecute una prueba de concepto como un ejercicio de operaciones, no como un ejercicio de ventas. Elija un conjunto pequeño de tablas críticas para el negocio y pruebe seis cosas: frescura de datos, detección de cambios de esquema, variaciones en volumen, validez a nivel de campo, asignación de rutas de alertas y flujos de trabajo sobre la causa raíz. Incluya a seguridad, plataforma y a las personas que poseerán los incidentes después del lanzamiento. Si la aprobación se detiene por el acceso a los datos, el patrón de implementación o la carga de mantenimiento, eso no es un asunto secundario; es el resultado determinante.
La elección correcta es la herramienta que su equipo pueda operar semana a semana sin necesidad de acciones heroicas. A veces se trata de una suite empresarial. A veces es una capa de Observability más ligera. A veces, es un producto que prioriza la privacidad diseñado para ejecutarse dentro de la base de datos.
Como un recordatorio operativo independiente para los equipos que gestionan flujos de comunicación con los clientes junto con la higiene de datos, también vale la pena aprender cómo evitar correos electrónicos devueltos.
Si su equipo necesita un enfoque que priorice la privacidad para la calidad de los datos y la Observability, vale la pena mirar de cerca digna - foro - English. Está diseñado para equipos que necesitan detección de anomalías, validación de registros, monitoreo de puntualidad y seguimiento de esquemas dentro de entornos controlados por el cliente, sin dar a los proveedores acceso a los datos de producción.
Si su lista corta depende del soporte nativo para su data warehouse y su stack de pipelines, el resumen de integraciones de digna muestra con qué plataformas de datos se conecta digna antes de comprometerse con una prueba de concepto.
Preguntas frecuentes
¿Cuáles son las mejores herramientas de calidad de datos en 2026?
La guía compara diez plataformas: digna, Monte Carlo, Anomalo, Soda, Metaplane, Acceldata, IBM Data Observability by Databand, Ataccama ONE, Informatica Data Quality y Qlik Talend Data Quality. Ninguna gana en todo; la elección correcta depende de dónde se ejecutan los controles, quién los gestiona y cuánto esfuerzo de implementación puede asumir su equipo.
¿Qué herramienta de calidad de datos conviene en entornos regulados o sensibles a la privacidad?
Conviene buscar herramientas que se ejecuten dentro de su propia infraestructura. La guía presenta digna como la opción centrada en la privacidad, porque calcula métricas y aprende líneas base dentro de la base de datos, on-premises o en nube privada, sin enviar datos de producción a un proveedor. En finanzas, salud, telecomunicaciones o sector público, esto suele decidir si una herramienta es desplegable.
¿En qué se diferencia Soda de Monte Carlo?
Soda sigue un modelo de checks-as-code: los equipos escriben checks en SodaCL, los versionan en Git y los ejecutan en CI/CD, lo que da control pero exige mantenimiento a medida que crecen las tablas. Monte Carlo se centra en una monitorización automatizada amplia, con triaje de incidentes apoyado en el linaje y análisis del radio de impacto, pensada para grandes organizaciones con pipelines complejos.
¿Cómo se hace una prueba de concepto de una herramienta de calidad de datos?
Trátela como un ejercicio de operaciones, no de ventas. Elija un pequeño conjunto de tablas críticas para el negocio y pruebe seis aspectos: frescura, detección de cambios de esquema, variaciones de volumen, validez a nivel de campo, enrutamiento de alertas y flujo de análisis de causa raíz. Incluya a seguridad, plataforma y a quienes gestionarán los incidentes.
¿Debo usar reglas o detección automática de anomalías?
Ambas, según la guía: las configuraciones más sólidas combinan reglas estrictas para fallos conocidos con monitorización adaptativa para los problemas que nadie pensó en codificar. La detección de anomalías capta la deriva gradual y los cambios inesperados en distribución o tiempos, mientras que la validación explícita sigue siendo necesaria para la lógica de negocio que debe cumplirse en cada registro.



