Qu’est-ce qu’un schéma de base de données : le guide 2026
|
8
minute de lecture

Si vous cherchez ce qu’est un schéma, ce n’est probablement pas par curiosité pour la théorie des bases de données. Vous cherchez parce que quelque chose en aval semble fragile. Un tableau de bord a cessé de fonctionner après une mise en production de routine. Un pipeline a commencé à échouer sur une table qui « n’avait pas changé ». Un modèle a continué à produire des scores, mais les résultats n’avaient plus de sens.
Voilà la raison pratique de s’intéresser aux schémas. Bien souvent, ce sont les valeurs des données qui retiennent l’attention, tandis que la structure qui les entoure évolue sans être observée en arrière-plan. C’est là que commencent de nombreuses défaillances coûteuses.
Si vous voulez d’abord la réponse de manuel, la voici : un schéma de base de données est le plan structurel qui définit l’organisation des données, y compris les tables, les colonnes, les types de données, les contraintes et les relations telles que les clés étrangères, comme le décrit la définition de la structure d’un schéma de base de données selon Oracle. Mais cette définition n’est qu’un point de départ. Dans les systèmes réels, le schéma est aussi un contrat. Lorsque ce contrat change sans contrôle, ce sont souvent les pipelines, les tableaux de bord et les systèmes de ML qui encaissent les dégâts en premier.
Table des matières
La défaillance silencieuse derrière un tableau de bord cassé
Une défaillance typique commence par une matinée tout à fait ordinaire. Un développeur BI ouvre un tableau de bord du chiffre d’affaires et voit des cases vides là où, la veille, il y avait des tendances. Un data engineer vérifie la couche d’orchestration et constate qu’une transformation en aval a échoué. Le système source fonctionne. Les ressources de calcul sont en ordre. Rien ne semble surchargé.
La cause racine s’avère plus modeste que prévu. Une équipe en amont a renommé une colonne, supprimé un champ ou changé un type de valeurs entières en chaînes de caractères. Personne ne l’a annoncé. Aucune migration n’est parvenue à l’équipe analytique. Le pipeline n’était ni surchargé ni mal paramétré. Il attendait une structure et en a reçu une autre.
C’est pourquoi les explications d’introduction sur les schémas paraissent souvent incomplètes. Elles décrivent le schéma comme une structure, ce qui est exact, mais elles s’arrêtent avant d’en tirer la conséquence opérationnelle. Des analyses récentes du secteur indiquent que 60 à 70 % des défaillances de pipelines de données proviennent de changements de schéma inattendus plutôt que de problèmes de volume, un point souligné dans l’analyse du risque lié aux schémas publiée par Cockroach Labs.
Pourquoi ces défaillances sont difficiles à diagnostiquer
Les incidents liés aux schémas sont compliqués, car ils ne se manifestent pas toujours bruyamment. Parfois, le job plante lors de l’analyse syntaxique. Parfois, une transformation ignore un champ sans que personne ne s’en aperçoive. Parfois, le tableau de bord se charge toujours, mais un indicateur est désormais faux, parce qu’une jointure ne correspond plus ou qu’une conversion de type renvoie désormais des valeurs nulles.
La plupart des équipes surveillent le nombre de lignes et la fraîcheur avant de surveiller la structure. C’est l’inverse de ce qu’il faudrait faire, puisque c’est sur la structure que reposent toutes les hypothèses en aval.
Un tableau de bord cassé n’est généralement que le symptôme visible. Le problème de fond se situe un niveau plus bas, dans le contrat qui définit l’apparence que les données sont censées avoir.
La vraie leçon
Si vous ne surveillez que les valeurs, vous passerez à côté de toute une catégorie de défaillances. Les schémas méritent la même attention opérationnelle que le code, les jobs et l’infrastructure. Pour les équipes data modernes, « qu’est-ce qu’un schéma de base de données » n’est pas une question académique. C’est une question de fiabilité.
Le plan de votre base de données
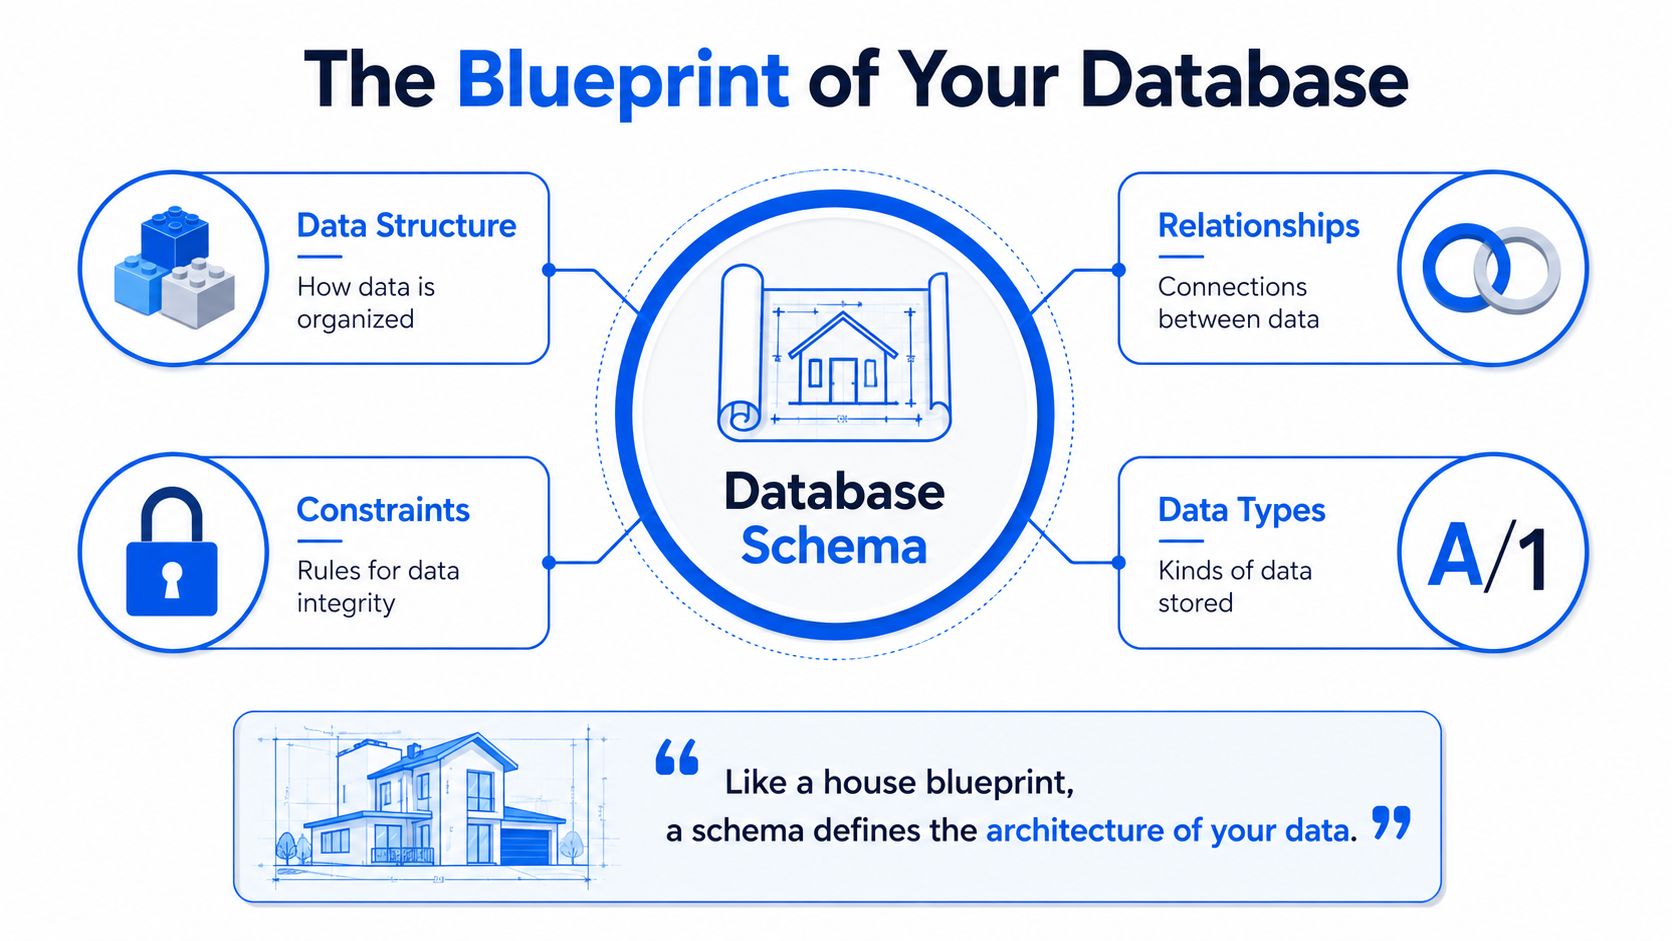
La façon la plus simple de comprendre un schéma est de le considérer comme le plan d’un bâtiment. Le plan ne contient ni les meubles ni les personnes qui occupent la maison. Il définit les pièces, les portes, les murs porteurs et les règles que la construction doit respecter.
Dans une base de données relationnelle, la version formelle est plus stricte. Dans les systèmes de gestion de bases de données relationnelles, un schéma est formellement défini comme un ensemble de contraintes d’intégrité, des formules logiques qui empêchent l’insertion de données violant les règles structurelles, et qui servent de plan, sans données, des tables, des champs, des types de données et des relations, comme l’explique la présentation du schéma de base de données par IBM.
Ce que le plan contient réellement
Un schéma, dans la pratique, définit généralement plusieurs éléments essentiels :
Les tables représentent les principales entités que vous stockez, comme
customers,ordersoupayments.Les colonnes définissent les attributs de chaque table, comme
customer_id,emailoucreated_at.Les types de données précisent le type de valeur que chaque colonne peut contenir, par exemple un entier, du texte ou un horodatage.
Les contraintes imposent des règles comme
PRIMARY KEY,NOT NULLou l’unicité.Les relations relient les tables par des clés, généralement au moyen de références de clés étrangères.
Si l’on revient à l’analogie du plan, les tables sont les pièces, les colonnes les équipements, les types de données les spécifications des matériaux et les contraintes les normes de construction qui empêchent les malfaçons.
Pourquoi les contraintes comptent en production
L’expression « ensemble de contraintes d’intégrité » paraît abstraite tant que vous n’avez pas vécu les conséquences de mauvaises données. Les contraintes empêchent certaines catégories de défaillances avant même que les données n’entrent dans la base. Une clé primaire empêche les identités en double. Une clé étrangère évite les enregistrements orphelins. Une contrainte de type empêche une colonne d’horodatage d’accepter du texte libre.
C’est important, car la prévention coûte moins cher que le nettoyage. Lorsque la base de données applique les règles structurelles au moment de l’écriture, les jobs en aval n’ont pas à deviner si les hypothèses fondamentales sont toujours valables.
Élément du schéma | Rôle | Défaillance typique en l’absence de gestion |
|---|---|---|
Définition de table | Organise les données des entités | Concepts métier manquants ou en double |
Définition de colonne | Décrit chaque attribut | Transformations cassées lorsque les noms changent |
Type de données | Contrôle le format des valeurs autorisées | Erreurs de conversion, multiplication des valeurs nulles, agrégations erronées |
Contrainte | Garantit l’intégrité | Doublons, références invalides, enregistrements incohérents |
Relation | Relie les entités entre les tables | Jointures incorrectes et rapports trompeurs |
Règle pratique : si un champ est suffisamment important pour servir de clé de jointure, de filtre ou d’entrée à un modèle, sa définition dans le schéma doit être considérée comme faisant partie de votre contrat de production.
Ce qui fonctionne et ce qui ne fonctionne pas
Ce qui fonctionne, c’est une structure explicite. Une responsabilité claire sur les tables. Des modifications DDL relues. Des contraintes qui reflètent la réalité métier.
Ce qui ne fonctionne pas, c’est de traiter le schéma comme une documentation que l’on crée une fois puis que l’on oublie. Le plan ne vous protège que si les équipes le maintiennent aligné sur le bâtiment qu’elles modifient.
Schémas conceptuels, logiques et physiques
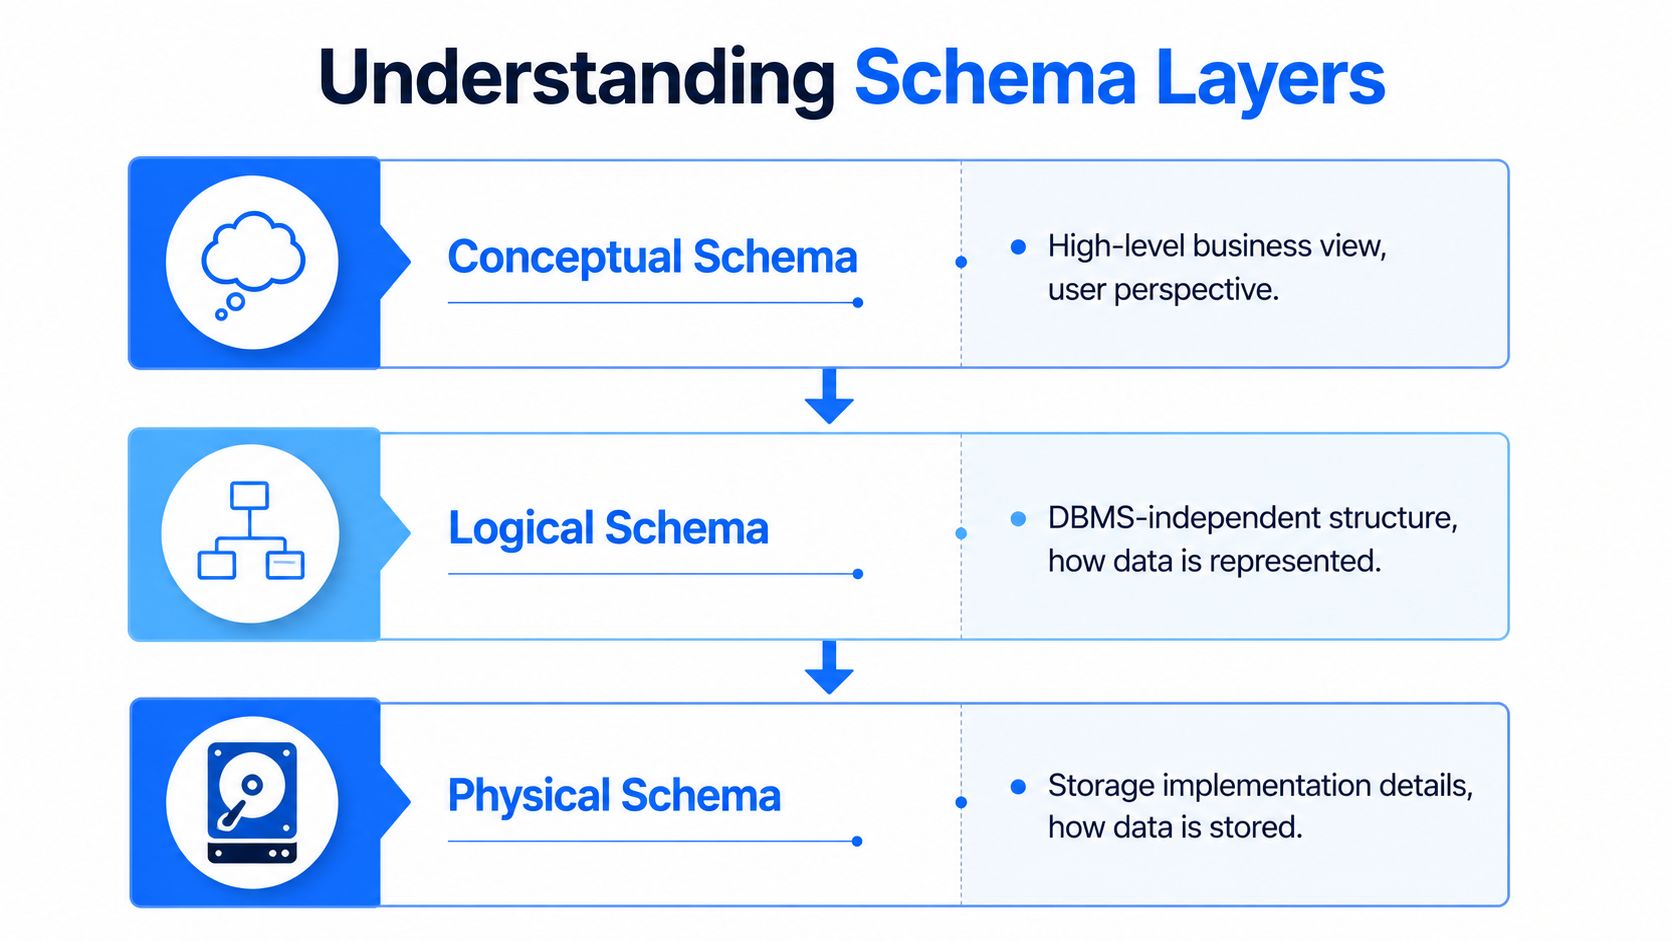
On enseigne généralement le schéma de base de données comme la définition de l’organisation des données. En pratique, cette définition existe à plusieurs niveaux, et chaque niveau influe sur un type de décision différent. Si une équipe les confond, les changements de schéma deviennent plus difficiles à relire, les responsabilités se brouillent et le risque en production augmente.
La vue classique à trois niveaux provient de l’architecture ANSI/SPARC : conceptuel, logique et physique. La présentation par IBM de l’architecture à trois schémas en est un exemple d’application concrète.
Un exemple e-commerce sur trois niveaux
Prenons un système de commerce en ligne comme exemple concret.
Au niveau conceptuel, le métier définit les objets fondamentaux : clients, produits, commandes et paiements. Ce niveau capture le sens et les règles du domaine métier. Il répond à des questions comme : qu’est-ce qu’une commande, qui est un client, et un remboursement relève-t-il des paiements ou des commandes ?
Au niveau logique, cette vision métier devient un modèle de données. Les ingénieurs définissent les entités, les attributs, les clés et les relations, par exemple de customers vers orders, de orders vers order_items et de payments vers orders. L’accent est mis sur la structure et la cohérence, pas sur les détails de stockage.
Au niveau physique, la conception devient exécutable dans un moteur de base de données précis. Types de données, index, clustering, partitionnement, organisation des fichiers et options propres au moteur apparaissent tous ici. C’est à ce niveau que les performances, le coût de stockage et le comportement opérationnel commencent à diverger entre des systèmes qui se ressemblent sur un tableau blanc.
Pourquoi ces distinctions comptent en production
Chaque niveau échoue à sa manière.
Une erreur conceptuelle vous donne le mauvais objet métier. Une erreur logique produit des jointures cassées, des entités en double ou des modèles que les analystes contournent avec du SQL sur mesure. Une erreur physique ralentit les requêtes, gonfle le stockage et transforme des changements de schéma de routine en migrations risquées.
Cette séparation aide aussi lors de la gestion des incidents. Si un tableau de bord casse parce que customer_tier a été déplacé d’une table à une autre, le problème est logique. Si le tableau de bord fonctionne toujours mais que le temps de requête explose après un changement de partitionnement, le problème est physique. Si deux équipes ne s’accordent pas sur le fait de compter ou non les utilisateurs en période d’essai comme clients, le problème est conceptuel. Identifier le bon niveau raccourcit la correction.
Le schéma en tant qu’espace de noms
Les systèmes relationnels emploient aussi le mot schéma dans un second sens : un espace de noms d’objets tel que finance, sales ou analytics. Dans des plateformes comme SQL Server et PostgreSQL, cet espace de noms regroupe des tables, des vues et d’autres objets dans un périmètre nommé doté de ses propres règles d’accès.
Cela compte sur le plan opérationnel. La conception des espaces de noms influe sur la gestion des droits, l’isolation des déploiements et la propriété des objets. Une équipe peut stocker des tables de santé à accès restreint dans un schéma et publier des vues de reporting validées dans un autre. Bien fait, cela réduit les expositions accidentelles et facilite l’application des responsabilités.
Le piège, c’est que les ingénieurs utilisent souvent le même mot pour les deux notions. Parfois, « changement de schéma » signifie que le type d’une colonne a changé. Parfois, cela signifie qu’un objet est passé de staging à analytics. Ce sont des événements différents, avec des rayons d’impact différents. Les traiter comme identiques, c’est ainsi que les revues passent à côté de l’impact en aval et que la dérive de schéma finit par casser des pipelines.
Schema-on-Write ou Schema-on-Read
Tous les systèmes n’appliquent pas la structure au même moment. C’est là que de nombreuses discussions sur « qu’est-ce qu’un schéma de base de données » deviennent plus modernes. La réponse change selon le moment où vous faites respecter le contrat.
Schema-on-Write
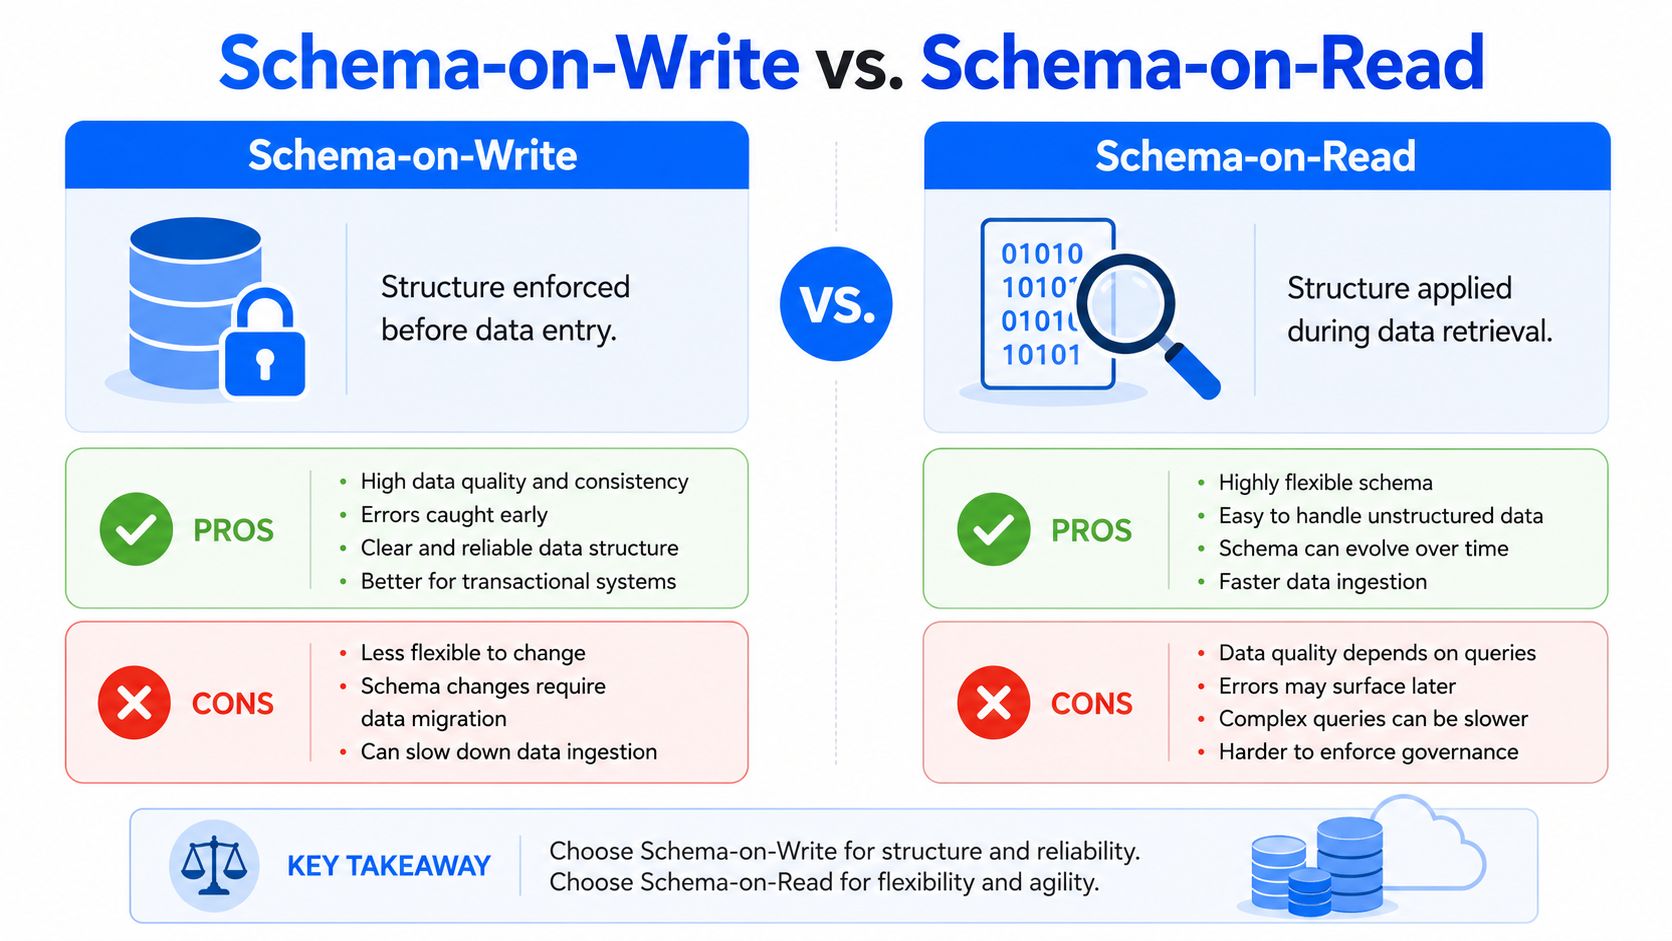
Les systèmes relationnels traditionnels suivent généralement l’approche schema-on-write. Les données doivent correspondre à la structure attendue avant que la base ne les accepte. Si la table attend un horodatage et reçoit du texte mal formé, l’écriture doit échouer ou être rejetée par une transformation contrôlée.
Cette rigidité est utile dans les systèmes transactionnels. Paiements, commandes, soldes de comptes et données d’identité bénéficient d’une structure stricte, car les consommateurs ont davantage besoin de cohérence que de flexibilité.
Avantages
Forte intégrité à l’ingestion : les enregistrements invalides sont bloqués tôt.
Utilisation en aval plus propre : analystes et applications travaillent avec des structures prévisibles.
Contrats clairs : producteurs et consommateurs savent quelle forme est attendue.
Inconvénients
Adaptation plus lente : modifier le modèle exige généralement de planifier une migration.
Davantage de coordination : les équipes en amont et en aval doivent s’aligner avant la mise en production.
Moins de tolérance pour l’ingestion brute : les données semi-structurées nécessitent un prétraitement.
Schema-on-Read
Les data lakes et les zones d’atterrissage brutes utilisent souvent l’approche schema-on-read. Les équipes ingèrent d’abord et appliquent la structure plus tard, lors de l’interrogation ou de la transformation des données. Cela fonctionne bien lorsque les entrées sont variées, semi-structurées ou évoluent rapidement.
La flexibilité est réelle. Le risque opérationnel aussi. Si chaque consommateur déduit la structure à sa manière, un même jeu de données brut peut donner lieu à plusieurs interprétations.
Approche | Cas d’usage idéal | Principal atout | Principal risque |
|---|---|---|---|
Schema-on-Write | Systèmes transactionnels, entrepôts de données validés | Cohérence avant le stockage | Rigidité lors des changements |
Schema-on-Read | Data lakes bruts, analyses exploratoires, ingestion hétérogène | Flexibilité à l’ingestion | Interprétation incohérente en aval |
Ce qui fonctionne en pratique
L’erreur n’est pas de choisir l’un ou l’autre. L’erreur est de croire que la gestion des schémas disparaît avec le schema-on-read. Ce n’est pas le cas. Vous avez toujours besoin de contrats, de catalogage, de validation et de surveillance des changements. Sinon, le data lake devient un endroit où les consommateurs redécouvrent sans cesse les mêmes surprises structurelles.
Une approche pragmatique consiste à accepter la flexibilité à l’ingestion, puis à imposer une structure plus stricte à mesure que les données passent dans les couches validées. Les équipes peuvent ainsi ingérer rapidement sans laisser les analyses et les modèles en aval fonctionner à l’aveugle.
Quand le plan change : évolution et dérive du schéma
Aucun schéma de production ne reste figé. Les produits ajoutent des fonctionnalités. Les API changent. Les applications sources versionnent leurs payloads. Les réglementations imposent de nouveaux champs. Les équipes scindent une table en trois, ou en regroupent dix en une seule. Le changement en soi n’est pas le problème.
Le problème est de savoir si le changement est délibéré et visible.
Évolution du schéma ou dérive du schéma
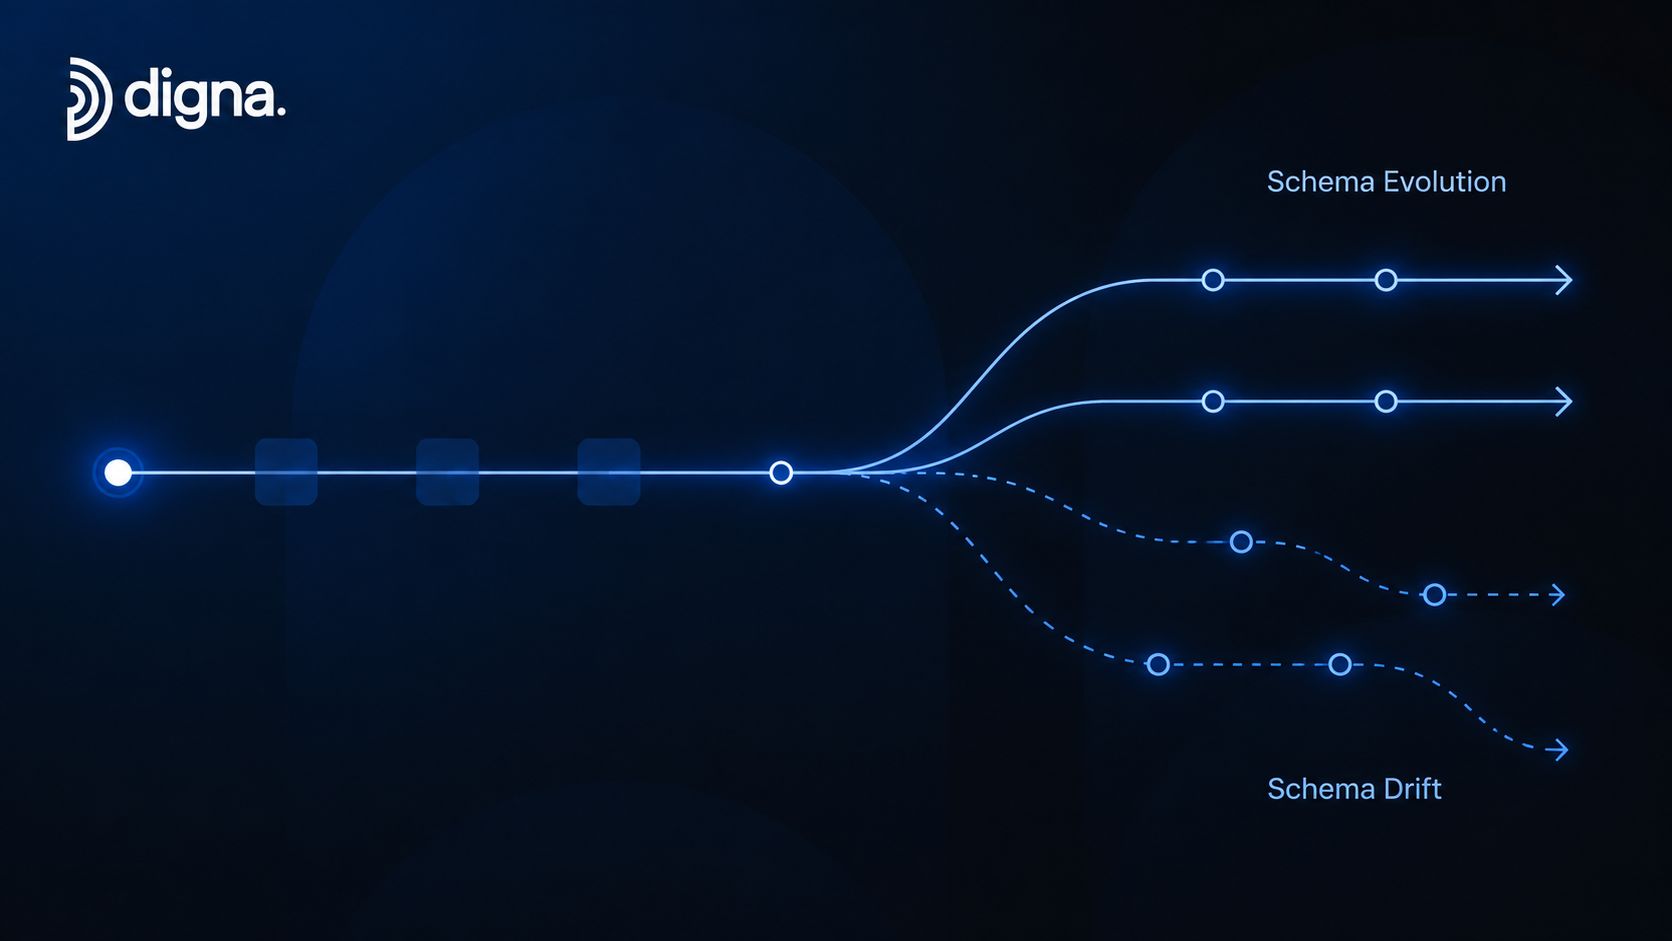
L’évolution du schéma est un changement planifié. Une équipe introduit une nouvelle colonne pouvant être nulle, publie la migration, met à jour le contrat et coordonne les consommateurs. Il peut rester du travail, mais au moins le changement est intentionnel.
La dérive du schéma survient lorsque des colonnes sont ajoutées, supprimées ou modifiées sans contrôle de migration approprié. Selon cette explication de la dérive de schéma et des ruptures en aval, ces changements peuvent casser de manière inattendue les applications en aval.
Si vous souhaitez une analyse plus approfondie de ce mode de défaillance, ce guide expliquant comment les changements structurels cassent les pipelines de données est utile, car il présente la dérive comme un enjeu de fiabilité opérationnelle, et pas seulement comme une question de modélisation.
Cinq causes fréquentes dans les systèmes réels
Voici les causes que je rencontre le plus souvent :
Développement de fonctionnalités dans les applications sources
Les équipes produit ajoutent des champs pour prendre en charge de nouveaux processus, mais les consommateurs analytiques ne sont jamais informés de la mise en production.Changements de type lors de refontes de services
Un service se met à émettre des identifiants sous forme de chaînes plutôt que de valeurs numériques, ou le format d’un champ de date change.Révisions d’API tierces
Les fournisseurs ajoutent des attributs imbriqués, rendent des champs obsolètes ou renomment des clés de payload.Modifications manuelles non relues de la base de données
Quelqu’un exécute du DDL directement en production ou dans un environnement partagé, sans chemin de migration.Dérive entre les environnements
Développement, préproduction et production cessent de correspondre, si bien que le comportement du pipeline change après le déploiement.
À quoi ressemble une évolution saine
Une bonne évolution laisse une trace écrite. Le DDL est versionné. Les consommateurs savent ce qui a changé. Des périodes de compatibilité existent pour les tables à fort impact. Des contrôles de validation s’exécutent après le déploiement.
Un changement de schéma planifié relève de l’ingénierie normale. Un changement de schéma non suivi alimente les incidents.
Cette distinction compte, car les deux événements peuvent sembler identiques au niveau de la table. La différence tient à la gouvernance, à la visibilité et au fait que les équipes en aval aient eu ou non l’occasion de se préparer.
Le coût élevé des changements de schéma silencieux
Un changement de schéma devient coûteux dès que les systèmes en aval supposent que l’ancienne structure est toujours valable. La définition de manuel d’un schéma est simple : il définit des tables, des colonnes, des types et des relations. En production, il détermine aussi si votre tableau de bord est fiable, si votre pipeline de features correspond toujours aux hypothèses de l’entraînement et si les ingénieurs passent l’après-midi à livrer du travail ou à réparer les dégâts.

Scénario 1 : le pipeline échoue rapidement
C’est le mode de défaillance visible. Une colonne source est supprimée ou renommée. Une transformation fait référence à l’ancien champ. Le job échoue, les alertes se déclenchent et l’ingénieur d’astreinte dispose d’une erreur concrète à analyser.
Ce type de rupture coûte cher, mais il reste au moins circonscrit. L’équipe compare les versions, corrige la transformation, relance le job et explique le retard aux utilisateurs en aval. Vous perdez du temps d’ingénierie et de la fraîcheur, mais en général vous ne perdez pas la confiance bien longtemps, car la défaillance est évidente.
Scénario 2 : le tableau de bord continue de fonctionner, mais il ment
C’est l’incident que les équipes sous-estiment.
Un changement de type, une incohérence de clé ou un comportement modifié vis-à-vis des valeurs nulles peut laisser le pipeline au vert alors que l’indicateur devient faux. La jointure s’exécute toujours, mais moins de lignes correspondent. La conversion de type fonctionne toujours, mais les valeurs invalides deviennent nulles. Le chiffre d’affaires atterrit dans la mauvaise catégorie, ou un KPI baisse pour des raisons qui n’ont rien à voir avec l’activité.
Dès lors, le problème quitte la plateforme de données et entre dans la prise de décision. Les analystes se mettent à remonter la logique des modèles, les tables de l’entrepôt et les flux sources. Les managers remettent en question le chiffre avant que quiconque ne remette en question le schéma. Le coût ne se limite plus au calcul ou aux heures d’ingénierie. Il se traduit par des décisions plus lentes, des validations répétées et une confiance réduite dans chaque rapport construit sur ce jeu de données.
Les problèmes de schéma silencieux sont dangereux, car le résultat semble toujours exploitable.
C’est pourquoi la gestion des schémas relève du travail de fiabilité, et pas seulement de la documentation.
Scénario 3 : le système de ML se dégrade sans erreur apparente
Les pipelines de ML sont moins tolérants que de nombreux processus de reporting. Un modèle peut continuer à produire des scores alors que l’ensemble de features s’éloigne de ce que l’entraînement attendait.
Un champ numérique arrive sous forme de texte. Une valeur catégorielle reçoit un nouvel encodage. Une colonne clairsemée commence à être renseignée différemment après une mise en production applicative. Aucun de ces changements n’a besoin de lever une exception pour causer des dégâts. Ils peuvent décaler les distributions des features, casser des hypothèses intégrées au prétraitement et créer un décalage entre entraînement et inférence qu’il faut des jours pour diagnostiquer.
En pratique, la dérive de schéma devient un problème d’exploitation de l’IA. Les équipes ont besoin de contrôles sur la structure des features avant de considérer les résultats du modèle comme fiables. Un processus de suivi des changements de schéma pour les actifs de données en production permet de détecter ces changements avant qu’ils n’atteignent les jobs de scoring ou de réentraînement en aval.
Des coûts bien réels, même sans incident déclaré
Même lorsque personne n’ouvre d’incident, la facture finit par arriver :
Interruptions du travail d’ingénierie : data engineers et analytics engineers interrompent le travail planifié pour remonter des incohérences structurelles entre systèmes.
Érosion de la confiance : les utilisateurs métier commencent à exiger une validation manuelle avant d’agir sur les chiffres des tableaux de bord.
Frictions lors des mises en production : chaque changement en amont paraît risqué, car l’impact en aval est difficile à prévoir.
Gaspillage de stockage et de requêtes : une discipline de schéma insuffisante entraîne souvent des champs en double, des types incohérents, des tables plus larges que nécessaire et des traitements plus coûteux.
Ce qui fonctionne et ce qui échoue
Les équipes obtiennent de meilleurs résultats lorsqu’elles traitent les changements de schéma comme des changements de production ayant un impact sur les consommateurs. Relisez le DDL. Comparez la structure actuelle à une référence. Vérifiez que les modèles partagés, les tableaux de bord et les pipelines de features correspondent toujours au contrat sur lequel ils ont été construits.
Ce qui échoue, c’est la coordination informelle. Un message dans une messagerie, une note de version que personne ne lit, ou l’hypothèse qu’un pipeline au vert signifie que les données sont toujours correctes. Sur le plan opérationnel, le schéma fait partie de la surface contractuelle de la plateforme. Si vous ne surveillez pas cette surface, les ruptures silencieuses deviennent un centre de coûts récurrent.
Bonnes pratiques de gestion et de surveillance des schémas
La gestion manuelle des schémas casse généralement aux frontières entre équipes. Une pull request est fusionnée dans le dépôt de l’application, mais l’équipe analytique ne suit pas ce dépôt. Quelqu’un met à jour un connecteur tiers, mais le responsable du modèle ne voit jamais la note de version. La documentation existe, mais elle est en retard sur la réalité.
Une meilleure approche consiste à traiter le schéma comme un actif de production observable.
Mettre en place un processus de changement réellement appliqué
Un modèle de gouvernance lourd paraît séduisant sur le papier et se retrouve souvent contourné en pratique. Gardez un processus suffisamment léger pour que les ingénieurs produit le suivent.
Appliquez quelques règles simples :
Versionner les modifications DDL : conservez les définitions de tables et les migrations dans le contrôle de version.
Attribuer la responsabilité des tables : chaque jeu de données important doit avoir une équipe qui approuve les changements structurels.
Classer l’impact sur les consommateurs : indiquez si un changement est additif, cassant ou s’il modifie le comportement.
Exiger des notes de déploiement pour les tables partagées : en particulier pour les tables de faits et de dimensions de l’entrepôt et les sources de features de ML.
Surveiller la structure, pas seulement la fraîcheur
La surveillance de la fraîcheur vous indique si les données sont arrivées. Elle ne vous dit pas si leur forme est toujours exploitable. Le nombre de lignes vous renseigne sur le volume. Il ne vous dit pas si une colonne clé a été renommée.
C’est pourquoi la surveillance des schémas doit comparer la structure actuelle à une référence connue et signaler les changements DDL tels que les colonnes ajoutées, les colonnes supprimées et les modifications de type. Une option est digna Schema Tracker, qui surveille les schémas de tables, les colonnes et les types de données afin de détecter les changements structurels. L’approche globale compte davantage que le choix du fournisseur. Utilisez une plateforme, des outils internes ou des contrôles natifs de l’entrepôt, mais assurez-vous que la structure fait partie de votre surveillance opérationnelle.
Intégrer les alertes de schéma à la gestion des incidents
Une alerte de schéma qui atterrit dans une boîte de réception oubliée ne sert pas à grand-chose. Le signal doit parvenir aux personnes responsables des pipelines, des tableaux de bord et des entrées des modèles.
Un mode de fonctionnement pragmatique ressemble à ceci :
Acheminer les alertes vers les mêmes canaux que les incidents de pipeline : systèmes d’astreinte, notifications de messagerie ou outils de gestion des incidents.
Joindre les définitions avant et après : les ingénieurs ont besoin du diff structurel exact, pas d’un avertissement vague.
Lier les actifs concernés lorsque c’est possible : tableaux de bord, jobs, tables de features et consommateurs en aval.
Exécuter une validation après le changement : vérifiez les jointures critiques, les règles au niveau des lignes et les indicateurs clés après les mises à jour structurelles.
À retenir : si votre équipe sait détecter un job en échec en quelques minutes, mais ne détecte une colonne modifiée qu’au moment où une partie prenante se plaint, votre dispositif de surveillance est incomplet.
Garder un schéma utile
Un bon schéma n’est pas seulement correct. Il est maintenable. Normalisez là où cela améliore l’intégrité et réduit les doublons. Utilisez des conventions de nommage qui résistent au renouvellement des équipes. Évitez d’enfouir une sémantique critique pour le métier dans des champs faiblement typés, alors qu’un modèle approprié rendrait le contrat explicite.
Ne traitez pas la gestion des schémas comme un exercice de conception ponctuel. Dans les systèmes en production, c’est un travail opérationnel continu.
Si les changements de schéma comptent parmi les moyens les plus rapides de casser des pipelines, des tableaux de bord et des entrées de modèles, ils méritent une surveillance de premier plan. digna aide les équipes à suivre les changements structurels en parallèle de la qualité des données, de la ponctualité, de la validation et de la détection d’anomalies, afin que les problèmes de schéma apparaissent avant de se transformer en incidents en aval.
Détecter un changement de schéma n’est que la moitié du travail ; pour vérifier que les jointures critiques et les règles au niveau des lignes tiennent toujours après une mise à jour structurelle, consultez digna Data Validation.
Questions fréquentes
Qu’est-ce qu’un schéma dans une base de données ?
Un schéma est le plan structurel d’une base de données : il définit les tables, les colonnes, les types de données, les contraintes et les relations telles que les clés étrangères, sans contenir les données elles-mêmes. Dans les systèmes relationnels, il s’agit formellement d’un ensemble de contraintes d’intégrité et, en production, il sert aussi de contrat dont dépendent les pipelines, les tableaux de bord et les modèles.
Quelle est la différence entre schémas conceptuels, logiques et physiques ?
Ces trois niveaux ANSI/SPARC échouent chacun à leur manière. Le niveau conceptuel définit des objets métier comme les clients et les commandes, le niveau logique les transforme en entités, clés et relations, et le niveau physique ajoute les types de données, les index et le partitionnement propres à un moteur donné. Une colonne customer_tier déplacée relève du niveau logique ; une partition lente relève du niveau physique.
Qu’est-ce que le schema-on-write et le schema-on-read ?
Avec le schema-on-write, les données doivent correspondre à la structure attendue avant que la base ne les accepte, ce qui convient aux paiements, aux commandes et aux entrepôts de données validés. Le schema-on-read ingère d’abord et applique la structure au moment de la requête, une pratique courante dans les data lakes. Une approche pragmatique accepte la flexibilité à l’ingestion et impose une structure plus stricte à mesure que les données passent dans les couches validées.
Quelle est la différence entre évolution et dérive du schéma ?
L’évolution du schéma est planifiée : une équipe ajoute une colonne pouvant être nulle, publie la migration, met à jour le contrat et coordonne les consommateurs. La dérive du schéma correspond à l’ajout, à la suppression ou à la modification de colonnes sans contrôle de migration. Les deux peuvent sembler identiques au niveau de la table ; la différence tient à la gouvernance, à la visibilité et au fait que les équipes en aval aient pu se préparer ou non.
Pourquoi les changements de schéma cassent-ils les pipelines de données ?
Les jobs en aval supposent que l’ancienne structure est toujours valable : une colonne renommée, un champ supprimé ou un type passé d’entier à chaîne peut faire planter un job ou, pire, le laisser au vert alors que les jointures font correspondre moins de lignes. Cockroach Labs, cité dans l’article, attribue 60 à 70 % des défaillances de pipelines à des changements de schéma inattendus.



