La complétude comme dimension de la qualité des données : un guide pour 2026
|
8
minute de lecture

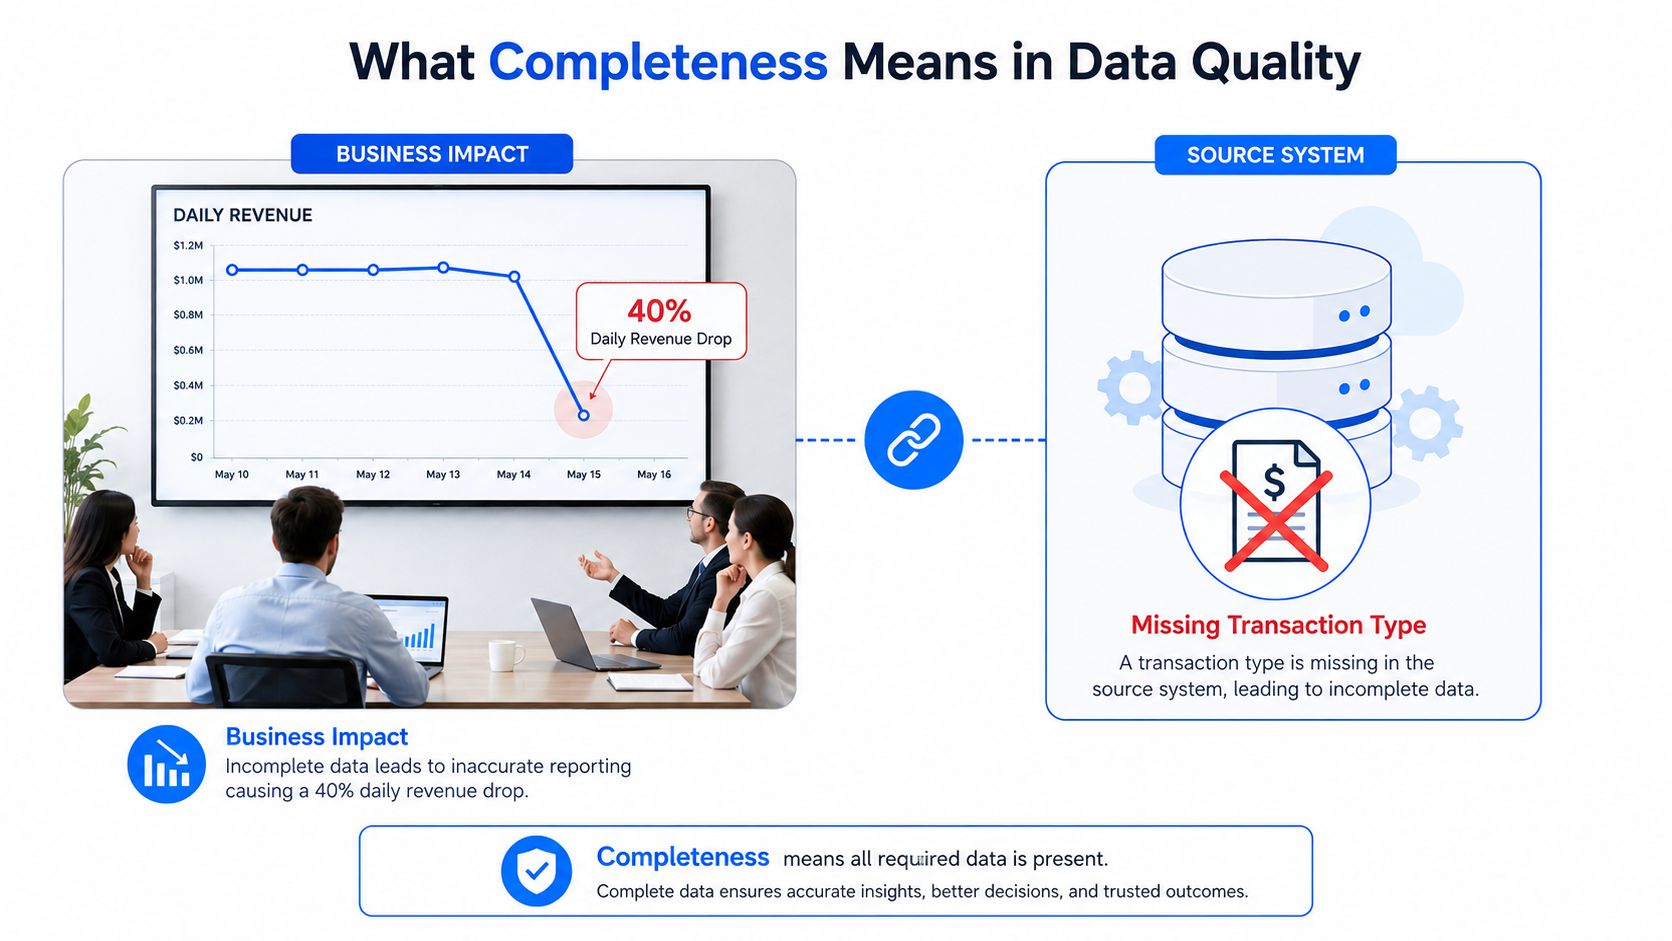
Votre tableau de bord des revenus quotidiens semble normal jusqu'au matin où le total chute brutalement. Le système source est en ligne, le pipeline indique un succès et la plupart des colonnes sont renseignées. Le problème est qu'un type de transaction n'est jamais arrivé, ou qu'un identifiant client a disparu lors d'un export. C'est le genre de défaillance que la complétude de la qualité des données est conçue pour révéler.
La complétude dans la qualité des données consiste à savoir si toutes les données requises pour un usage prévu sont présentes. Cela inclut les valeurs requises à l'intérieur des enregistrements, les enregistrements qui devraient exister mais qui sont manquants, et les volumes de données attendus à travers les fichiers ou les périodes. Un ensemble de données peut ne contenir aucun espace vide évident et être tout de même incomplet si un groupe entier de clients, de transactions ou d'événements a été exclu.
La norme pratique est l'adéquation à l'usage. Un ensemble de données peut être suffisamment complet pour une analyse et incomplet pour une autre, car chaque cas d'usage nécessite des champs, des enregistrements, une couverture et des schémas de diffusion différents. L'explication des dimensions de la qualité des données par le gouvernement britannique fait directement cette distinction, en définissant la complétude par rapport aux données requises pour un usage particulier plutôt qu'à l'alimentation de chaque champ possible.
Table des matières
Ce que signifie la complétude dans la qualité des données
Supposons que le tableau de bord d'une équipe financière affiche une baisse inattendue des revenus. Un analyste vérifie la table des transactions et constate que la plupart des lignes ont des identifiants clients, des dates, des montants et des statuts de paiement. À première vue, la table semble saine. Une comparaison ultérieure révèle que les transactions mobiles étaient absentes du dernier chargement : le rapport manquait donc d'enregistrements valides plutôt que de contenir simplement des cellules vides.
Cette distinction définit la complétude en tant que dimension de la qualité des données. Elle permet de savoir si l'ensemble de données contient tout ce qui est nécessaire pour répondre à son objectif déclaré. La question n'est pas « Toutes les colonnes sont-elles remplies ? » mais plutôt « Ces données incluent-elles les valeurs, les enregistrements et la couverture requis pour la décision que quelqu'un a l'intention de prendre ? »
Pourquoi les valeurs non nulles ne suffisent pas
Une table clients peut présenter un faible taux de valeurs nulles tout en omettant chaque client créé via un canal particulier. Une table de transactions peut contenir des lignes bien formées tout en manquant d'un type d'événement entier. Un fichier quotidien peut avoir des enregistrements complets mais ne représenter qu'une partie de l'activité commerciale attendue.
La complétude s'opère donc bien au-delà du niveau de la cellule :
La complétude des champs permet de savoir si les attributs requis sont renseignés.
La complétude des enregistrements permet de savoir si chaque entité ou événement requis apparaît.
La complétude des fichiers permet de savoir si le fichier, la partition ou le chargement attendu est bien arrivé.
La complétude de la population permet de savoir si l'ensemble de données représente la population réelle concernée, y compris les groupes, les dates et les types de transactions.
L'histoire de ce concept reflète cette vision plus large. La recherche traite la complétude comme un attribut nommé de la qualité des données depuis au moins 1983, date à laquelle Bailey et Pearson l'ont incluse parmi les attributs fondamentaux de la qualité des informations de sortie. Des travaux ultérieurs ont résumé la complétude comme le fait de savoir si toutes les données pertinentes sont enregistrées, tandis que les orientations modernes la structurent autour des besoins d'un usage particulier. Un aperçu utile des concepts de couverture de données par Wine Labs peut aider les équipes à penser au-delà des colonnes renseignées et à examiner si la population visée est bien représentée.
Règle pratique : Définissez ce qui doit être présent avant de calculer si les données sont complètes.
Une définition de travail claire est la suivante : La complétude est la présence de toutes les données requises pour un objectif commercial défini, y compris les valeurs, les enregistrements, les fichiers et la couverture de population nécessaires. Les équipes qui établissent un cadre plus large peuvent également examiner comment les dimensions de la qualité des données sont définies et mesurées.
Les Les trois couches de la complétude
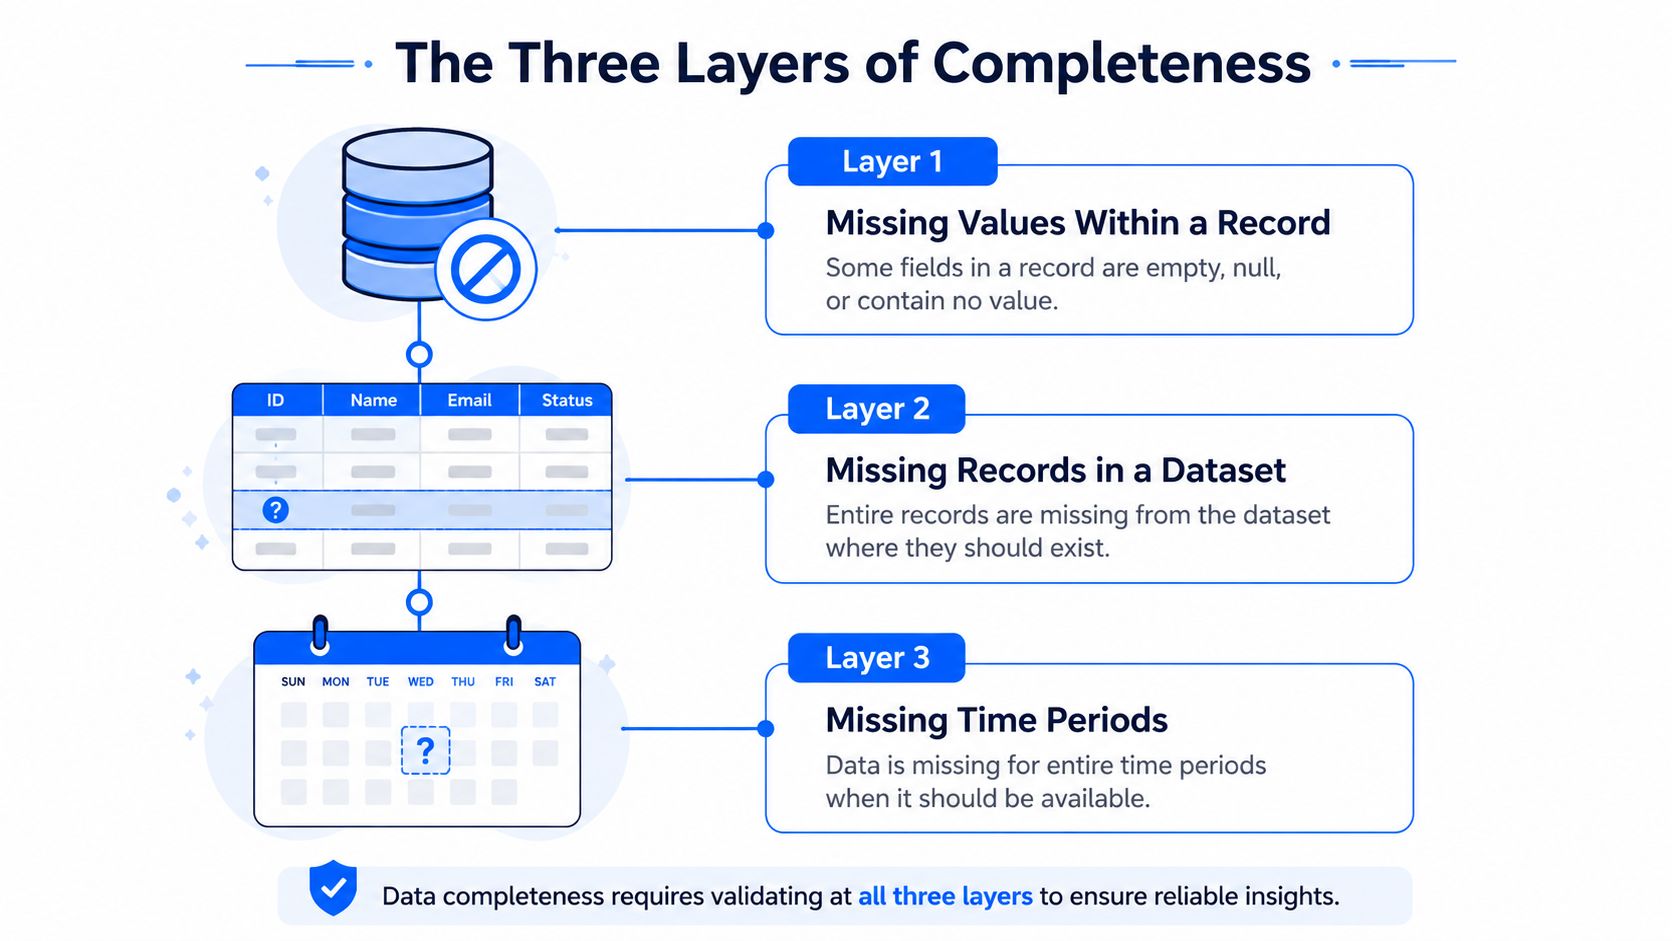
Les équipes traitent souvent la complétude comme un simple exercice de vérification des valeurs nulles. Cela ne permet de détecter qu'une seule couche du problème. Un programme de complétude des données fiable sépare les lacunes à l'intérieur des enregistrements des enregistrements manquants et du manque de couverture sur des périodes ou des volumes attendus.
Pensez à une bibliothèque. Un livre peut être privé de pages, un livre requis peut être absent de l'étagère, ou la bibliothèque peut avoir cessé de cataloguer les nouveautés pendant plusieurs jours. Chaque situation représente un manque de complétude, mais chacune nécessite un test différent.
La première couche est celle des valeurs manquantes
La première couche concerne les attributs au sein d'un enregistrement. Une ligne client peut exister, mais son identifiant client, son code postal, son statut de consentement ou son horodatage de création peut être nul, vide ou remplacé par une valeur par défaut.
Les vérifications des champs requis fonctionnent bien ici. L'équipe identifie les champs nécessaires à une tâche, compte les enregistrements où ces champs sont absents et surveille le résultat au fil du temps. Un code postal manquant peut limiter l'analyse régionale, tandis qu'un identifiant principal manquant peut empêcher complètement les jointures.
Chaque vide n'est pas automatiquement un défaut. Les informations de profil facultatives peuvent être légitimement indisponibles, tandis qu'un identifiant requis pour la résolution d'identité n'est généralement pas facultatif. La définition métier doit primer sur le seuil.
La deuxième couche est celle des enregistrements manquants
La deuxième couche concerne des lignes entières. Un client, une commande, un paiement ou un événement attendu n'atteint jamais la table cible. La validation au niveau de la ligne ne le détectera pas car il n'y a aucune ligne à inspecter.
Les équipes peuvent détecter cela grâce à un rapprochement avec une source faisant autorité, des plages de clés attendues, des inventaires d'événements, des totaux de contrôle ou des comparaisons entre les systèmes amont et aval. Par exemple, si un système de gestion des commandes enregistre un ID de commande mais que la table de l'entrepôt ne le fait pas, l'entrepôt est incomplet même si chaque ligne reçue passe ses vérifications de champ.
La troisième couche est celle des volumes ou de la couverture manquants
La troisième couche concerne la forme de l'ensemble de données à travers le temps, les fichiers, les partitions ou les populations commerciales. Une table d'événements quotidienne peut contenir des lignes valides, mais le chargement peut être nettement inférieur au volume attendu. Une partition peut être absente, un fichier source peut être vide ou un nouveau type d'événement peut cesser de circuler après une modification de schéma.
Cette couche relie la complétude à la ponctualité. Un fichier en retard est incomplet pour un tableau de bord qui doit refléter la dernière période de rapport, même si le fichier finit par arriver. Elle se connecte également à la dérive de schéma. Si une source supprime une colonne ou modifie la structure d'un événement, les processus en aval peuvent perdre les faits nécessaires à un cas d'usage.
Complétude vs Exactitude : comment elles divergent
La complétude et l'exactitude répondent à des questions différentes.
Complétude : Les données requises sont-elles présentes ?
Exactitude : Les données représentent-elles correctement l'entité, l'événement ou la valeur du monde réel ?
Un enregistrement peut être présent mais erroné. Il peut également être correct là où il existe mais manquant dans l'ensemble de données.
Prenons l'exemple d'une table clients utilisée pour associer des clients à des commandes. Chaque adresse e-mail renseignée respecte le format attendu, et les détails clients existants correspondent au système source. Cependant, certains identifiants clients sont nuls. Les valeurs existantes sont peut-être exactes, mais la table est incomplète pour les jointures basées sur l'identité car les identifiants requis sont absents.
Inversons maintenant le problème. Chaque ligne client contient un identifiant client, de sorte que la table semble complète. Mais certains identifiants pointent vers les mauvaises personnes parce qu'un processus de mappage en amont les a mal attribués. L'ensemble de données est complet en termes de présence, mais inexact en termes de signification.
Dimension | Question centrale | Défaillance typique | Contrôle utile |
|---|---|---|---|
Complétude | Toutes les données requises sont-elles présentes ? | Identifiants clients manquants ou transactions absentes | Vérifications des champs requis, rapprochement et contrôles de volume |
Exactitude | Les données reflètent-elles la réalité ? | Un identifiant lié au mauvais client | Comparaison avec une source faisant autorité |
Les deux | Les données requises sont-elles présentes et correctes ? | Un compte manquant ou mal attribué | Contrôles distincts de complétude et d'exactitude |
Les équipes confondent ces dimensions car un vide visible est facile à identifier, tandis qu'une valeur erronée peut sembler parfaitement plausible. Un champ renseigné n'est pas la preuve qu'il est exact, et un sous-ensemble exact n'est pas la preuve que la population totale est présente.
La réponse opérationnelle doit maintenir les contrôles séparés. Les vérifications de complétude recherchent les valeurs nulles, les clés manquantes, les événements absents, les fichiers manquants et les volumes inattendus. Les vérifications d'exactitude comparent les valeurs avec des références fiables, valident les relations d'identité ou testent si les faits métier correspondent à la réalité. Une explication plus large de la Observability des données par rapport à la qualité des données aide à inscrire ces contrôles dans un modèle opérationnel plus vaste.
Métriques, ratios et vérifications des champs requis
La mesure commence par une attente explicite. Avant de calculer un score de complétude, définissez les champs requis, les enregistrements requis, la population concernée, le calendrier de livraison et les variations acceptables pour le cas d'usage.
La métrique la plus simple au niveau du champ est le ratio de complétude :
Ratio de complétude = valeurs requises présentes ÷ valeurs requises attendues
Si une table contient des enregistrements pour lesquels un identifiant client requis doit être présent, comptez les identifiants renseignés et divisez ce nombre par le nombre d'enregistrements censés les contenir. Le résultat peut être exprimé sous forme de ratio ou de pourcentage. La même logique s'applique aux enregistrements, fichiers, partitions ou événements attendus.
Une mesure complémentaire est le taux de valeurs nulles :
Taux de valeurs nulles = valeurs manquantes ÷ valeurs attendues
Un taux de valeurs nulles qui pourrait être tolérable pour un attribut marketing facultatif peut être inacceptable pour une clé primaire. Les seuils doivent refléter les conséquences commerciales, et non un objectif universel. Un e-mail manquant peut réduire la portée d'une campagne, tandis qu'un identifiant de compte manquant peut empêcher le rapprochement, le lignage et les jointures en aval.
Choisir des seuils fixes et adaptatifs
Utilisez un seuil fixe lorsque la règle est inhérente au Data Contract. Une clé primaire peut être requise pour chaque enregistrement accepté, et une valeur manquante doit déclencher une erreur, quel que soit le comportement historique.
Utilisez un seuil adaptatif lorsque la valeur attendue varie selon le calendrier, la saison, le jour, le comportement de la source ou l'activité commerciale. Les bases historiques permettent d'identifier une baisse inhabituelle des enregistrements quotidiens sans obliger les ingénieurs à maintenir un chiffre distinct pour chaque période.
Une conception de surveillance pratique combine les deux approches :
Les vérifications de champs requis identifient les valeurs manquantes dans les colonnes critiques.
Le rapprochement d'enregistrements identifie les entités ou événements attendus qui ne sont jamais arrivés.
Les contrôles de volume comparent les nombres observés avec les plages attendues.
Les contrôles de distribution identifient les changements qui peuvent indiquer une population partielle ou une catégorie supprimée.
Le suivi des tendances montre si un problème de complétude est stable, en voie d'amélioration ou en train de s'aggraver.
Le tableau ci-dessous associe les contrôles courants aux capacités de mise en œuvre.
Dimension | Métrique | Exemple de contrôle | Capacité digna |
|---|---|---|---|
Complétude des champs | Taux de valeurs nulles par champ requis | L'identifiant client est présent pour chaque enregistrement client requis | Data Validation |
Complétude des enregistrements | Nombre de clés manquantes | Les ID de commande de la source sont absents de l'entrepôt de données | Data Validation |
Complétude des fichiers | Statut d'arrivée ou de chargement | La partition de transaction planifiée est manquante | Data Anomalies |
Complétude des volumes | Nombre d'enregistrements observés vs attendus | Le volume d'événements quotidiens est anormalement bas | Data Anomalies |
Complétude de distribution | Couverture des catégories ou des événements | Un type de transaction disparaît du dernier chargement | Data Anomalies |
Complétude des tendances | Ratio de complétude au fil du temps | La couverture des champs requis diminue au fil des chargements successifs | Data Analytics |
Les équipes peuvent étendre ce modèle grâce aux métriques de qualité des données et aux pratiques de mesure. L'important est de mesurer le niveau auquel la défaillance se produit. Un score global unique peut masquer une population manquante : signalez donc séparément les métriques de champs, d'enregistrements, de fichiers et de volumes.
Exemples concrets de données d'entreprise incomplètes
Les problèmes de complétude apparaissent généralement d'abord sous la forme d'un symptôme métier. Un modèle perd son pouvoir prédictif, un total de revenus semble bas, ou un tableau de bord opérationnel signale une baisse invraisemblable. La cause technique se situe souvent plus haut dans le pipeline.
Un export CRM perd les identifiants clients
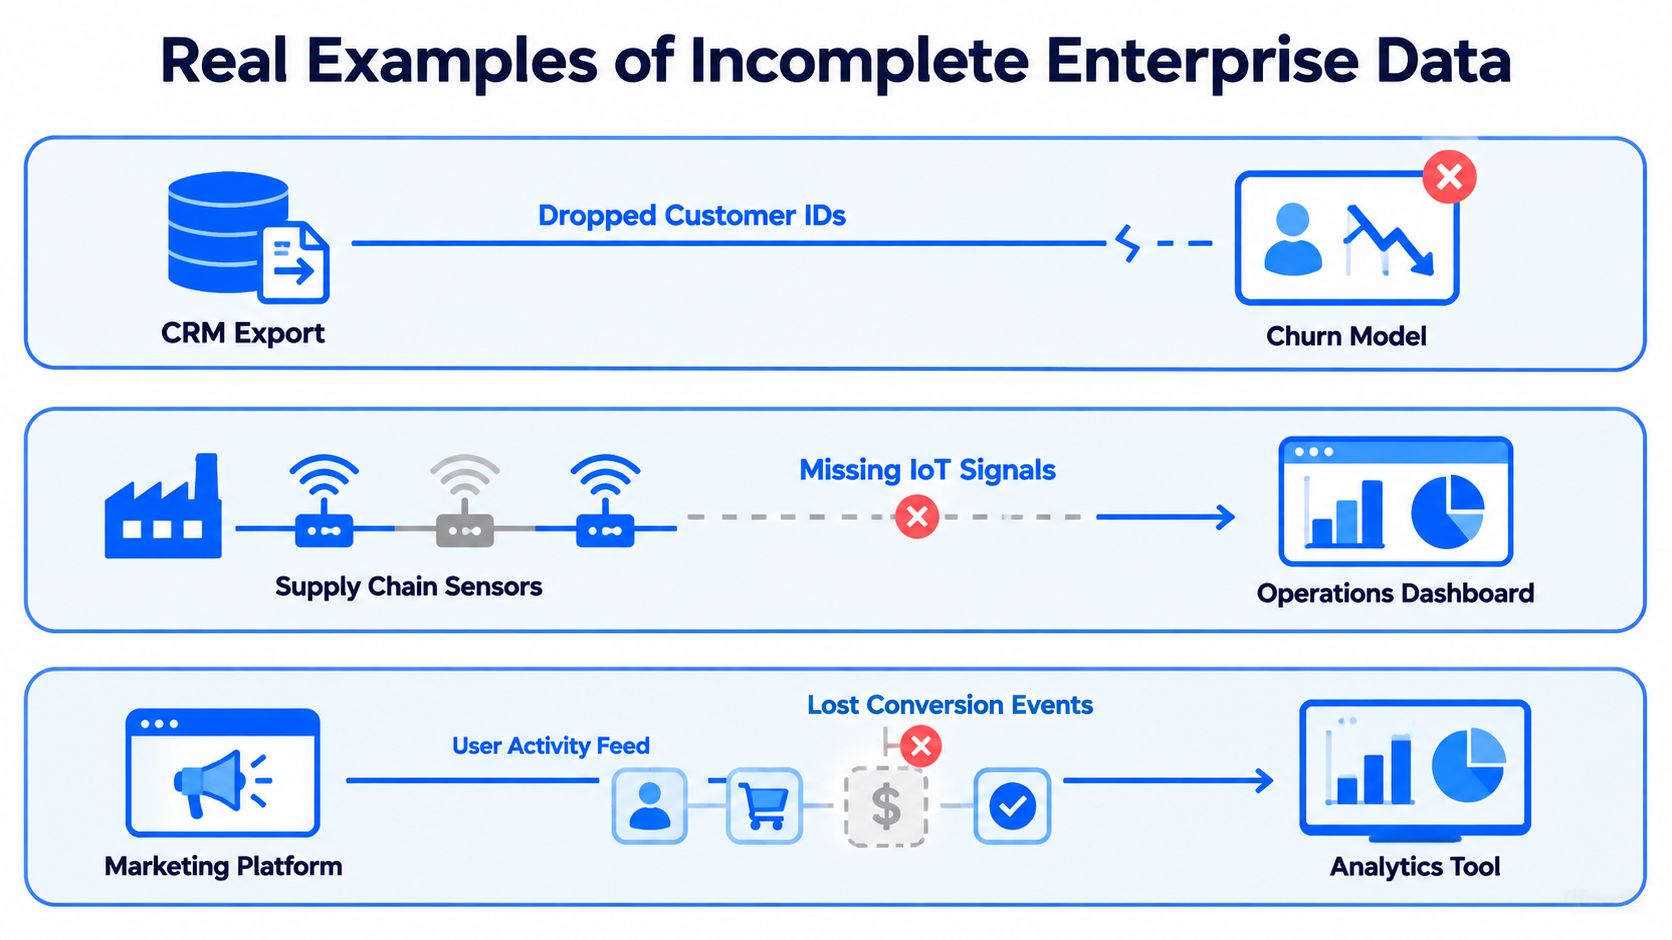
Un export CRM contient les nouvelles inscriptions mobiles, mais le champ de l'identifiant client est vide pour ce groupe. Les lignes sont présentes, et les noms ainsi que les adresses e-mail peuvent sembler valides, pourtant le processus de résolution d'identité ne peut pas associer de manière fiable ces clients à des commandes, à l'historique d'assistance ou à une activité antérieure.
L'entreprise constate une rupture dans l'analyse de l'attrition ou une augmentation inexpliquée des clients non identifiés. Une règle de champ requis sur l'identifiant client permettrait de détecter le défaut au niveau de l'enregistrement. Une comparaison de population par canal d'acquisition révélerait que le problème affecte un groupe spécifique plutôt que l'ensemble de l'export.
Un flux de paiement laisse des transactions inachevées
Un processeur de paiement continue d'envoyer des lignes de transaction, mais certains paiements restent marqués comme en attente indéfiniment. La table semble alimentée, mais le processus de revenus de fin de mois ne peut pas traiter ces transactions comme réglées ni les inclure dans le résultat financier attendu.
La lacune de complétude n'est pas simplement une valeur nulle. Le cycle de vie requis de la transaction est incomplet pour l'objectif du rapport. Les contrôles doivent comparer les états de transaction attendus et les totaux de rapprochement, tandis que la surveillance de la ponctualité doit identifier les enregistrements qui ne progressent pas dans la fenêtre opérationnelle définie.
Un chargement d'événements partitionné écrit beaucoup moins de lignes
Un traitement par lots quotidien produit normalement une grande table d'événements. Un jour, un chargement partitionné échoue et seul un petit sous-ensemble de lignes atteint l'entrepôt de données. Les lignes survivantes passent les vérifications de schéma et de champs requis : un test au niveau de la ligne signale donc à lui seul un succès.
Le premier symptôme visible peut être un tableau de bord d'activité bas ou un segment manquant dans un modèle d'analyse. Un contrôle de volume prenant en compte le calendrier comparerait le nombre observé au comportement historique et signalerait le chargement pour investigation. La surveillance de la distribution pourrait alors montrer quel type de source, de date ou d'événement a disparu.
Ces exemples partagent une leçon : les données incomplètes ne semblent pas toujours corrompues à l'intérieur des lignes qui sont arrivées. La surveillance doit tester ce qui aurait dû arriver, et non seulement ce qui est actuellement stocké.
Comment digna prend en charge la complétude des données
Un programme de complétude a besoin à la fois de règles déterministes et d'une surveillance comportementale. Le bon choix dépend du fait que l'attente soit explicite, comme « l'identifiant client est requis », ou apprise à partir du comportement récurrent des données, comme un changement inhabituel du volume quotidien.
digna Data Validation
digna Data Validation applique des contrôles au niveau de l'enregistrement par rapport aux règles métier. Une équipe peut définir des contrôles de champs requis pour les identifiants clients, les dates de transaction, les clés de compte ou d'autres attributs nécessaires à un workflow spécifique. Le module peut également prendre en charge des vérifications ciblées pour les valeurs vides et les conditions métier qui déterminent si un enregistrement est utilisable.
C'est le contrôle le plus clair pour la première couche de la complétude, à savoir les valeurs manquantes au sein des enregistrements. Il peut également prendre en charge la logique de complétude au niveau de l'enregistrement, où une ligne doit contenir une combinaison définie de valeurs avant d'être acceptée pour un usage en aval.
digna Data Anomalies
digna Data Anomalies surveille les changements inattendus dans le nombre d'enregistrements, les taux de valeurs nulles et les distributions. Son approche d'apprentissage des comportements de référence est adaptée aux données qui varient naturellement, là où une seule limite fixe créerait des alertes inutiles.
Cela permet de traiter les enregistrements manquants et les volumes manquants. Une réduction inattendue du nombre de lignes quotidiennes, la disparition d'une catégorie de transaction ou une augmentation soudaine des valeurs nulles peuvent faire l'objet d'une enquête pour détecter un éventuel chargement partiel, une interruption de la source ou une modification du pipeline. Le module permet également de mettre en évidence des schémas qui n'étaient pas couverts par des règles écrites manuellement.
digna Data Analytics
digna Data Analytics fournit une analyse historique des métriques de complétude. Un taux de valeurs nulles actuel a peu de sens sans contexte. Les vues historiques aident les équipes à distinguer une caractéristique stable d'une détérioration récente, et à identifier si un problème de chargement récurrent devient plus fréquent.
Les modules peuvent être associés aux trois couches :
Valeurs manquantes : Data Validation vérifie les champs requis et les conditions des enregistrements.
Enregistrements manquants : Validation et surveillance des anomalies comparent la couverture attendue et observée.
Volumes ou périodes manquants : Data Anomalies surveille les volumes, les distributions et le comportement de chargement, tandis que Data Analytics montre la tendance.
digna effectue le calcul des métriques et l'analyse directement dans l'environnement de base de données du client, de sorte que les données restent en place. Le déploiement peut s'effectuer au sein d'un cloud privé, d'un VPC ou d'un centre de données, ce qui convient aux équipes qui ont besoin d'une surveillance de la complétude sans avoir à transférer les données de production vers un service externe.
La conception pratique est modulaire. Une équipe peut commencer par des règles explicites de champs requis, ajouter la détection d'anomalies pour les changements inattendus et utiliser les analyses historiques pour réguler les seuils et les mesures correctives. Le suivi des schémas et les contrôles de ponctualité peuvent compléter cette configuration lorsque des colonnes supprimées ou des chargements tardifs créent indirectement des échecs de complétude.
Cadence de surveillance, gouvernance et questions fréquentes
La surveillance de la complétude fonctionne mieux lorsque chaque contrôle s'exécute au moment précis où sa défaillance a un impact. Les vérifications de champs requis doivent s'exécuter sur chaque chargement pertinent. Les vérifications de volume doivent s'exécuter selon le calendrier de livraison de l'ensemble de données. La détection d'anomalies doit évaluer le comportement en continu ou à chaque fois que de nouvelles données arrivent.
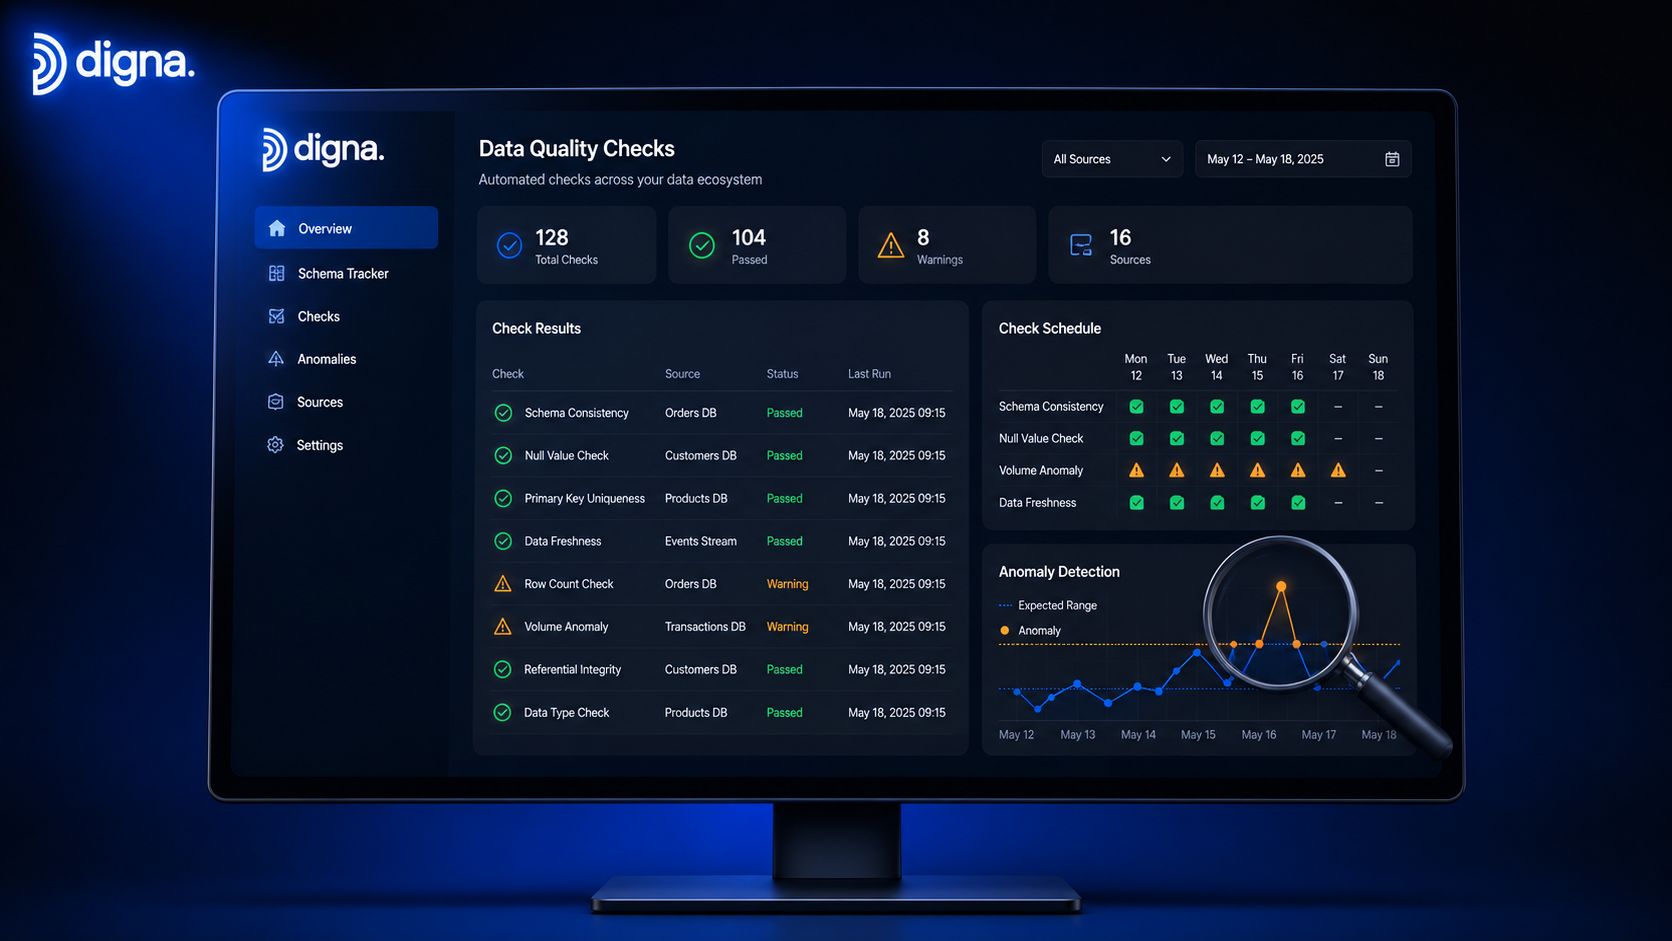
Attribuez la responsabilité avant que les alertes ne commencent. Les ingénieurs de données peuvent enquêter sur les chargements ayant échoué, les data stewards peuvent définir quels champs et populations sont requis, et les responsables métier peuvent décider si un écart bloque un rapport ou nécessite un simple avertissement. Utilisez des règles de gravité et d'aiguillage pour éviter que les équipes ne reçoivent des alertes pour chaque variation inoffensive.
Foire aux questions
Qu'est-ce que la complétude dans la qualité des données ?
La complétude désigne le fait que toutes les données requises pour un usage prévu soient présentes. Elle comprend les valeurs requises, les enregistrements attendus, les fichiers concernés, les périodes et la couverture de la population.
Comment mesure-t-on la complétude des données ?
Mesurez les valeurs requises présentes par rapport aux valeurs requises attendues, calculez les taux de valeurs nulles par champ, rapprochez les enregistrements source et cible, et comparez les volumes observés avec les plages attendues. Utilisez des métriques distinctes pour les champs, les enregistrements, les fichiers et les populations.
Quelles sont les métriques de complétude utiles ?
Les métriques utiles incluent le taux de valeurs nulles des champs requis, le ratio de complétude, le nombre de clés manquantes, le rapprochement source-cible, le statut d'arrivée des fichiers, l'écart de volume d'enregistrements et la couverture des catégories ou des événements.
Qu'est-ce qu'un bon seuil de complétude ?
Il n'existe pas de seuil universel. Définissez la limite en fonction du rôle du champ, de l'usage prévu et des conséquences de données manquantes. Un identifiant principal nécessite généralement un traitement plus strict qu'un attribut descriptif facultatif.
Comment surveiller la complétude en continu sans subir la fatigue des alertes ?
Combinez des règles fixes pour les exigences essentielles avec des bases de référence adaptatives pour les volumes changeants. Regroupez les alertes associées, attribuez des responsables, documentez les exceptions attendues et examinez les tendances historiques avant de resserrer les seuils.
En quoi la complétude diffère-t-elle de l'exactitude ?
La complétude permet de savoir si les données requises existent. L'exactitude permet de savoir si les données reflètent la réalité. Un ensemble de données peut être complet mais erroné, ou exact là où il est renseigné tout en manquant d'enregistrements importants.
Une brève démonstration visuelle peut aider les équipes à relier ces pratiques à la surveillance quotidienne :
Commencez par lister les données requises par votre rapport, modèle ou processus opérationnel le plus important. Ajoutez ensuite des vérifications de champs, des rapprochements d'enregistrements, une surveillance des volumes et une analyse historique à la cadence appropriée, plutôt que de vous fier à un unique score de complétude.
digna propose Data Validation, Data Anomalies et Data Analytics pour aider les équipes à appliquer les règles de champs requis, à détecter les changements inattendus dans les volumes et les taux de valeurs nulles, et à surveiller les tendances de complétude au fil du temps au sein de leur propre environnement. Visitez digna pour explorer une approche modulaire de la qualité et de l'Observability des données.