Technique de simulation de Monte-Carlo : Un guide pratique
|
7
minute de lecture
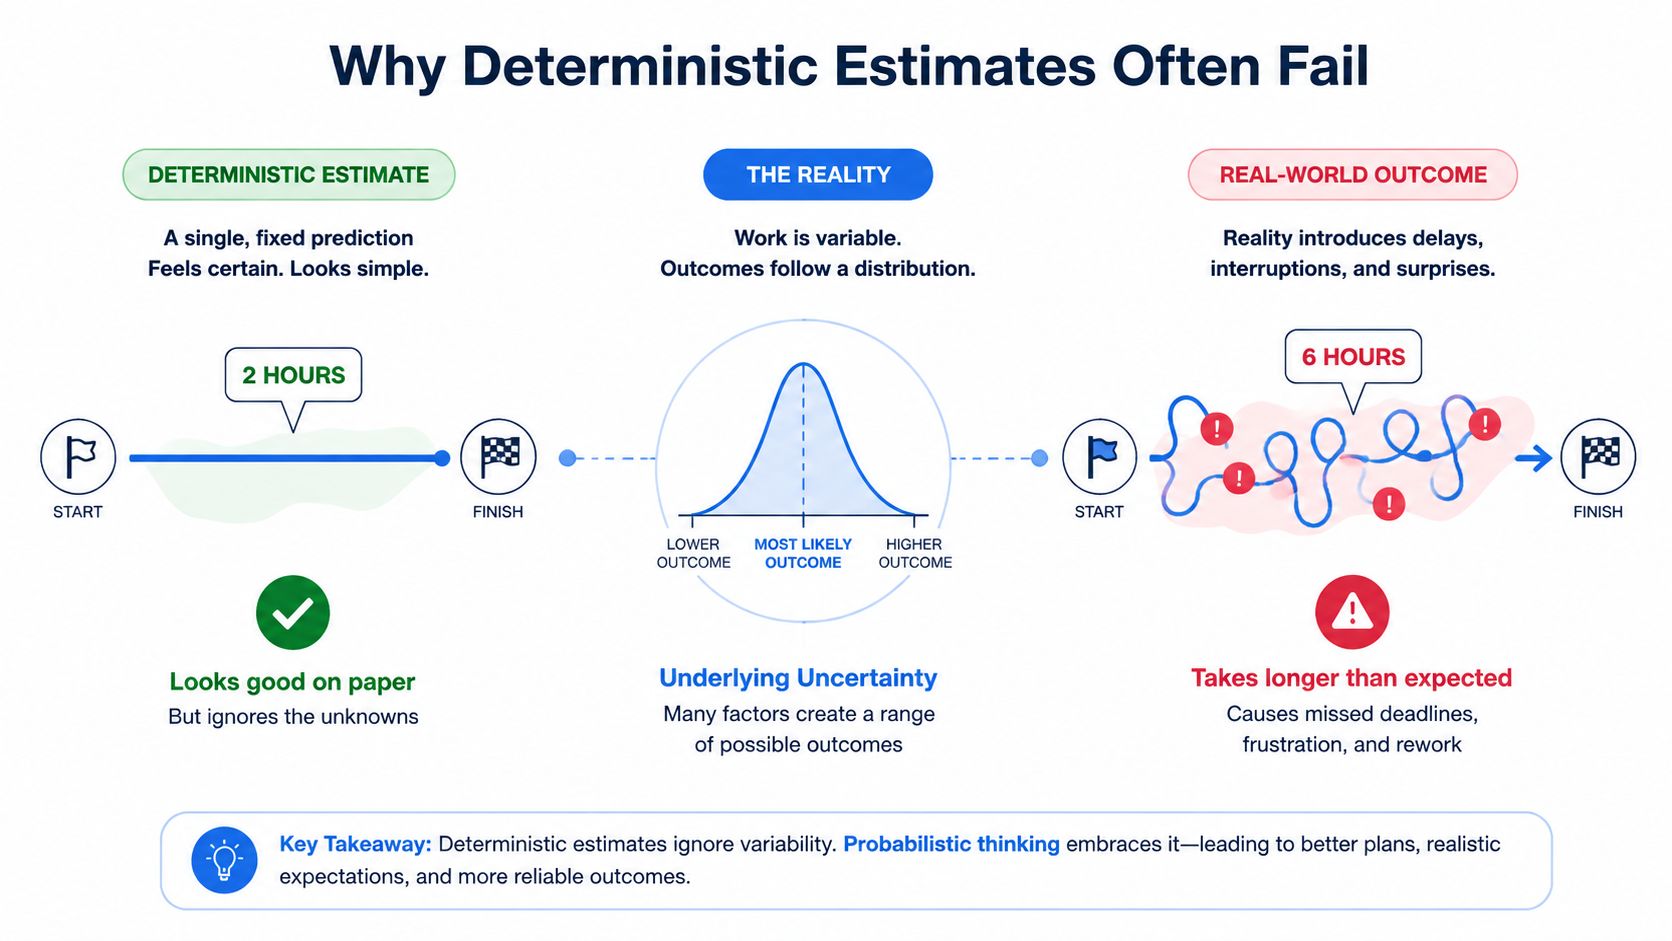
Votre tâche ETL actualise généralement la table client en deux heures environ. Ce matin, alors qu'une réunion du conseil d'administration approche, cette même actualisation est toujours en cours après six heures. Les tableaux de bord sont passés au rouge, les rapports en aval sont obsolètes et l'ingénieur d'astreinte vérifie simultanément la charge du cluster, les journaux d'API et les files d'attente de l'entrepôt.
Le problème n'est pas que l'équipe a oublié comment estimer. Le problème est qu'une estimation unique masquait les conditions qui pouvaient ralentir la tâche. La méthode de simulation de Monte-Carlo rend ces conditions explicites, échantillonne leur incertitude et transforme une réponse assurée en une distribution de résultats possibles.
Table des matières
Pourquoi les estimations déterministes échouent souvent
Une estimation ponctuelle masque la dispersion
L'idée fondamentale derrière la méthode de simulation de Monte-Carlo
Pourquoi la répétition aide
La boucle de simulation
Algorithmes et pseudocode réutilisables
Pseudocode générique
Modèles à réutiliser
Implémentation de Monte-Carlo en Python, R et SQL
Python avec NumPy
R avec replicate
SQL au sein de l'entrepôt de données
Cas d'usage en qualité des données, Observability et gestion des risques
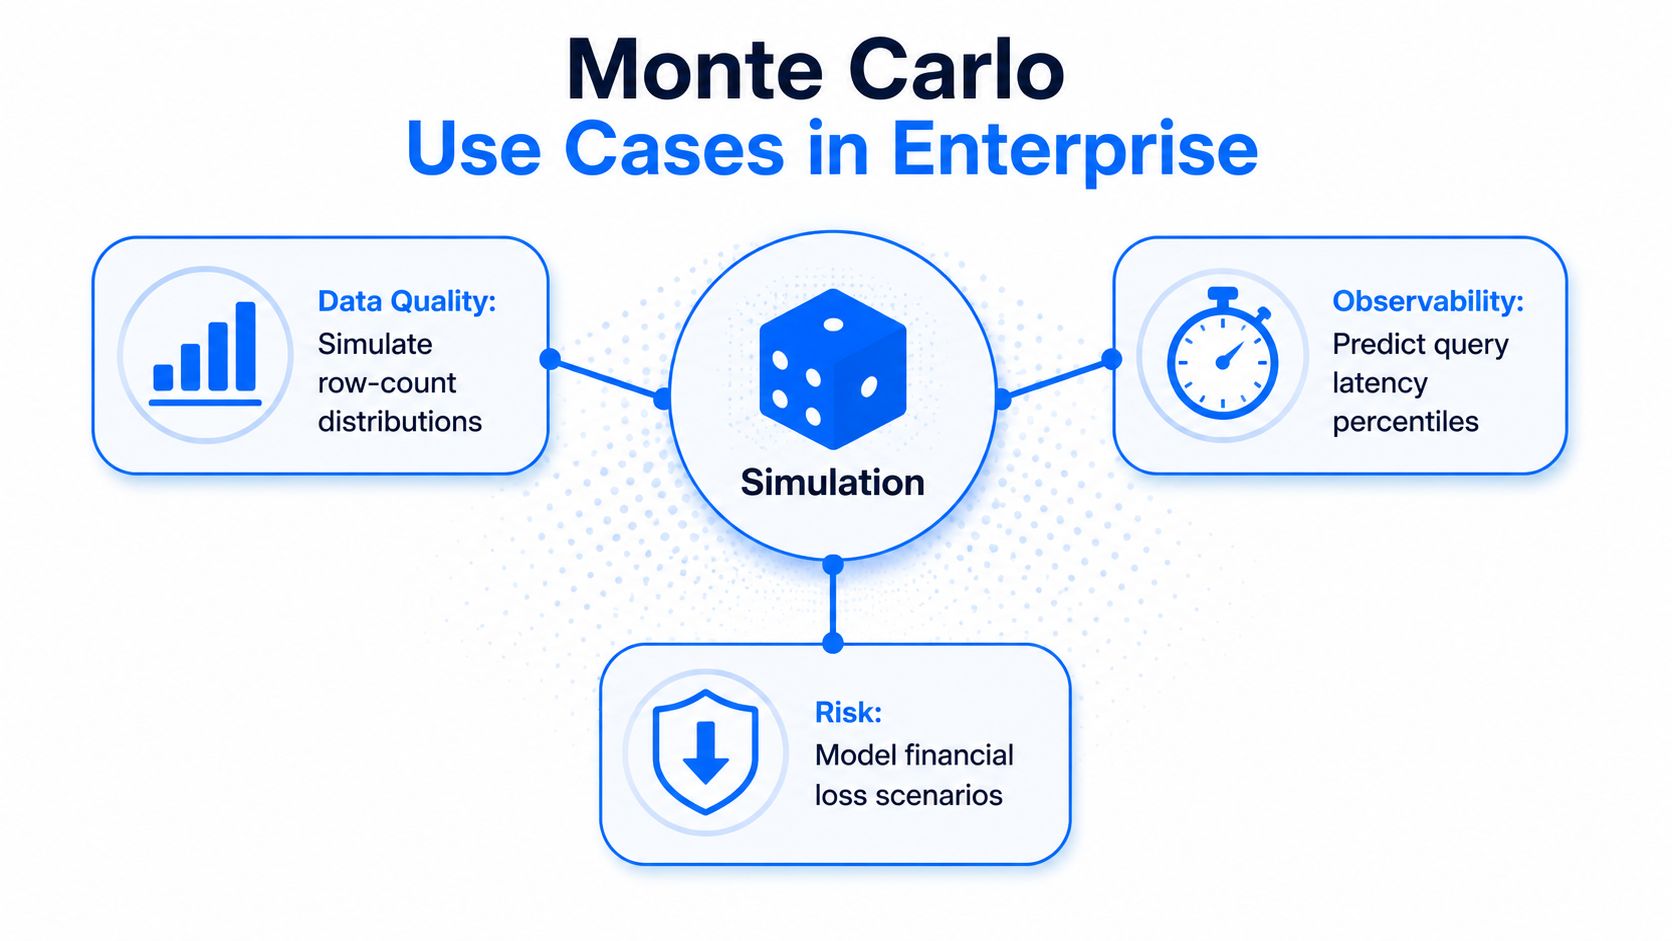
Détection d'anomalies de nombre de lignes
Risque de fraîcheur de pipeline (Timeliness)
Pertes financières et opérationnelles
Pièges et bonnes pratiques à éviter
L'aléa n'est pas automatiquement indépendant
La convergence nécessite des preuves
Mettre en œuvre Monte-Carlo dans une plateforme de données d'entreprise
Une conception opérationnelle pratique
Pourquoi les estimations déterministes échouent souvent
Une estimation déterministe prend des entrées fixes et produit un résultat fixe. Pour une actualisation ETL, cela pourrait signifier supposer une taille de charge utile connue, une latence en amont prévisible et une capacité de calcul stable. La promesse qui en résulte semble claire : la table client sera prête en deux heures.
Cette promesse n'est utile que lorsque les entrées sont suffisamment stables pour la justifier. En production, la contention du cluster peut varier pendant l'exécution, une API en amont peut répondre lentement et la charge utile entrante peut être beaucoup plus volumineuse que d'habitude. Un pipeline qui se termine normalement rapidement peut rencontrer une combinaison inhabituelle de conditions et manquer largement son attente de fraîcheur (Timeliness).
Une estimation ponctuelle masque la dispersion
Supposons qu'un ingénieur enregistre la durée de chaque actualisation réussie. La question utile n'est pas seulement : « Quelle durée devons-nous prévoir ? » C'est aussi :
Comportement typique : Combien de temps prend généralement l'actualisation ?
Variation opérationnelle : Quelle est la dispersion des durées ?
Comportement extrême (tail behavior) : À quelle fréquence la tâche s'exécute-t-elle avec un retard inhabituel ?
Seuil de décision : À quel niveau de probabilité l'équipe doit-elle être alertée ?
Une distribution de probabilité décrit ce comportement de manière beaucoup plus précise qu'une durée unique. Elle offre à l'équipe un moyen de distinguer une variation ordinaire d'un événement qui mérite investigation. Pour une approche pratique de cette idée, découvrez ce que représente une distribution de données.
L'aléa ne signifie pas automatiquement de mauvaises données. Une part d'aléa reflète de réelles conditions opérationnelles. L'ordonnanceur de l'entrepôt de données, le réseau, le système source et la charge de travail contribuent tous à la variation que le pipeline doit tolérer. Ignorer cette variation ne la supprime pas. Cela ne fait que déplacer l'incertitude vers un incident.
Règle pratique : Si une décision dépend d'une plage de résultats plausibles, modélisez directement cette plage au lieu de la masquer derrière une moyenne.
Un SLA déterministe peut toujours être utile en tant que contrat, mais il ne doit pas être confondu avec une prévision complète. Le contrat énonce ce que l'entreprise attend. Un modèle probabiliste estime la fréquence à laquelle la plateforme est susceptible de le respecter dans les conditions observées.
La méthode de simulation de Monte-Carlo traite la dispersion comme une entrée, pas comme un ennemi.
L'idée fondamentale derrière la méthode de simulation de Monte-Carlo
La méthode devient beaucoup plus simple une fois que l'on garde trois objets en tête. Premièrement, chaque entrée incertaine possède une distribution de probabilité. Deuxièmement, la simulation effectue un tirage aléatoire à partir de chaque distribution. Troisièmement, un modèle combine ces tirages et produit un résultat unique.
Pour un pipeline de données, les entrées peuvent inclure le temps d'extraction de la source, le temps de transformation, le délai d'attente de l'entrepôt et le temps de publication final. Le modèle pourrait additionner ces durées, ou inclure une logique de branchement, des tentatives de réexécution, des tâches parallèles et des règles de dépendance. Le modèle structurel reste identique tandis que les entrées échantillonnées changent d'une itération à l'autre.

Pourquoi la répétition aide
Un seul tirage aléatoire ne vous apprend presque rien. Il peut se situer près du centre de la distribution ou bien dans une extrémité (tail). La répétition du processus fournit à la distribution de sortie suffisamment d'observations pour révéler sa forme.
C'est l'intuition derrière la loi des grands nombres. Les échantillons individuels restent bruités, mais le comportement global devient plus stable à mesure que le nombre d'échantillons indépendants augmente. Imaginez d'abord un histogramme brut dont les barres oscillent. À mesure que de nouvelles itérations s'ajoutent, les barres se lissent et la tendance centrale devient plus facile à distinguer.
Le résultat n'est pas une certitude. C'est une approximation plus fiable du modèle impliqué par vos entrées.
La boucle de simulation
Chaque itération suit le même cycle :
Échantillonner les entrées : Tirer une valeur de chaque distribution d'entrée.
Exécuter le modèle : Injecter ces valeurs dans l'agrégation ou la logique métier.
Stocker le résultat : Conserver la durée, la perte, le nombre de lignes ou toute autre métrique résultante.
Répéter le processus : Continuer jusqu'à ce que le résultat soit suffisamment stable pour la prise de décision.
Synthétiser les résultats : Analyser la moyenne, les percentiles et la probabilité de dépasser un seuil.
La distribution de sortie répond à des questions qu'une estimation ponctuelle ne peut résoudre. Vous pouvez demander combien de temps prend généralement une actualisation, quel est le retard maximal plausible, ou quelle est la probabilité qu'un tableau de bord ne respecte pas son contrat de fraîcheur (Timeliness).
Pour une vision axée sur l'ingénierie des données de ce workflow, l'article Méthodes de Monte-Carlo pour une meilleure Data Observability fait le lien entre l'échantillonnage répété et la supervision opérationnelle.
La technique offre trois promesses pratiques : des réponses distributionnelles, une visibilité sur le risque extrême (tail risk), et une variabilité reproductible lorsque le générateur d'aléa est contrôlé. L'algorithme ci-dessous traduit ces promesses en étapes d'implémentation réutilisables.
Algorithmes et pseudocode réutilisables
Commencez par l'algorithme, pas par le langage de programmation. Le langage n'est que la machinerie utilisée pour exécuter la boucle.
Pseudocode générique
La séparation importante s'effectue entre l'échantillonnage et la modélisation. L'échantillonnage répond à : « Quelles valeurs d'entrée plausibles cette itération doit-elle utiliser ? ». Le modèle répond à : « Quel résultat découle de ces valeurs ? ». Mélanger ces responsabilités rend les tests et le débogage plus difficiles.
Un exemple pratique en Python peut estimer la probabilité que la somme des durées de trois tâches log-normales dépasse un SLA de quatre heures. La distribution convient pour un modèle de durée positif et asymétrique à droite, mais les paramètres ci-dessous sont des exemples illustratifs pour une démonstration et non des estimations de production.
Modèles à réutiliser
Échantillonnage vectorisé :
numpy.random.default_rnggénère des tableaux efficacement au lieu de forcer Python à gérer chaque tirage dans une boucle lente.Aléatoire contrôlé : Un
seedrend une exécution reproductible, ce qui est essentiel lorsqu'un ingénieur doit expliquer une alerte ou comparer des versions de modèles.Visibilité de la progression : Pour un modèle délibérément itératif ou dépendant du chemin, enveloppez la boucle avec
tqdmafin qu'un traitement long expose sa progression.
Les lecteurs passant d'ébauches d'algorithmes à du code Python fonctionnel peuvent utiliser ces exemples de pseudocode vers Python comme référence pour traduire proprement la logique.
Vous pourrez explorer ultérieurement les variables antithétiques et les variables de contrôle comme techniques de réduction de la variance. Elles ne sont pas requises pour un premier modèle, mais elles peuvent réduire le bruit de simulation lorsque chaque exécution est coûteuse. Pour les workflows d'anomalies, ces mêmes synthèses de résultats peuvent alimenter la détection d'anomalies de données en Python.
Implémentation de Monte-Carlo en Python, R et SQL
Une même simulation ne devient pas mathématiquement différente parce qu'elle passe de Python à R ou à SQL. L'arbitrage est opérationnel : où l'échantillonnage doit-il avoir lieu, où le modèle doit-il s'exécuter et où les résultats seront-ils consommés ?
Python avec NumPy
Python est généralement l'environnement le plus rapide pour prototyper. NumPy gère l'échantillonnage vectorisé, l'extraction des percentiles y est simple, et l'écosystème environnant facilite l'ajustement des distributions, le tracé des diagnostics et le test du comportement des modèles.
R avec replicate
R est un choix judicieux lorsque le travail est axé sur l'analyse statistique et la visualisation. replicate() rend l'évaluation répétée lisible, tandis que des packages tels que dplyr permettent de structurer les synthèses après la simulation.
SQL au sein de l'entrepôt de données
SQL s'impose lorsque la simulation dépend de données déjà stockées dans l'entrepôt de données. Extraire de grands volumes d'historique vers Python ajoute des transferts réseau, de la pression mémoire et une frontière d'exécution supplémentaire. Une implémentation dans l'entrepôt de données peut lier les enregistrements historiques de durée à une table de référence aléatoire, calculer les résultats simulés au plus près des données sources et conserver les synthèses sans exporter de lignes brutes.
La fonction aléatoire exacte différant selon la base de données, isolez-la derrière une fonction intermédiaire. Une CTE récursive peut générer les identifiants d'itération, tandis qu'une jointure avec les lignes de référence échantillonnées fournit les valeurs d'entrée. Pour les contrôles quotidiens de volumétrie à haut débit, cela permet de maintenir les calculs à proximité des partitions testées.
Dimension | Python (NumPy) | R | SQL (en base de données) |
|---|---|---|---|
Idéal pour | Prototypage et services réutilisables | Analyse statistique et visualisation | Simulations proches des données de l'entrepôt |
Force principale | Vectorisation et larges bibliothèques | Workflow statistique expressif | Moins de mouvements de données |
Impact mémoire | Les grands tableaux peuvent saturer la mémoire de travail | La réplication peut créer des objets volumineux | Charge de travail de l'entrepôt et risque de saturation disque |
Reproductibilité | Définir la graine (seed) explicitement | Définir la graine aléatoire explicitement | Dépend des fonctions de base de données et du plan d'exécution |
Choix opérationnel | Utiliser pour des modèles complexes ou dépendants du chemin | Utiliser pour des travaux guidés par l'analyse | Utiliser pour des contrôles simples à haut volume |
Un service Python peut également s'appuyer sur le Python SDK digna lorsque le workflow global doit connecter les résultats de la simulation avec la supervision de la plateforme. La décision doit découler de la localisation des données et de la complexité du modèle, et non des seules préférences de l'équipe.
Cas d'usage en qualité des données, Observability et gestion des risques
La méthode de Monte-Carlo prend toute sa valeur dans une plateforme de données lorsqu'un seuil fixe s'avère trop rigide. Un nombre de lignes peut être normal sur une période opérationnelle et suspect sur une autre. Un pipeline peut être en retard en raison d'une charge de travail inhabituelle mais tout à fait légitime. Une distribution de pertes dues à la fraude peut sembler inoffensive en son centre tout en présentant une exposition significative dans son extrémité (tail).
Détection d'anomalies de nombre de lignes
Commencez avec les volumes historiques de partitions horaires ou quotidiennes. Au lieu de définir des seuils min et max fixes, ajustez une distribution qui reflète le volume normal pour la période concernée, le type de jour ou le comportement de la source. Simulez les volumes attendus et comparez la partition observée avec la plage ainsi obtenue.
La réaction doit dépendre du seuil de décision. Un nombre situé en dehors de la plage attendue peut déclencher une investigation, tandis qu'un nombre situé loin dans l'extrémité de la distribution simulée peut générer un incident de priorité supérieure. Cette approche permet de détecter des pics et des chutes inhabituels qu'une plage statique trop large ignorerait.
Risque de fraîcheur de pipeline (Timeliness)
Pour les aspects temporels, la distribution d'entrée correspond à la durée historique d'une étape ou au retard d'arrivée. Le modèle combine ces délais échantillonnés avec la chaîne de dépendances planifiée et évalue si le tableau de bord en aval sera prêt avant l'échéance de son contrat de fraîcheur.
Cela produit une probabilité opérationnelle plutôt qu'une vague alerte. Si le risque simulé de retard franchit le seuil configuré par l'équipe, la plateforme peut alerter le propriétaire de la donnée avant qu'un utilisateur ne remarque des données obsolètes. Les ingénieurs peuvent alors inspecter l'étape la plus lente au lieu d'attendre l'échec final du tableau de bord.
Pertes financières et opérationnelles
La même mécanique s'applique aux baisses de revenus, aux pertes dues à la fraude ou à l'exposition d'un portefeuille. La distribution d'entrée peut provenir d'observations historiques de pertes, de rendements financiers modélisés ou d'un scénario de crise (stress test) délibéré. Le résultat est une distribution des pertes, à partir de laquelle une équipe de gestion des risques peut inspecter un percentile ou évaluer la probabilité de dépasser une tolérance définie.
Un percentile n'est pas une garantie. C'est un indicateur basé sur les hypothèses et le processus d'échantillonnage utilisés pour le produire.
La dérive de schéma (schema drift) suit le même principe. Échantillonnez les taux de valeurs nulles ou les changements de types sur des jeux de données comparables, puis signalez un nouveau taux observé qui s'écarte anormalement dans la distribution simulée. Cela peut révéler une rupture silencieuse même si le pipeline arrive techniquement à son terme.
Pièges et bonnes pratiques à éviter
Un code Monte-Carlo peut s'exécuter avec succès tout en fournissant une réponse trompeuse. Les défaillances en production proviennent généralement des hypothèses, des dépendances ou des diagnostics, plutôt que de la boucle elle-même.
L'aléa n'est pas automatiquement indépendant
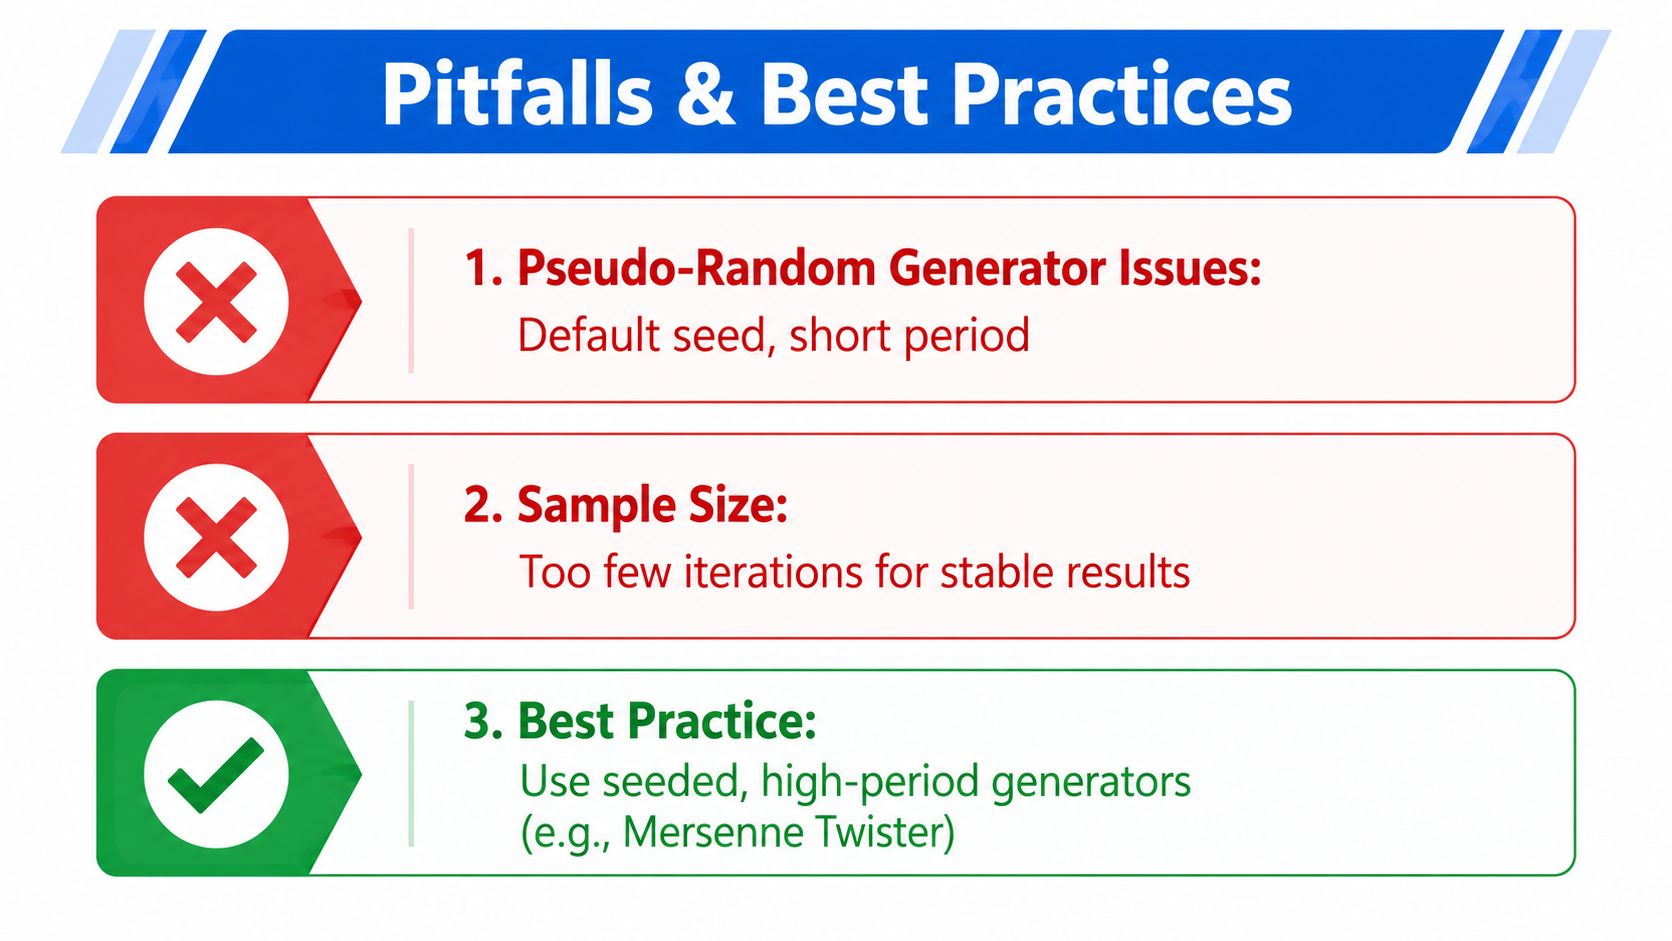
Un générateur pseudo-aléatoire est un mécanisme déterministe conçu pour imiter un échantillonnage aléatoire. Des valeurs par défaut inadaptées, des périodes trop courtes ou des comportements rand() spécifiques à certaines bases de données peuvent créer des motifs répétitifs qui faussent les résultats. Définissez la graine (seed) délibérément, utilisez une implémentation éprouvée et validez la distribution échantillonnée au lieu de supposer que la fonction convient par défaut.
Les entrées corrélées constituent une erreur de modélisation plus grave. Si la latence en amont et le temps d'attente de l'entrepôt augmentent simultanément en période de forte charge, les échantillonner de manière indépendante donnera l'illusion d'une situation plus stable qu'elle ne l'est en réalité. Utilisez des échantillons historiques conjoints, un modèle de dépendance ou une copule lorsque cette relation est significative.
La convergence nécessite des preuves
Une moyenne mobile qui semble plate ne prouve pas que les extrémités de la distribution (tails) se sont stabilisées. Suivez les indicateurs statistiques qui guident la décision, analysez les graphiques de suivi (trace plots) et comparez les résultats sur des lots indépendants. Pour les modèles utilisant un échantillonnage itératif formel, les diagnostics de Gelman-Rubin peuvent aider à évaluer si les chaînes se sont correctement mélangées, bien qu'ils ne corrigent pas un modèle mal spécifié.
Les quantiles extrêmes exigent une attention particulière. Si votre alerte dépend d'un seuil rare, un centre de distribution apparemment lisse peut coexister avec une extrémité instable. Augmentez l'effort de simulation, utilisez des méthodes de réduction de la variance si nécessaire et indiquez l'incertitude autour du percentile estimé.
Ajustez les distributions avec soin : Utilisez un historique pertinent, segmentez les conditions opérationnelles différentes et documentez les hypothèses d'experts.
Contrôlez la reproductibilité : Enregistrez la graine (seed), les détails du générateur, la version du modèle et les paramètres d'entrée pour chaque exécution.
Validez de manière indépendante : Comparez les modèles simples avec des résultats analytiques ou des cas de test connus avant de faire confiance aux résultats de production.
Testez les dépendances : Mesurez les relations entre les entrées et préservez-les lors de l'échantillonnage.
Conservez les métadonnées d'audit : Enregistrez ensemble les paramètres d'itération, les choix de distribution, les versions de code et les résultats de synthèse.
Ne traitez jamais la moyenne comme la vérité absolue. Un résultat de Monte-Carlo est tributaire du modèle, des données et du processus d'échantillonnage. Multiplier les itérations peut rendre un modèle erroné plus précis, mais pas plus juste.
Mettre en œuvre Monte-Carlo dans une plateforme de données d'entreprise
En production, la simulation de Monte-Carlo doit s'intégrer dans le parcours d'exécution normal de la plateforme, et non rester isolée dans un notebook abandonné. Planifiez les simulations aux côtés des traitements ETL, gérez les versions de leurs paramètres et enregistrez les synthèses obtenues en tant que métriques de supervision. Un modèle qui ne peut être réexécuté et expliqué n'est pas prêt pour un système d'alerte d'entreprise.
Une conception opérationnelle pratique
Maintenez des frontières de services légères. L'ingestion doit fournir les observations historiques, le module de simulation doit échantillonner et calculer, et la couche d'alerte doit évaluer les seuils et notifier les propriétaires. Cette séparation permet aux ingénieurs de modifier le modèle sans devoir réécrire l'ensemble des systèmes en aval.
Privilégiez une exécution en base de données pour les contrôles à haut volume tels que le nombre de lignes par partition, les distributions de taux de valeurs nulles et les enveloppes de fraîcheur (Timeliness). Utilisez Python ou R pour les modèles dépendants du chemin, les workflows de bootstrap ou les simulations nécessitant des bibliothèques statistiques spécialisées. La bonne approche est généralement dictée par les mouvements de données et la complexité du modèle.
Stockez suffisamment de métadonnées pour pouvoir reproduire chaque décision :
Distribution d'entrée : Enregistrez la méthode d'ajustement, les paramètres, la fenêtre source et la logique de segmentation.
Configuration de la simulation : Conservez le nombre d'échantillons, le générateur aléatoire, la graine (seed) et la version du modèle.
Synthèses de sortie : Sauvegardez les percentiles, les probabilités des valeurs extrêmes, les moyennes et les diagnostics de convergence.
Contexte de l'alerte : Associez le seuil, la valeur observée, le jeu de données concerné et la réponse du propriétaire.
Preuves d'exécution : Conservez le statut de l'exécution, les horodatages et les détails de l'environnement pour les revues d'audit.
Une plateforme telle que la plateforme de données d'entreprise digna peut fournir le contexte de supervision global pour le comportement des données, la fraîcheur (Timeliness), la validation et les modifications de schéma. Les résultats de la simulation doivent figurer aux côtés des signaux habituels de fraîcheur et de qualité, afin que les équipes puissent comparer le risque prédit avec les incidents réellement observés.
Avant le déploiement, vérifiez que le modèle gère correctement l'absence d'historique, les enregistrements arrivant en retard, les changements de schéma, les tentatives de réexécution et les défaillances partielles de l'entrepôt de données. Exécutez-le ensuite en mode fantôme (shadow mode), comparez les alertes avec le jugement des ingénieurs et n'ajustez les seuils qu'après avoir analysé les faux positifs et les événements manqués.
digna combine la détection d'anomalies de données, la supervision de la fraîcheur (Timeliness), la validation et le suivi des schémas afin que les équipes puissent transformer les signaux probabilistes en actions opérationnelles. Visitez digna pour découvrir comment une Observability enrichie par Monte-Carlo peut s'intégrer dans votre propre environnement de données d'entreprise.


