Datenqualitätsdimensionen für moderne Datenteams erklärt
|
8
min. Lesezeit

Sie können ein Dashboard voller grüner Häkchen haben, eine Pipeline, die pünktlich fertiggestellt wird, und einen wöchentlichen Bericht, der pünktlich in jedem Posteingang landet, und dennoch zusehen, wie das Unternehmen die falsche Entscheidung trifft. Das ist der Teil, den die Leute übersehen, wenn sie Datenqualitätsdimensionen wie eine Compliance-Checkliste anstelle eines Betriebsmodells behandeln. In der Produktion ist der Fehler meist nicht eine offensichtliche Beschädigung. Es ist eine langsame Verschiebung in einer Dimension, vielleicht bei der Timeliness, vielleicht bei der Konsistenz, vielleicht bei der Genauigkeit, die sich an einer breiten Überwachung vorbeischleicht und Entscheidungen vergiftet.
Inhaltsverzeichnis
Wenn gute Daten zu schlechten Entscheidungen führen
Von akademischen Frameworks zur betrieblichen Realität
Warum die Liste kürzer wurde
Die Kerndimensionen und wie man sie misst
Was zuerst gemessen werden sollte
Wo Prüfungen in realen Pipelines scheitern
Warum der Kontext bestimmt, welche Dimensionen am wichtigsten sind
Dimensionen nach Anwendungsfall auswählen, nicht aus Gewohnheit
Operationalisierung von Dimensionen mit kontinuierlicher Überwachung
Wie kontinuierliche Prüfungen in der Praxis funktionieren
Warum die Architektur wichtig ist
Priorisierungs-Framework und Implementierungs-Checkliste
Ein phasenweiser Rollout, der funktioniert
Das Plädoyer für kontinuierliche Überwachung gegenüber periodischen Prüfungen
Wenn gute Daten zu schlechten Entscheidungen führen
Ein Finanzdienstleistungsteam kann seinen Risiko-Dashboards monatelang vertrauen und sich dennoch die Finger verbrennen. Die Zahlen sehen stabil aus, die ETL-Jobs sind erfolgreich und niemand sieht eine fehlerhafte Tabelle. Dann deckt eine Modellprüfung das Problem auf: Die Eingaben drifteten auf eine Weise ab, die das Team nie isoliert hat, sodass sich die Ergebnisse des Modells schon lange vor dem Bemerken verschlechterten.
Das ist die praktische Gefahr eines einzigen Datenqualitätsscores. Ein Datensatz kann vollständig, aber veraltet, gültig, aber inkonsistent oder intern sauber, aber nicht auf das Geschäftsereignis abgestimmt sein, das er darstellen soll. Wenn das Monitoring Ihnen nur sagt, dass die „Qualität in Ordnung ist“, verschleiert es die Frage: Welche Dimension ist fehlgeschlagen und wie?
Viele Teams stellen dies erst fest, nachdem eine Entscheidung schiefgegangen ist. Das Problem ist selten, dass die Daten in jeder Hinsicht unbrauchbar sind. Häufiger hat sich eine Dimension gerade so weit verschoben, dass sie für generische Prüfungen unsichtbar blieb, während sie dennoch das Verhalten nachgelagerter Modelle, Berichte oder Warnungen veränderte.
Praktische Regel: Wenn Ihr Monitoring Ihnen nicht sagen kann, ob das Problem in der Aktualität, im Widerspruch, in der Duplizierung oder im Fehlen von Daten liegt, überwacht es nicht das, was tatsächlich fehlgeschlagen ist.
Deshalb müssen Praktiker Dimensionen getrennt behandeln. Das Unternehmen erfährt „Datenqualität“ nicht als abstrakten Score, sondern in Form von verspäteten Feeds, duplizierten Entitäten, fehlenden Feldern, widersprüchlichen Systemen und Werten, die nicht mehr der Realität entsprechen. Ein nützliches Betriebsmodell beginnt damit, die genaue Dimension zu finden, die sich geändert hat, und dann zurückzuverfolgen, wie diese Änderung eine Entscheidung beeinflusst hat.
Für eine verwandte Perspektive darauf, wie sich schlechte Datenqualität in Geschäftsergebnissen niederschlägt, siehe dignas Diskussion über die Auswirkungen schlechter Datenqualität auf Geschäftsentscheidungen.
Von akademischen Frameworks zur betrieblichen Realität
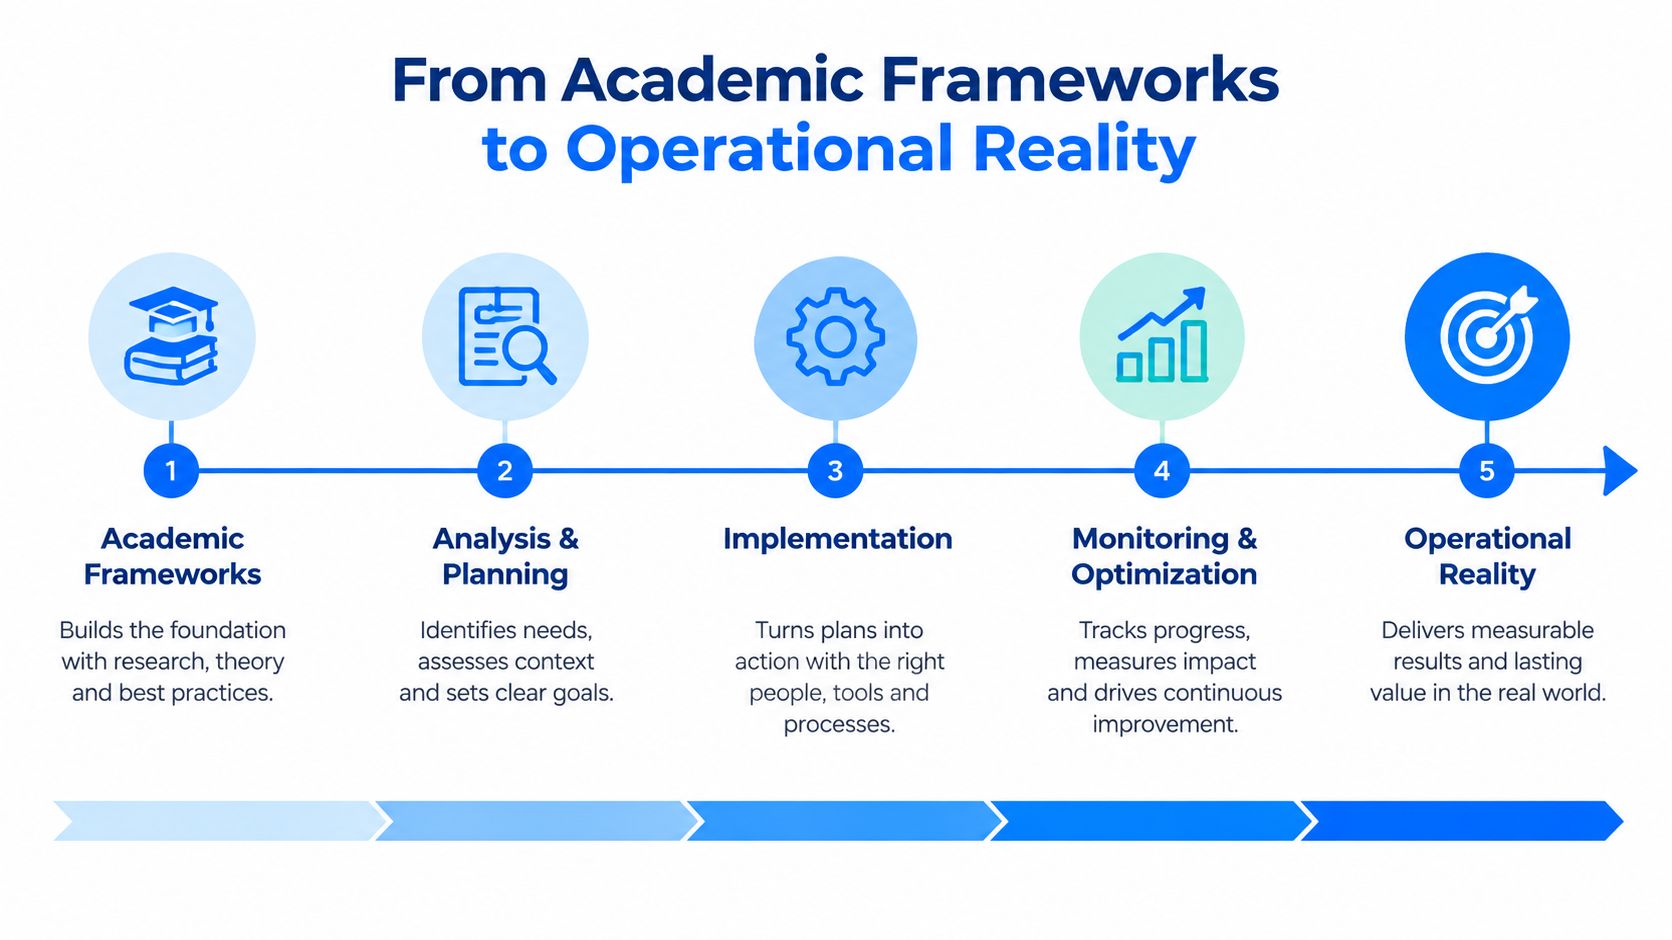
Ein praktisches Datenqualitätsprogramm beginnt meist mit einer unordentlichen Realität, nicht mit einer ordentlichen Taxonomie. Die Historie hinter modernen Frameworks geht auf die 1990er Jahre zurück, als Forscher 15 Dimensionen der Datenqualität in intrinsische, kontextuelle, repräsentative und zugänglichkeitsbezogene Kategorien einteilten. Dies erweiterte die Diskussion über die Genauigkeit hinaus und half bei der Gestaltung späterer Standards wie ISO 8000, wie in der Literatur beschrieben. Die Geschichte ist wichtig, weil sie erklärt, warum Teams immer noch ein fragmentiertes Set von Definitionen, Kontrollen und Eigentumsmodellen erben.
Warum die list got shorter
Die meisten Organisationen können nicht alle 15 Merkmale auf einmal operationalisieren. Sie benötigen Dimensionen, die sie messen, alarmieren und einem Verantwortlichen zuweisen können. Die sechs Kerndimensionen von IBM – Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit – spiegeln diesen Wandel hin zu Kontrollen wider, die Teams ausführen können. Für eine breitere governance-Historie ist DAMA-DMBOK oft der Bezugspunkt, den Praktiker nutzen, wenn sie Konzepte mit der Betriebspraxis verbinden müssen.
Derselbe Druck zeigt sich auch in anderen Frameworks. Statistics Canada verwendet ein handlicheres Set mit Relevanz, Genauigkeit, Timeliness, Zugänglichkeit, Interpretierbarkeit und Kohärenz, was zeigt, wie Organisationen das Modell vereinfachen, wenn das Ziel die tägliche governance und nicht die akademische Abdeckung ist.
ISO/IEC 25012 drängt das Modell in Richtung Implementierung, indem es Qualität als ein multidimensionales Modell mit 15 übergeordneten Merkmalen behandelt, aufgeteilt in inhärente und systemabhängige Gruppen, wie in der Standardzusammenfassung festgehalten. Diese Trennung ist in der Produktion wichtig, da die Daten einwandfrei sein können, während die Pipeline, das Schema oder die Schnittstelle sie fehlerhaft aussehen lassen. ISO 8000-8 unterteilt die Arbeit dann in syntaktische, semantische und pragmatische Qualität, wie in der Literatur beschrieben. Dies ist die Art von Aufteilung, die Ingenieure in Prüfungen, Ausnahmen und Eskalationspfade umsetzen können.
Die praktische Lektion ist direkt. Akademische Taxonomien definieren den Raum. Betriebliche Frameworks sagen Teams, was sie prüfen müssen, wo sie es prüfen müssen und wie sie eine Fehlerart von einer anderen unterscheiden.
Standards helfen am meisten, wenn sie Kompromisse offenlegen. Wenn Sie nicht sagen können, ob das Problem semantisch, syntaktisch oder pragmatisch ist, können Sie meistens auch nicht die richtige Kontrolle entwerfen.
Die Kerndimensionen und wie man sie misst
Das Sechs-Dimensionen-Modell ist ein praktischer Ausgangspunkt, weil es Teams eine gemeinsame Sprache bietet, nicht weil es jeden Einzelfall abdeckt. In der Produktion benötigt jede Dimension eine Metrik, eine Erkennungsmethode und ein Fehlermuster, das auftaucht, bevor Benutzer es bemerken. Das Ziel ist es, die Art von Fehlern abzufangen, die das Verhalten nachgelagert verändern. Für eine gezielte Anleitung zu einer Dimension ist dignas Leitfaden wie man die Datengenauigkeit misst ein nützlicher Begleiter.
Dimension | Wichtige Metriken | Erkennungsmethoden | Häufige Fehlerbilder |
|---|---|---|---|
Genauigkeit | Abweichung von der Single Source of Truth, Drift von Referenzwerten | Gegenprüfung mit autoritativen Systemen, Stichproben-Audits, Drift-Vergleiche | Werte entsprechen nicht mehr der Realität, Modelleingaben veralten unbemerkt |
Vollständigkeit | Null-Rate, fehlende erforderliche Datensätze, unvollständige Datensätze | Prüfung auf Vorhandensein auf Feld-Ebene, Abgleich der Zeilenanzahl, Validierung von Pflichtfeldern | Fehlende IDs, leere Attribute, nur teilweise geschriebene Datensätze |
Konsistenz | Widerspruchsrate zwischen Systemen, Anzahl von Abweichungen | Systemübergreifende Vergleiche, Abgleich von Entitäten, regelbasierte Widerspruchsprüfungen | Dieselbe Entität hat an verschiedenen Stellen unterschiedliche Werte |
Timeliness | Verzögerung zwischen Referenzzeitraum und Verfügbarkeit, Rate verspäteter Lieferungen | Überwachung der Eingangszeit, SLA-Prüfungen, Schätzungen der erwarteten Lieferung | Datenladungen kommen zu spät an, Dashboards spiegeln den falschen Zeitraum wider |
Gültigkeit | Regelfehlerrate, Werte außerhalb des Bereichs, Formatverletzungen | Durchsetzung von Geschäftsregeln, Schema-Constraints, Regex- und Domain-Prüfungen | Ungültige Codes, unmögliche Werte, fehlerhafte Felder |
Eindeutigkeit | Duplikatsrate, Anzahl wiederholter Schlüssel | Deduplizierungslogik, Scans auf Schlüsselkollisionen, Fuzzy-Matching für Fast-Duplikate | Doppelte Kunden, wiederholte Transaktionen, künstlich erhöhte Summen |
Was zuerst gemessen werden sollte
Genauigkeit beginnt mit einer vertrauenswürdigen Referenz. Vergleichen Sie Werte mit dieser Referenz und achten Sie auf Abweichungen im Laufe der Zeit. Ein Datensatz kann Schema-Prüfungen bestehen und trotzdem falsch sein. Daher muss die Kontrolle die Daten mit etwas außerhalb des Datensatzes vergleichen. Für Teams, die diese Kontrolle definieren möchten, beschreibt wie man die Datengenauigkeit misst die Mechanismen sehr klar.
Vollständigkeit ist in der Regel die am einfachsten frühzeitig in der Produktion umzusetzende Dimension. Verfolgen Sie Null-Raten, fehlende erforderliche Zeilen und unvollständige Datensätze nach Feld und Quelle. Das Fehlerbild ist simpel: Eine Pipeline leitet Zeilen weiter, aber ein wichtiges Attribut wird nie gefüllt, was später Analysen und Berichte unbrauchbar macht.
Konsistenz erfordert systemübergreifendes Denken. Zwei Systeme können für sich genommen gut aussehen und sich dennoch über dieselbe Entität uneins sein. Dieser Widerspruch beeinträchtigt den Abgleich, insbesondere wenn nachgelagerte Teams davon ausgehen, dass es nur eine Single Source of Truth gibt.
Wo Prüfungen in realen Pipelines scheitern
Bei Timeliness geht es um Verzögerungen, nicht um ein vages Label zur Aktualität. Die Richtlinie der Regierung von Victoria definiert sie als die Verzögerung zwischen dem Referenzzeitraum und der Veröffentlichung von Informationen, was sie zu einem konkreten operativen Maß anstelle eines Slogans für Datenaktualität macht. Das Framework der britischen Regierung behandelt Timeliness ebenfalls als Daten, die den Zeitraum widerspiegeln, den sie darstellen, und aktuell bleiben, innerhalb des offiziellen Modells.
Bei der Gültigkeit sind Geschäftsregeln angesiedelt. Prüfen Sie zulässige Bereiche, genaue Wertelisten, Formate und Schwellenwerte, da ungültige Datensätze oft harmlos aussehen, bis ein nachgelagerter Prozess sie ablehnt oder – schlimmer noch – akzeptiert.
Bei der Eindeutigkeit geht es um die Duplikatkontrolle. Sie bedeutet, dass keine Duplikate in den Datensätzen für dieselbe Entität vorhanden sind, wie das Framework der britischen Regierung im selben offiziellen Modell festlegt. In operativer Hinsicht blähen doppelte Datensätze das Volumen auf, führen zu Doppelzählungen von Kunden oder machen einen nachgelagerten Join unbrauchbar.
Integrität und Provenienz sind ebenfalls wichtig. Integrität schützt die Beziehungen zwischen Datensätzen und Tabellen. Provenienz zeigt, woher ein Wert stammt und wie er sich verändert hat. Sie stehen bei einer Qualitätsprüfung selten an erster Stelle, entscheiden aber oft darüber, ob ein Fehler schnell behoben wird oder in eine forensische Suche ausartet.
Warum der Kontext bestimmt, welche Dimensionen am wichtigsten sind
Nicht jeder Workload benötigt die gleiche Gewichtung der Dimensionen. Ein Finanzteam, ein klinisches Team und ein E-Commerce-Team können alle dasselbe Data Warehouse nutzen und sich dennoch um unterschiedliche Fehlerbilder sorgen. Der Fehler besteht darin, anzunehmen, dass jede Dimension überall das gleiche Gewicht verdient.
Im Finanzbereich stehen Genauigkeit und Konsistenz meist an der Spitze, da regulatorische Berichte, Risikoberechnungen und Abstimmungen darauf angewiesen sind, dass die Werte systemübergreifend übereinstimmen. Ein Datensatz, der vollständig, aber widersprüchlich ist, bleibt ein Problem. Im Gesundheitswesen kann Timeliness im Moment wichtiger sein, da ein verzögerter Feed weniger nützlich sein kann als ein leicht unvollkommener, insbesondere wenn operative Entscheidungen vom neuesten verfügbaren Status abhängen.
Der E-Commerce priorisiert oft Vollständigkeit und Gültigkeit. Ein Produktkatalog mit fehlenden Attributen oder ungültigen Kategorien kann die Suche, Filter und die Logistiklogik beeinträchtigen, selbst wenn die meisten Datensätze gut aussehen. IoT- und ereignisgesteuerte Systeme verlassen sich meist stark auf Timeliness und Genauigkeit, da veraltete Telemetriedaten ein Echtzeit-Entscheidungssystem zu spät oder auf den falschen Zustand reagieren lassen können.
Dimensionen nach Anwendungsfall auswählen, nicht aus Gewohnheit
Eine aktuelle Umfrage argumentiert, dass Datenqualitätsdimensionen kontextabhängig sind und in Praktiken entfaltet werden sollten, anstatt als statische Checkliste von Labels behandelt zu werden. Das deckt sich mit dem, worauf Teams in der Produktion stoßen. Derselbe Datensatz kann für das monatliche Finanzcontrolling „gut genug“ sein, für ein tagesaktuelles operatives Dashboard jedoch nicht.
Die operative Frage lautet immer: Was geht zuerst kaputt, wenn sich diese Dimension verschlechtert? Wenn ein fehlendes Feld nur eine geringfügige Anreicherung betrifft, kann es warten. Wenn ein veralteter Feed eine klinische oder Handelsentscheidung beeinflusst, rückt er an die Spitze der Warteschlange.
Operative Erkenntnis: Priorisieren Sie die Dimension, die die Entscheidung verändert, nicht die, die am einfachsten zu messen ist.
Dieser Ansatz hilft Teams, die typische Falle zu vermeiden, einen Bereich mit geringem Risiko übermäßig zu optimieren, während sie einen Bereich mit hohem Risiko übersehen. Er erklärt auch, warum statische Scorecards in regulierten Umgebungen versagen. Eine Scorecard sieht vielleicht sauber aus, während dem tatsächlichen Anwendungsfall immer noch die Aktualität, die Widerspruchsprüfungen oder die Validierungsregeln fehlen, die er benötigt.
Der praktische Schritt besteht darin, jeden Datensatz seinen tatsächlichen Nutzern zuzuordnen und dann aufzuschreiben, von welchen Dimensionen diese Nutzer abhängen. Sobald das klar ist, wird das Monitoring-Design viel einfacher.
Operationalisierung von Dimensionen mit kontinuierlicher Überwachung
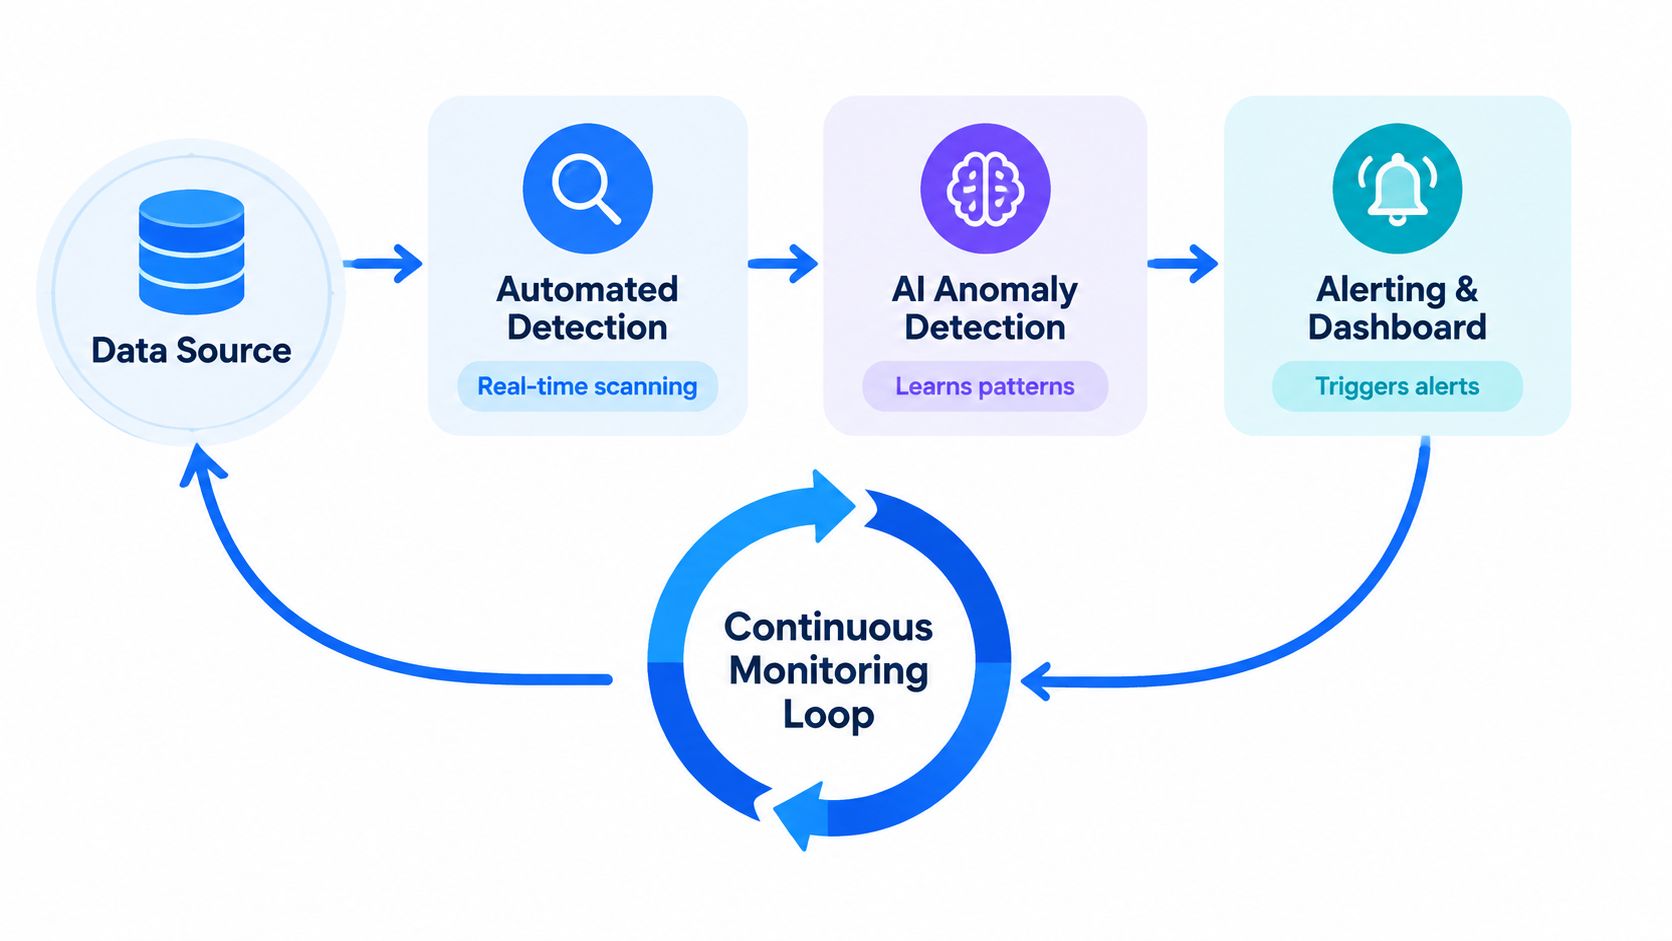
Kontinuierliche Überwachung ist der Punkt, an dem die Theorie nutzbar wird. Anstatt auf eine wöchentliche Überprüfung zu warten, beobachten moderne Plattformen die Daten selbst, lernen normale Muster und melden Abweichungen, sobald sie auftreten. Das ist wichtig, da die meisten Qualitätsfehler nicht als offensichtliche Brüche auftreten, sondern als subtile Abweichungen.
Der modulare Aufbau von digna spiegelt diese Realität wider. Data Anomalies deckt das KI-gestützte Erlernen von Baselines für Verschiebungen bei Genauigkeit und Konsistenz ab, Timeliness verfolgt erwartete Eingangsmuster und Lieferverzögerungen, Data Validation setzt regelbasierte Prüfungen auf Gültigkeit und Vollständigkeit durch, und der Schema Tracker überwacht strukturelle Änderungen, die nachgelagerte Verbraucher beeinträchtigen können. Die Prüfungen laufen datenbankintern, sodass die Daten an Ort und Stelle bleiben, während die Plattform Metriken berechnet und Probleme in der Kundenumgebung erkennt.
Wie kontinuierliche Prüfungen in der Praxis funktionieren
Das Erlernen einer Baseline ist nützlich, da nicht jede Anomalie eine einfache Schwellenwertüberschreitung ist. Eine Tabelle weist am ersten Werktag des Monats möglicherweise immer Spitzenwerte auf, sodass eine feste Regel Fehlalarme erzeugen würde. Durch das Erlernen der Baseline erkennt das System, wie der Normalzustand für diesen Datensatz aussieht, und meldet eine Abweichung, wenn sich das Muster verschiebt.
Die Überwachung der Timeliness sollte mehr tun, als verspätete Ladungen im Nachhinein zu markieren. Sie muss die erwartete Frequenz lernen, sie mit den tatsächlichen Eingängen vergleichen und fehlende Ladungen oder vorzeitige Lieferungen identifizieren, bevor nachgelagerte Jobs veraltete Daten verarbeiten. Das ist der Unterschied zwischen der Fehlersuche in einer Post-Mortem-Analyse und dem Abfangen des Problems, solange noch Zeit ist, eine Pipeline umzuleiten.
Das Schema-Tracking schließt eine weitere häufige Lücke. Strukturänderungen, hinzugefügte Spalten, entfernte Spalten und Typänderungen können nachgelagerte Prozesse stören, selbst wenn die Zeilenanzahl gesund aussieht. Dem Verbraucher ist es egal, ob die Quelltabelle noch existiert, wenn sich die Struktur darunter geändert hat.
Warum die Architektur wichtig ist
Manuelle Prüfungen lassen sich nicht gut skalieren, sobald Teams viele Datensätze und viele Regeln verwalten. Kontinuierliche Automatisierung verringert den Aufwand, alles manuell zu überprüfen, und hilft, echte Anomalien von routinemäßigen Schwankungen zu trennen. Das reduziert die Alarmmüdigkeit, die meistens überhaupt erst zum Scheitern von Monitoring-Programmen führt.
Eine Plattform muss auch die Behebung unterstützen, nicht nur die Erkennung. Ingenieure benötigen Vorfälle, Trends und genügend Kontext, um zu entscheiden, ob sie die Quelle korrigieren, eine Regel anpassen oder die neue Baseline akzeptieren. Ohne diese Feedbackschleife wird das Monitoring zu einem Strom von Alarmen ohne Handlungspfad.
Priorisierungs-Framework und Implementierungs-Checkliste
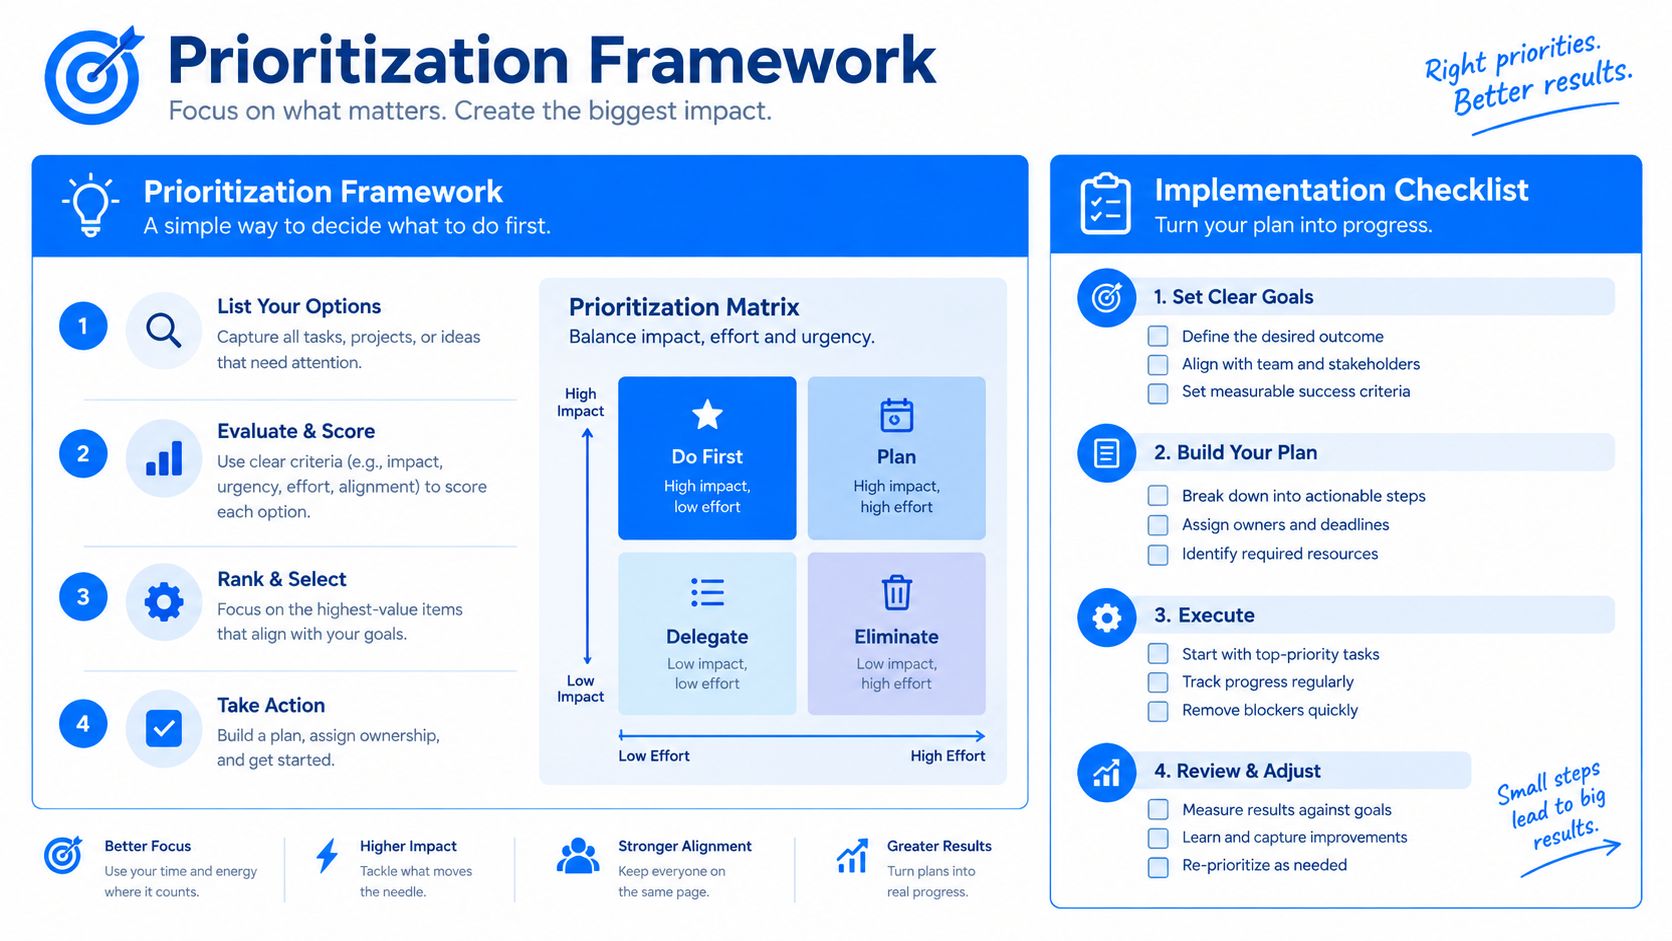
Beginnen Sie mit den Datensätzen, die Ihnen am meisten schaden können. Das bedeutet in der Regel Finanz-Feeds, operative Fakten-Tabellen, Kundenstammdaten, regulierte Berichtsdaten oder alles, was in Management-Dashboards einfließt. Ein Datensatz mit geringem Wert kann warten. Ein kritischer nicht.
Ein phasenweiser Rollout, der funktioniert
Phase 1: Die offensichtlichen Lücken schließen. Timeliness und Vollständigkeit sind meist die schnellsten Erfolge, da sie einfacher zu definieren, einfacher zu prüfen und Stakeholdern einfacher zu erklären sind. Wenn ein Feed zu spät ankommt oder ein Pflichtfeld fehlt, erkennen viele Teams die Auswirkungen schnell.
Phase 2: Widerspruchs- und Regelprüfungen hinzufügen. Sobald die Grundlagen unter Kontrolle sind, gehen Sie zu Konsistenz und Gültigkeit über. Hier fangen systemübergreifende Widersprüche, ungültige Codes und schlechte Geschäftsregel-Kombinationen an, sichtbar zu werden.
Phase 3: Genauigkeit und Eindeutigkeit verschärfen. Diese erfordern in der Regel bessere Baselines, bessere Referenzdaten und ausgereiftere Behebungsprozesse. Sie sind mit einer einzigen Regel schwerer zu erfassen, sind aber sehr wichtig, sobald das Volumen und die geschäftlichen Auswirkungen hoch sind.
Eine nützliche Checkliste für jede Phase ist einfach:
Definieren Sie die Metrik klar. Wenn das Team nicht erklären kann, was sich geändert hat, ist die Metrik nicht bereit.
Etablieren Sie eine Baseline. Ohne normales Verhalten sieht jeder Alarm verdächtig aus.
Legen Sie Alarmschwellenwerte fest. Schwellenwerte sollten das geschäftliche Risiko widerspiegeln, nicht nur die technische Ästhetik.
Dokumentieren Sie den Behebungspfad. Jemand muss wissen, wer den Fehler wo und wie schnell behebt.
Eine modulare Plattform hilft, da Sie nicht jede Funktion am ersten Tag installieren müssen. Sie können mit einer Tabelle, einem Modul und einer Fehlerklasse beginnen und die Abdeckung erweitern, wenn die Organisation Vertrauen gewinnt und der Umfang klarer wird. Dieser Ansatz ist weitaus nachhaltiger, als von Anfang an zu versuchen, jede Dimension überall zu überwachen.
Das Plädoyer für kontinuierliche Überwachung gegenüber periodischen Prüfungen
Periodische Prüfungen waren sinnvoll, als Pipelines langsamer und die Anzahl kritischer Datensätze überschaubar war. Sie versagen, sobald sich Daten kontinuierlich bewegen, Verbraucher von frischen Feeds abhängen und die Kosten einer späten Entdeckung hoch sind. Bis ein geplanter Bericht ein Problem aufzeigt, ist der Schaden oft schon in Entscheidungen eingeflossen.
Kontinuierliche Überwachung verändert die Frequenz. Sie erkennt Abweichungen, während sich die Daten noch bewegen, und nicht erst, nachdem sie bereits eine Analyse beeinflusst oder eine Aktion ausgelöst haben. Das ist besonders wichtig, da Qualitätsprobleme oft klein beginnen und sich dann über Joins, Aggregate, Modelle und Dashboards ausbreiten.
Hier ist auch die Skalierbarkeit wichtig. Teams, die viele Regeln, viele Quellen und viele nachgelagerte Verbraucher verwalten, können mit der manuellen Überprüfung nicht Schritt halten. Die Automatisierung übernimmt die Wiederholungen, und das KI-gestützte Erlernen von Baselines hilft, Rauschen zu reduzieren, indem verstanden wird, wie der Normalzustand für jeden Datensatz aussieht, anstatt jede Schwankung als Fehler zu behandeln.
Der andere Vorteil ist die Reaktionszeit. Wenn eine Verzögerung, ein Widerspruch oder eine Schemaänderung frühzeitig erkannt wird, kann das Team die Quelle reparieren, einen nachgelagerten Job anhalten oder den Prozess umleiten, bevor Benutzer mit schlechten Ergebnissen arbeiten. Das ist viel schwieriger, wenn der erste Alarm erst bei einer wöchentlichen Überprüfung eingeht.
Bei der kontinuierlichen Überwachung geht es nicht darum, menschliches Urteilsvermögen zu ersetzen. Es geht darum, Ingenieuren zur richtigen Zeit genügend Signale zu geben, um zu handeln, bevor das Unternehmen den Fehler spürt.
Wenn Sie ein Datenqualitätsprogramm aufbauen oder verschärfen, beginnen Sie mit den Datensätzen, die das größte geschäftliche Risiko bergen, und überwachen Sie die Dimensionen, die Entscheidungen verändern. digna bietet Teams eine modulare Überwachung von Anomalien, Timeliness, Validierung und Schemaänderungen innerhalb ihrer eigenen Umgebung, sodass die Prüfungen nah an den Daten bleiben und der Behebungspfad praktisch bleibt. Besuchen Sie digna, um zu sehen, wie dieser Ansatz in Ihren Stack passt und wo Sie am besten beginnen würden.
Häufig gestellte Fragen
Was sind die zentralen Datenqualitätsdimensionen?
Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Validität und Eindeutigkeit. Jede hat eigene Kennzahlen und Erkennungsmethoden: Genauigkeit wird gegen eine vertrauenswürdige Referenz geprüft, Vollständigkeit über Nullwertquoten und Zeilenabgleich, Konsistenz über systemübergreifende Widerspruchszählungen.
Woher stammen die Dimensionsmodelle?
Forschung der 1990er gruppierte 15 Dimensionen in intrinsische, kontextuelle, repräsentationale und Zugänglichkeitskategorien. ISO/IEC 25012 behält 15 übergeordnete Merkmale in inhärenten und systemabhängigen Gruppen, während ISO 8000-8 die Arbeit auf syntaktische, semantische und pragmatische Qualität verengt.
Warum ist ein einzelner Qualitätswert ein Problem?
Weil er verbirgt, welcher Fehler tatsächlich aufgetreten ist. Wenn Ihr Monitoring nicht sagen kann, ob es um Aktualität, Widerspruch, Dubletten oder Fehlwerte geht, überwacht es nicht das, was versagt hat, und Teams merken das meist erst nach einer falschen Entscheidung.
Welche Dimensionen sollte ein Team priorisieren?
Das hängt vom Konsumenten ab, nicht von Gewohnheit. Finanzdienstleister stellen meist Genauigkeit und Konsistenz voran, weil aufsichtsrechtliches Reporting und Abstimmungen auf systemübergreifend passenden Werten beruhen, während E-Commerce oft Vollständigkeit und Validität priorisiert. Fragen Sie, was zuerst bricht, wenn diese Dimension nachlässt.
Wie führt man das Dimensions-Monitoring ein?
In drei Phasen: zuerst die offensichtlichen Lücken, dann Widerspruchs- und Regelprüfungen, danach Genauigkeit und Eindeutigkeit schärfen. Definieren Sie je Phase die Kennzahl klar, etablieren Sie eine Baseline, setzen Sie Alert-Schwellen und dokumentieren Sie den Behebungsweg, bevor Sie weitergehen.


